TinyFish 于 2026 年 5 月 4 日宣布将其 Search 和 Fetch API 基础价格调整为 $0.00/次,同时无需绑定信用卡与月度订阅。这项直奔底层数据接口的价格动作,意在正面对撼由 Tavily、Exa 和 Firecrawl 占据的 AI 检索基础设施市场。
表面上看,这是一场针对开发者钱包的补贴突袭;但将网络数据塞进大语言模型的全链路账单拆开后就会发现,API 调用费只是冰山一角。决定一个自主智能体调用成本的决定性因素,始终是数据回传给模型时消耗的 Token 用量。免费提供的数据一旦掺杂过多冗余噪声,反倒会将开发者的预算拖入更昂贵的模型推理泥潭。
检索市场的账目倒挂:上游免费,下游买单
AI Agent 在自动化调研、代码修复和复杂决策时,必须跳过人工阅读的浏览器界面,直接将外部知识灌入大语言模型。传统搜索引擎返回的超文本标记混杂着广告追踪码与格式噪音,直接注入上下文窗口会成倍消耗推理算力。
这一痛点催生了一众专门面向模型清洗网页的供应商。行业成熟服务商的收费并不低廉:Tavily 的按量搜索接口定价为每千次 $8(Basic)至 $16(Advanced);Exa 则按每千次 $4(Instant)至 $7(Fast/Auto) 计费;Firecrawl 则采用积分制,每 10 条检索结果划扣 2 个积分,单页爬取扣除 1 个积分。
当 TinyFish 亮出基础费率完全归零的招牌时,看似抹平了开发者的采买门槛,但在大模型输入单价普遍维持在每百万 Token 约 $3 的背景下,检索回传结果的精简程度直接决定了下游账单的厚薄。
精简上下文省下的推理费,远比免掉的接口费更具杀伤力。
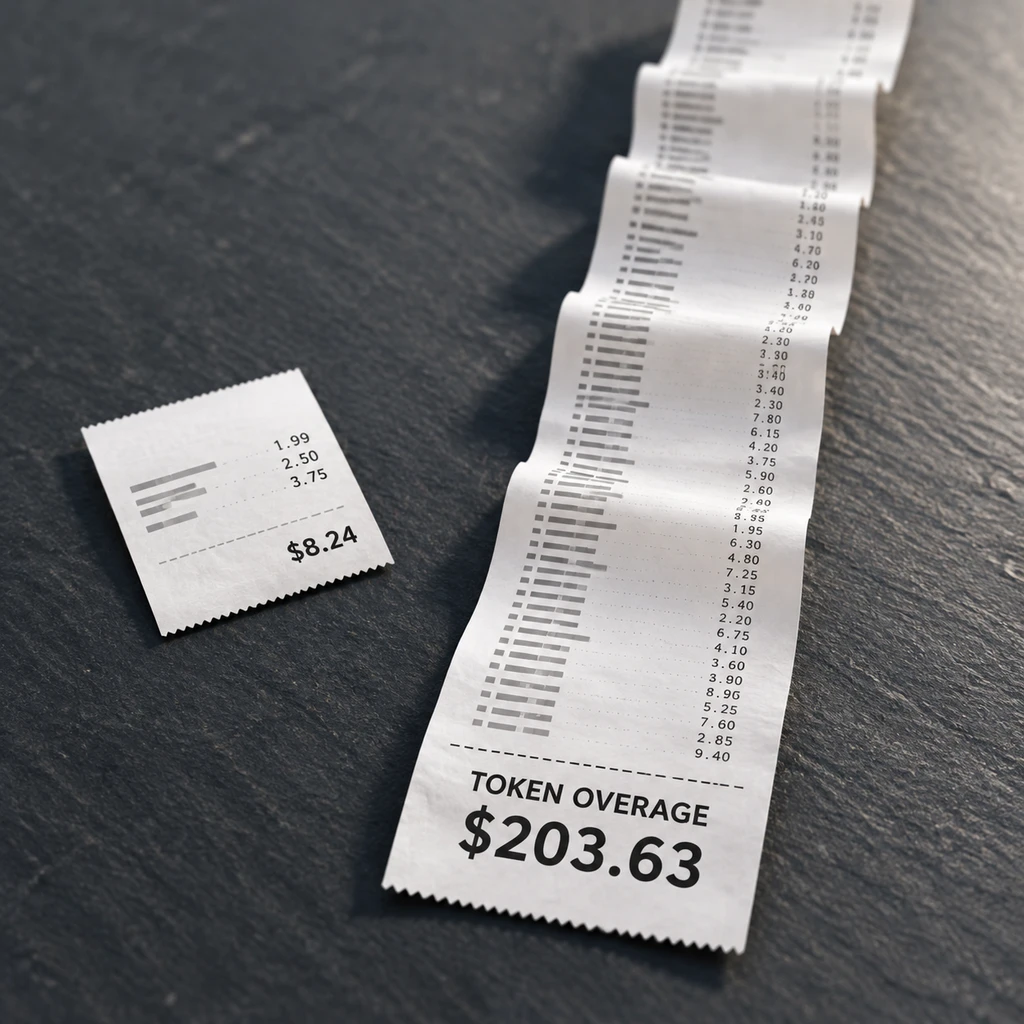
2026 年 8 月的 FreshQA 基准测试清晰地勾勒出这种反差:Tavily Basic 平均单次返回 3,166 个 Token,准确率 88%,折算下游推理后的千次综合成本为 $17.50;Exa 的 Highlights 模式单次抓取 6,952 个 Token,千次综合成本 $27.86,换来 92% 的准确率。然而,一旦开启 Exa 的全文读取模式,单次抓取产生的 Token 会飙升至 65,543 个,直接推高千次综合成本至 $203.63。
这意味着,上下文每被无用信息稀释 16,000 个 Token,开发者调用一千次就得多给模型厂商支付约 $48 的推理成本。一个虽然收费但能清洗提炼核心语义的接口,在综合核算下反而比盲目灌入粗糙网页的免费服务更加划算。
效率评测分水岭:文档提取与独立搜索的性能错位
剥离商业宣传后,TinyFish 的实际性能在不同工作流中呈现出明显的分化。
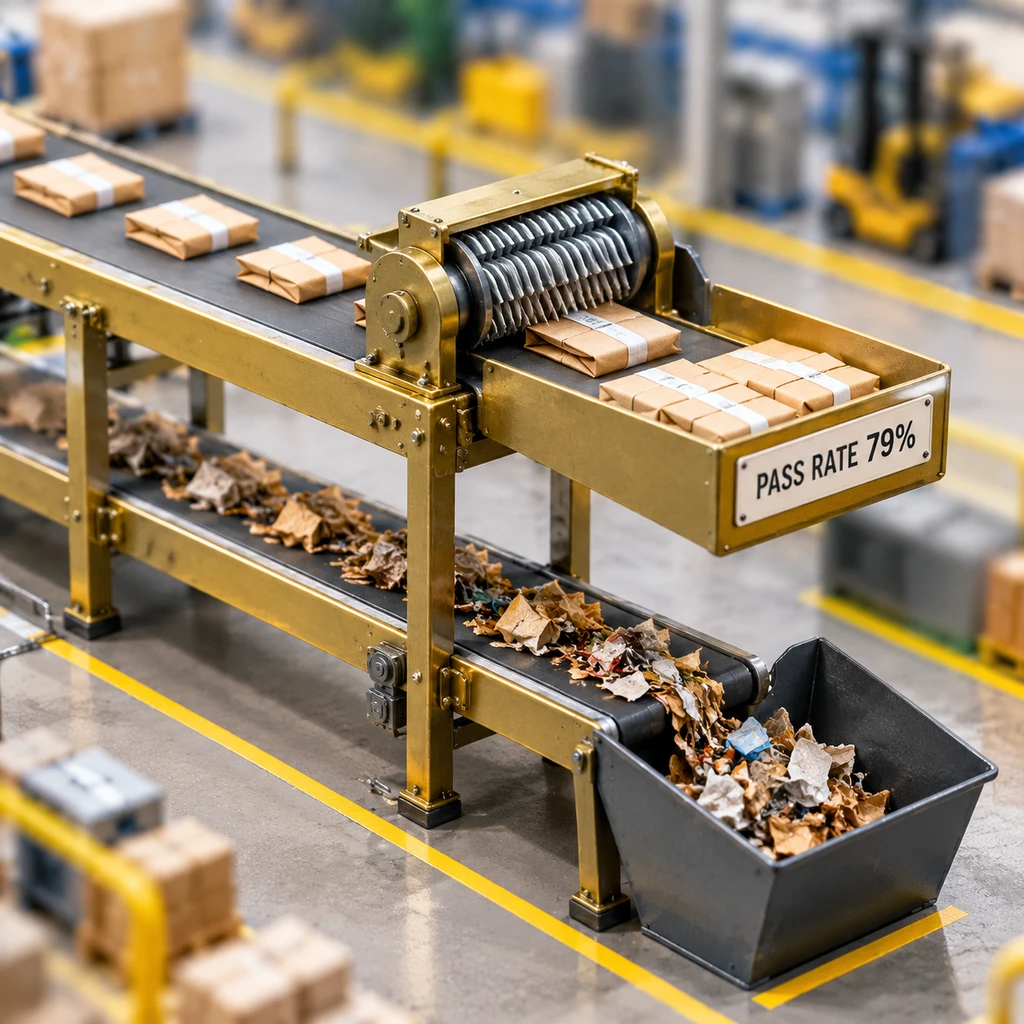
在结合 Search 与 Fetch 的完整管道中,TinyFish 展现出了不错的语义浓缩能力。根据 OpenBenchmarks 面向代码生成 Agent 的评测指标,在该流程下 TinyFish 取得了 79.0% 的任务完成率,中位消耗为 12,844 个 Token,单任务中位成本压低在 $0.050。作为对比,Firecrawl 在同一场景下的完成率为 76.0%,中位 Token 消耗达到 17,379 个,成本为 $0.082;而 Exa deep 模式虽然完成率顶到 83.0%,但中位消耗高达 23,660 个 Token,成本攀升至 $0.130。
但在脱离正文提取、仅依赖搜索引擎本身的 Search-only 测试中,TinyFish 的表现却出现回落:其任务完成率骤降至 59.3%(消耗 7,469 个 Token),明显落后于 Firecrawl 的 70.3%(消耗 7,456 个 Token)。这表明其检索索引本身的语义召回深度仍有局限,必须配合后续的网页清洗提取才能维持整体表现。
| 评测维度与方案 | 任务完成率 | 中位 Token 消耗 | 中位单任务成本 | 场景特征 |
|---|---|---|---|---|
| TinyFish (Search+Fetch) | 79.0% | 12,844 | $0.050 | 适合长文档定向抽取 |
| Firecrawl (Search+Fetch) | 76.0% | 17,379 | $0.082 | 上下文冗余度偏高 |
| Exa deep (Search+Fetch) | 83.0% | 23,660 | $0.130 | 质量上限高但成本昂贵 |
| TinyFish (Search-only) | 59.3% | 7,469 | 基础检索 | 独立搜索准确度存短板 |
| Firecrawl (Search-only) | 70.3% | 7,456 | 基础检索 | 纯检索召回更为稳定 |
在响应速度方面,TinyFish 官方发布的 2026 年 7 月基准声称其 Search p50 延迟仅为 556 毫秒,快于 Exa 的 811 毫秒、Firecrawl 的 869 毫秒以及 Tavily 的 1,109 毫秒,并在 SimpleQA 数据集上录得 86.8% 的可回答率。但这套数据属于官方自测,外部社区在实际生产中反映其样本表现仍有波动,尚未形成大范围共识。
免费招牌下的配额阻断与变现闭环
审视 TinyFish 的官方文档,能明显看出产品宣传与工程落地之间的策略断层。其定价页面极力强调零元费率且绝不扣除钱包余额,但在开发者 API 参考文档的技术细节中,却存在一套硬性的阻断机制。
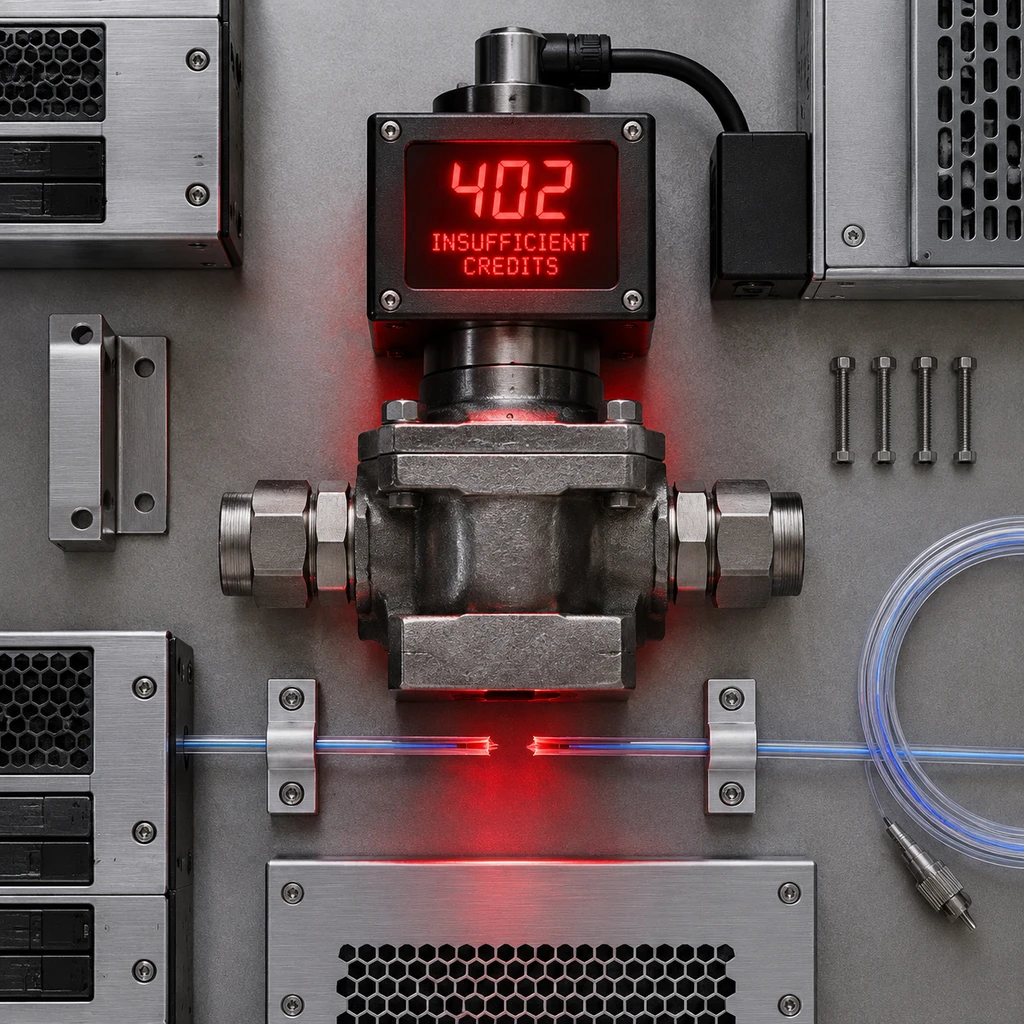
根据文档规则,TinyFish 设定的基础配额为 Search 每分钟 30 次、每小时 500 次,Fetch 每分钟 150 次、每天 1,000 个 URL。API 参考文档中明确指出,Search 每日调用上限为 12,000 次(UTC 00:00 重置)。一旦超出这一每日限额且开发者账户内余额为零或负数,系统将直接抛出 HTTP 402 INSUFFICIENT_CREDITS 报错,而非温和降速。
- 风险.如果开发团队轻信全免费承诺而未在网关层编写 402 与 429 异常重试逻辑,线上高并发任务极易在凌晨配额耗尽时发生突发性阻断。
严格的频次限制清晰地划定了这套免费策略的边界:它面向个人开发者的小型原型开发,但刻意压制了任何未经商务洽谈的中大型并发业务。
这也是云端基础设施经典的漏斗策略。TinyFish 真正押注的变现支点在于其高阶托管服务:其全托管 Agent 运行环境按步计费,定价为 $0.016/步(内置模型推理服务);云浏览器环境则按使用时长收取 $0.002/分钟,并设有 $10 的最低充值门槛。
通过免费的数据接口降低获取开发者的成本,再将高频、复杂的自动化执行导入按步或按时长计费的高利润容器,这是技术工具厂商从售卖单一通道走向售卖执行环境的典型演进路径。
- 建议.原型验证与中低频的抓取管道可以直接接入零元接口削减前期开销,但涉及大批量企业级采集,仍应优先评估 Exa 或 Tavily 的提取信噪比,避免因模型端产生无效 Token 造成总体预算失控。