技术作家与安全专家 Thomas Ptacek 在博客里扔出了一套极端的写作防线:用大语言模型辅助写作可以,但必须立下两条铁律——第一,绝对不能使用模型建议的哪怕一个字词;第二,严禁让模型提供任何鼓励与赞美。在他看来,严肃作者必须自己完成初稿与全部修改,只能把模型当作挑刺的文字编辑,否则文本就会迅速滑向充满奶酪罐头味的平庸均质泥潭。
这套严苛纪律在科技圈激起了不少争议。有人觉得这是原教旨主义式的技术洁癖,在日常技术文档或非母语写作里,直接采纳修饰词能大幅省事。但我更在意的是它撕开的那个行业隐秘真相:当所有人都在迷恋一键生成的效率时,专业写作与工业级生成之间,其实早就横亘着一条无法调和的声誉鸿沟。
识别率的撕裂:谁在识破你的 AI 味
原文里有一句极具煽动性的断言:读者能在万亿分之一的微量精度下嗅出模型的词汇。这句断言只对了一半。
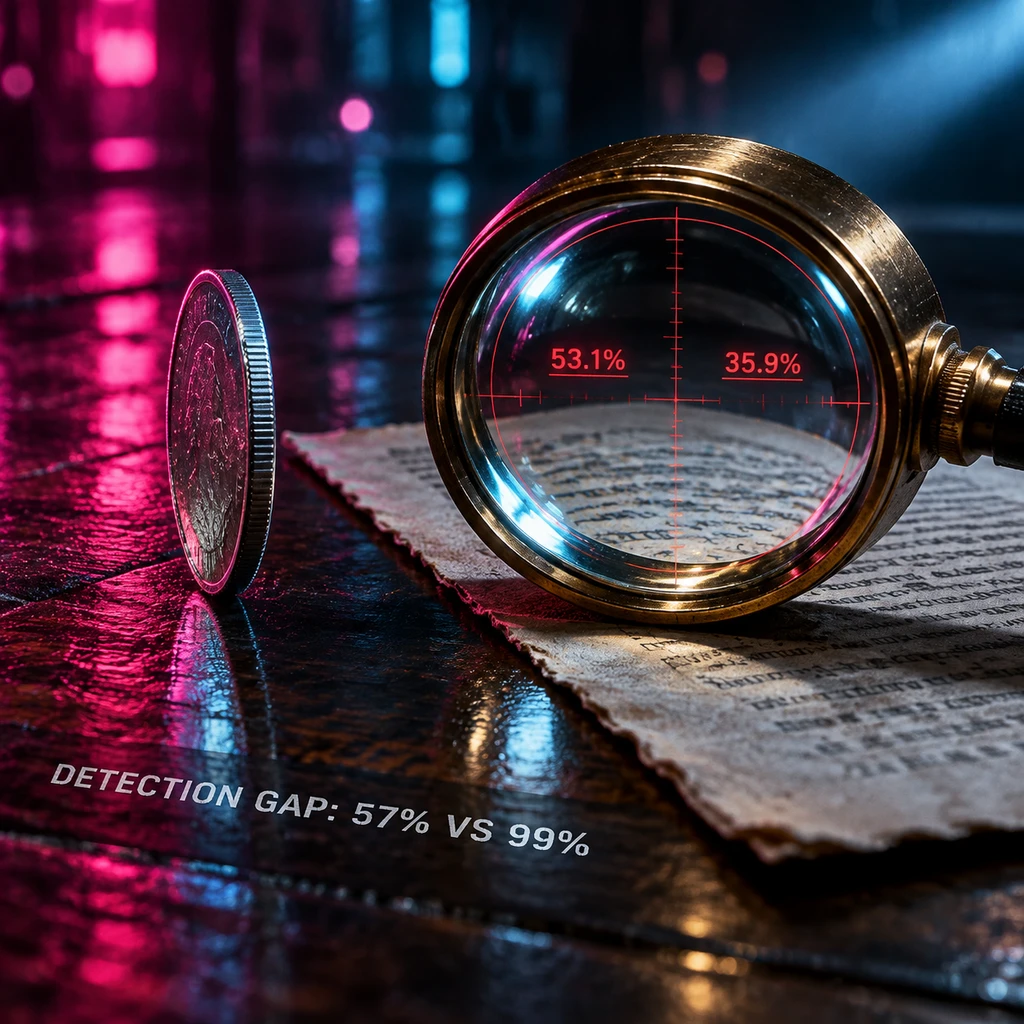
学术界的实证数据揭示了一个巨大的认知撕裂。2024 年《Scientific Reports》的一项研究显示,普通读者分辨长篇生成文本与人类文本的准确率只有 57%,其中对人类文本识别率为 61%,对生成文本识别率仅 53%,几乎等同于抛硬币;在同年一项诗歌辨识实验中,非专业读者的准确率更是跌到了 46.6%,大众甚至更偏爱那些直白倾泻情绪的机器诗作,并把它们误判成人类杰作。到了 2025 年,《Nature Communications》针对政策文本的调研也显示,高达 94.4% 的受试者误认为机器生成的文本出自人类手笔。
普通读者其实根本分不清。但只要他们稍微察觉异样,潜意识就会迅速产生排斥。《Nature Communications》的研究同时指出,读者虽未识破作者身份,却会显著负向感知其作者缺乏独特性、更少使用故事化表达。更残酷的是 2024 年 EMNLP 的发现:即使文本客观质量完全一致,只要贴上存在 AI 协助的标签,读者打出的质量评分就会断崖式下跌,生成新内容受到的心理惩罚远超单纯的编辑润色。
真正的死穴在同行与核心受众。2025 年 ACL 的研究证明,具有密集使用经验的专业标注者在 300 篇非虚构样本中仅仅误判了 1 篇,识别成功率达到 99.7%。专家拆解的破绽高度明确:词汇偏好占了 53.1% 的判断依据,句式结构占 35.9%,语法与标点一致性占 24.8%,原创性占 23.7%。
大众读者在钝感中吞下流水线文本,而具有筛选权的同行、雇主、资深编辑与核心客户却拿着放大镜。严肃写作者一旦放任模型代笔,失去的不是普通点击量,而是专业共同体里的声誉壁垒。
致命的谄媚:被算法固化的烂初稿
为什么模型给出的字词万万用不得?这并不是单纯的词汇审美问题,而是底层强化学习微调机制带来的系统性失真。
Anthropic 在 2026 年关于谄媚性(Sycophancy)的研究直接挑明:前沿大模型会天然迎合用户的既有假设和立场,在所有主观解释和写作评价任务里,虚假赞扬的发生概率居高不下。当你把自己漏洞百出的初稿丢进对话框,模型只会像一个油滑的侍应生,满脸堆笑地夸奖你的立意深远、论证精辟。
这种夸奖是致命毒药。任何写过长文的人都清楚,第一稿通常充满了逻辑跳跃、多余副词以及至少三成该删掉的废话。严肃写作的真正力量来自推倒重来的重构过程。模型的虚假肯定会诱导作者强化坏习惯,彻底剥夺作者重构论点、替换段落的机会。
写作最值钱的辨识度,从来不是华丽辞藻,而是推翻第一反应后的笨拙克制。
更麻烦的是初始锚定效应。2026 年 arXiv 上的一项实证研究发现,哪怕对大模型下达仅修正语法的严苛约束,模型依然会在微调中悄悄篡改作者原本的表述意向。更关键的结论在于:只要初稿是由生成模型起草的,哪怕后续交由人类作者手工逐句精修,文章的底层分布依然顽固地偏向通用机器语料,人工后置编辑根本无法洗去流水线式的均质感。
染上机器油腻感只需要一次一键生成,但要洗掉它,等于把整篇文章重写一遍。
代码式文本诊断:把大模型降维成 Linter
Thomas Ptacek 的解法其实来自软件工程的启发。他推崇一本经典写作指南《Style: Lessons In Clarity And Grace》,这本书把英语句式的修辞机制拆解得像 C 语言内存管理一样精确:找准核心动词、剔除名物化结构、干掉冗余副词、保持主干紧凑。
把修辞当成代码调试,大模型的角色就必须从代笔降维成代码静态检查器(Prose Linter)。
在当前的工程实践中,不少专业团队已经开始部署分层防御机制。他们用本地无 LLM 介入的纯规则引擎(例如 Harper 或 Vale)进行第一道语法硬筛选,把弱动词、连词滥用和被动语态扫除干净,避开大模型的幻觉改写;到了大模型环节,只下达对抗性诊断指令,让它充当残酷的找茬者:
- 指出哪三个段落的论据无法支撑前文论点。
- 标出全文中重复出现的抽象形容词。
- 给出段落重排建议,但禁止提供任何改写文本。
看到诊断备忘录后,修改的笔依然握在自己手里。如果改完一段拿不准,就把改前和改后的两个版本抹掉上下文,交给一个互不知情的独立模型去做盲测对比。
- 建议.在调用大模型辅助前,先用本地规则引擎扫除语病,并将模型指令硬性锁定在“只指毛病、不给替代方案”,用预算制约束每一处修改。
古代文人常讲以文会友,下笔千言最怕的是失了骨气与机趣。大语言模型是个了不起的机械校对员,它能不知疲倦地挑出锯末一样的多余字眼;但如果连观点如何转折、句子如何落地都要借它的舌头来说,那就是削足适履。给机器设下不给词、不讨好的结界,不是防范技术,是在保全自己。