芯片架构传奇人物 Jim Keller 执掌的 AI 芯片初创公司 Tenstorrent 于 2026 年 10 月 19 日宣布完成 15 亿美元 E 轮融资,投后估值达到 62 亿美元。本轮融资由 Trace Capital 与 Innovation X 领投,跟投方汇聚了 ARK Invest、Fidelity、Morgan Stanley、T. Rowe Price、Tether Investments、Cadence Ventures 以及 Sandisk。这一轮巨额注资距离英特尔与高通在 2026 年 5 月开出最高 50 亿美元 估值的收购邀约仅过去五个月。
拒绝巨头招安并选择独立烧钱扩充产线,意味着 Tenstorrent 彻底放弃了依附旧 PC 与移动芯片帝国的退路。这也是对英伟达软硬一体霸权发起的最激进突围。这家曾于 2021 年 5 月 C 轮拿到超 2 亿美元(估值 10 亿美元)、2023 年 8 月获现代与三星 1 亿美元战略投资、并在 2024 年底斩获超 6.93 亿美元 D 轮(投前估值 20 亿美元)的公司,估值在不到两年内翻了三倍。这笔钱的真正买点不是又一颗挑战英伟达的硬件算力怪物,而是 Jim Keller 试图用开源软件栈与 RISC-V 架构撕开 CUDA 铁幕的系统级试验。
架构脱水:专有矩阵核配控制流的工程取舍
外界常将 Tenstorrent 粗暴标签化为一家纯粹的 RISC-V 芯片制造商,认为开源指令集正直接运行现代大语言模型。这在计算机架构设计上是一种误读。Tenstorrent 硬件的实际底层是由专有的 Tensix 核心矩阵组成,真正负责密集张量运算与矢量吞吐的是这些专用加速阵列;嵌入其中的小型 RISC-V 核心主要负责数据搬运、片上网络路由以及精细控制流调度。
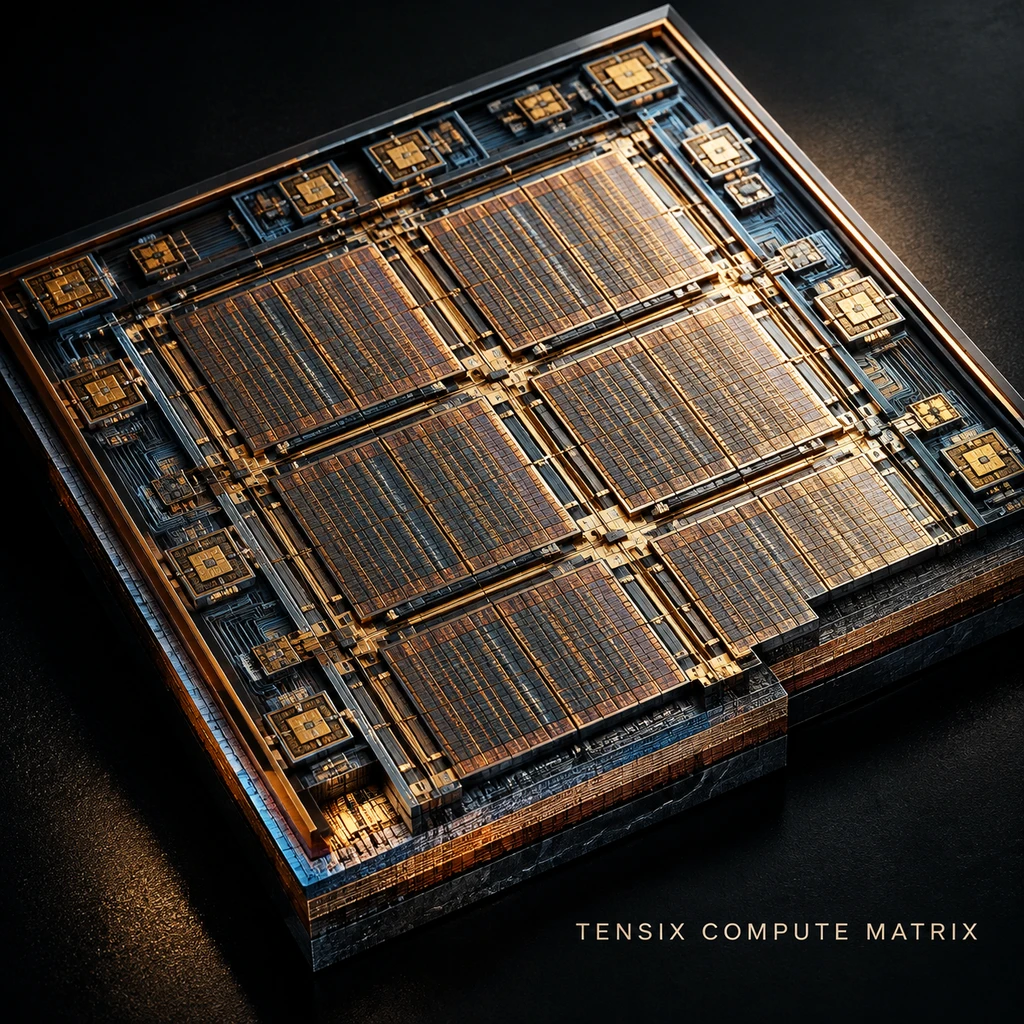
硬件产品路线从早期的 Grayskull、2024 年 7 月推出开发者套件的 Wormhole,逐步过渡到基于 6nm 制程的 Blackhole(已于 2025 年 4 月 3 日推出开发者产品)。而在通用计算一侧,Tenstorrent 确实在力推 RISC-V,但其定位是独立的高通量通用 CPU IP。公司分别于 2025 年 12 月 4 日和 2026 年 6 月 30 日发布了 Ascalon IP 与 Ascalon S 架构,主要用于对外芯片设计授权或作为主机处理器协同工作,与 Tensix AI 算力阵列各司其职。
商业模式上,Tenstorrent 并不甘心只做单纯的硬件组装厂。它一方面销售板卡及整机,另一方面向车企及系统集成商授权芯片 IP。但支撑这种灵活性的基础,完全依赖于其软件体系:底层 SDK TT-Metalium、算子库 TT-NN 以及编译框架 TT-Forge。这一整套软件栈全部开源,其目的非常明确,就是为了绕过英伟达 CUDA 极其坚固的私有闭环。
跑分照妖镜:实验室演示与严苛生产环境的落差
促使资本继续跟投的关键技术事件,是 Tenstorrent 成功用其 Galaxy 服务器跑通了 DeepSeek 开源权重模型。在测试数据中,由 32 颗芯片构成的 Wormhole Galaxy 集群在张量并行模式下运行 Llama 3.3 70B(配置 Batch 32、128-token 输入),测得 72.5 tok/s/user 的单用户生成速率,整机总吞吐达到 2,268.8 tok/s。针对更大规模场景,由 16 台 Galaxy 组成的 512 颗 Blackhole 芯片超级集群,在运行 DeepSeek-R1-0528 671B 时据称可达成 350+ tok/s/user。
然而,一旦将这些跑分放进真实的推理生产环境,测试口径的局限性便显露出来。72.5 tok/s/user 的表现是建立在 128 个 token 的短输入提示词前提下的极端工况,这更接近交互式 Demo 而非典型业务。
作为行业基准,英伟达 B200 芯片在权威第三方机构 InferenceX 的严苛测试中,是在 8,000 token 输入长文本、1,000 token 输出的生产级负载且满足 50 tok/s/user 目标时,以 FP4 精度榨出了高达 6,127 tok/s/GPU 的真实吞吐。另一个主打超低延迟的对手 Groq,其 GroqCloud 在串流输出 Llama 3.3 70B 时也能输出 280 tok/s 的稳定速度,并且英伟达与 Groq 已于 2025 年 12 月 24 日达成了非独家推理技术许可协议。
| 硬件平台与方案 | 测试运行模型与配置条件 | 实测速度表现 | 系统功耗与售价参考 |
|---|---|---|---|
| Tenstorrent Wormhole Galaxy (32卡) | Llama 3.3 70B (Batch 32, 128-token 输入) | 72.5 tok/s/user (整机 2,268.8 tok/s) | QuietBox 2 (4卡 Blackhole) 售价 9,999 美元 / 标称 1,300 W |
| Tenstorrent Blackhole 超级集群 (512卡) | DeepSeek-R1-0528 671B | 350+ tok/s/user (官方标称) | 未公开整机总价 / 研发集群重资产部署 |
| NVIDIA B200 (单卡 / DGX 系统) | InferenceX 框架 (8,000 输入 / 1,000 输出, FP4) | 6,127 tok/s/GPU (达成 50 tok/s/user) | DGX B200 8卡系统最大功耗约 14.3 kW |
| GroqCard / GroqCloud | Llama 3.3 70B 纯串流交互推理 | 280 tok/s 串流输出 | 单卡典型功耗 240 W (TDP 275 W) |
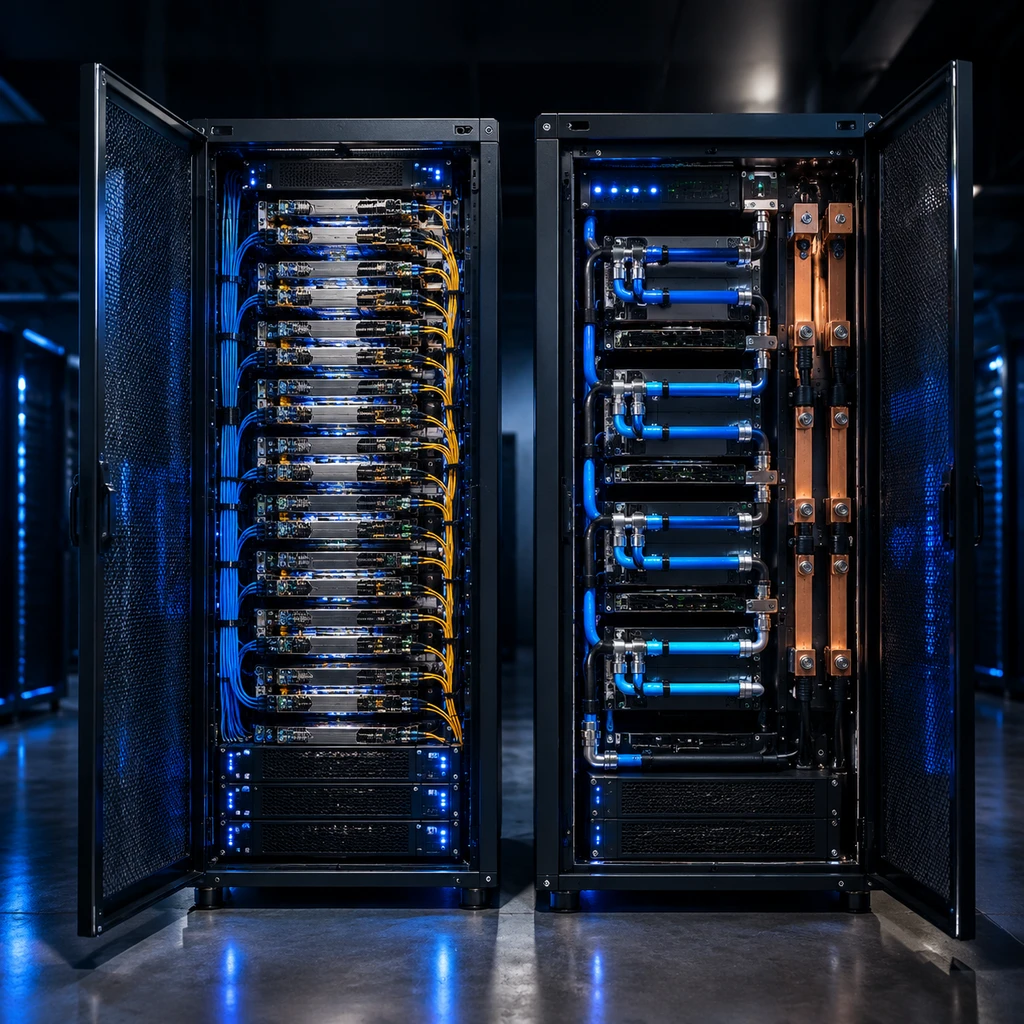
在生产场景中,企业真正的成本痛点在于处理复杂上下文时的计算能效。Tenstorrent 搭载 4 颗 Blackhole 处理器的 QuietBox 2 整机工作站售价为 9,999 美元,整机最大功耗标称为 1,300 W,而英伟达 DGX B200 的 8 卡系统最大功耗高达约 14.3 kW。单看整机购置门槛,Tenstorrent 确实提供了极具诱惑力的小型私有化选项,但一旦拉到长上下文下的吞吐能耗比,硬件层面的价差就会被长尾运行开销迅速稀释。
开源底层代码的沉重代价:从驱动摩擦到开发者门槛
开源并不等同于免费开箱即用。Tenstorrent 主打的 TT-Metalium 底层编程框架虽然对开发者完全开放透明,赋予工程师调校硬件底层的最大自由,但这种自由同时也构成了极高的工程门槛。
硬件采购的账面差价,极易被底层调优消耗的工程师人月成本迅速抹平。
开发者在社区报告与实测中反映,TT-Metalium 目前对模型优化提出了苛刻的专业要求。开发者必须手动处理张量分块(Tensor Tiling)、片上 SRAM 与板载 DRAM 之间的数据摆放以及复杂的分布式切片。一旦调度稍有偏差,就会遭遇硬件死锁或固件兼容性故障。例如在 2025 年 9 月,开发者使用 Blackhole 运行 Llama 模型时就曾遭遇底层的遥测错误与驱动阻塞。相比于在 CUDA 驱动下开箱即用的 vLLM 和 TensorRT-LLM 部署体验,普通开发团队要将业务迁移到这套自研软件栈上,必须承受漫长且代价高昂的底层工程调试。
- 风险.如果开源社区与第三方软件插件不能迅速抹平底层内存调度难度,Tenstorrent 的硬件将难以走出深度极客群体,并在主流商业推理市场陷入有价无市的工程孤岛。
对于采购决策者而言,算力采购不能只看 QuietBox 2 的 9,999 美元发票。若企业内部缺乏具备芯片级微架构调优能力的系统工程师,省下来的硬件购置预算,很快就会被拉长的调试周期吞噬。Jim Keller 凭借个人威望与坚决的技术品位拿下了 15 亿美元,但要想将 62 亿美元估值坐实,这家公司接下来必须在不依赖手工编写硬件内核的前提下,证明其能够让主流开源大模型在真实企业管线中平稳运行。