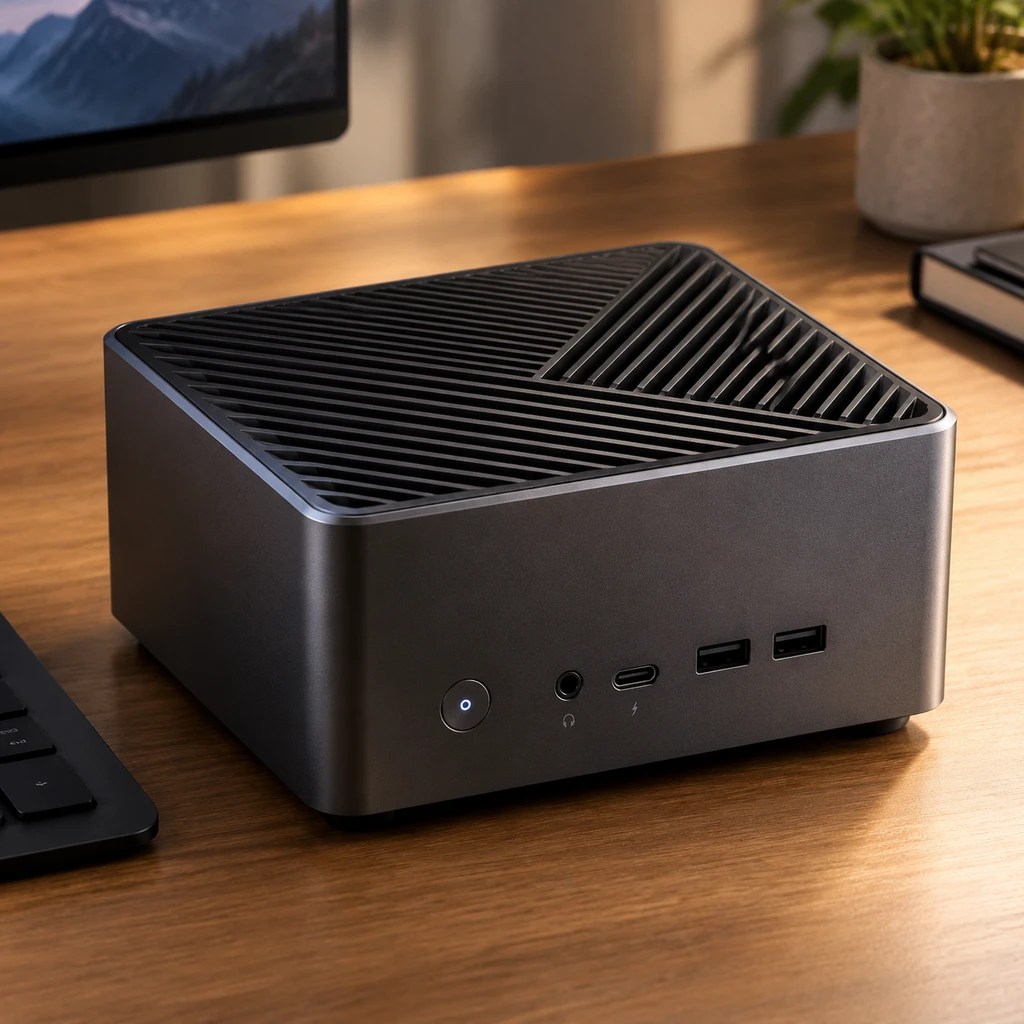
微软把自家史上最昂贵的一台桌面设备摆上了货架。官方定价 5,999 美元的 Surface RTX Spark Dev Box 正式开启预售,预计 11 月交付。相比英伟达同类硬件 DGX Spark 高达 6,950 美元的标价,微软直接砍掉了 951 美元,并塞进了整整 128GB 统一内存。
在动辄需要数百吉字节显存的大模型时代,这个价格确实让不少紧盯本地端侧研发的工程师心头一动。但如果剥开大显存与低差价的糖衣,这台机器深处藏着的架构妥协与软件断层,远比账面规格复杂得多。
一、纸面参数拉满的开箱工位
微软这次的产品策略很明确:把过去飘在云端的 Dev Box 搬到本地桌面,做成一台专门消化超大模型的紧凑型工作站。
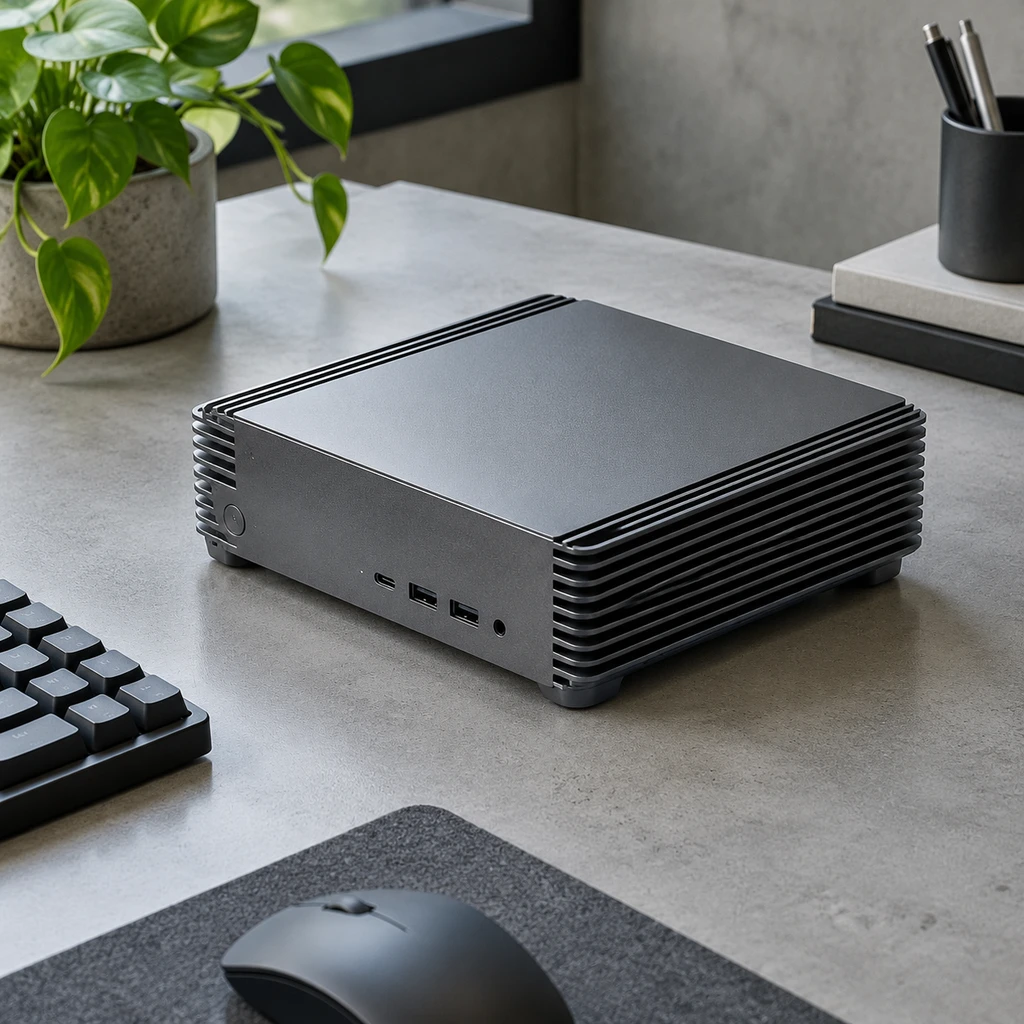
为了让工程师开箱就能干活,这台机器预装了 Windows 11 Pro 与 WSL2,并在底层做好了 GPU 直通与 CUDA 配置。出厂预装清单包括了 Visual Studio Code、Python、Node.js、Git、PowerShell 7 以及 GitHub Copilot。外壳采用 3D 打印阳极氧化铝,整机兼作散热鳍片,外形酷似缩小版游戏主机。
硬件指标上,微软给出的宣传非常亮眼:配备 128GB 统一内存,能够本地加载超过 1200 亿参数的 AI 模型,理论计算性能号称达到最高 1 PFLOP FP4。但细看官方博客的脚注就会发现,这个峰值算力包含了稀疏度(Sparsity)支持的理论收益。
更关键的是,微软至今没有发布任何经过第三方独立验证的实际工作负载跑分,连大模型推理最基础的每秒生成 Token 数量(tokens-per-second)基准数据也依然缺席。纸面数字喊得震天响,实际吞吐却秘而不宣,这往往意味着工程层面的摩擦力并不小。
二、sm121 架构的生态暗礁
在 AI 领域,向来有工欲善其事必先利其器的说法。但现实往往是器利而道不通。
这台设备搭载的 Arm 架构英伟达芯片,底层采用了极其特殊的 sm121 编译目标。能跑 CUDA 并不等于能无缝兼容整个 CUDA 开源生态。此前在同架构的 DGX Spark 实测中,开发者社区就已经暴露出大量兼容性问题:
- 常见的 NVFP4 工作流在很多现成模型管道中无法顺畅运行;
- 支撑当下前沿大模型高效推理的核心组件 FlashAttention 经常遭遇编译失败;
- 涉及 Triton 与 PyTorch 的底层自定义算子扩展,几乎都需要开发者自行修改代码并重新编译。
更令人担忧的是驱动的成熟度。基于同系列硬件方案的工程机 Surface Laptop Ultra,在早期技术测试中就曾被曝出严重瑕疵:即便装上更新版本的开发者驱动,部分 CUDA 工作负载依然无法顺利执行完毕。
对于习惯了在终端里一键运行主流仓库的研究人员而言,硬件不能仅仅是能通电,而是要能直接跑起社区昨晚刚刚更新的轮子。买一台标靶特规的机器,意味着每次主流推理库更新,开发者都得充当底层驱动与编译器的排雷兵。
- 风险.sm121 架构脱离了主流 x86 数据中心显卡的成熟编译路径,前沿算子无法开箱即用,会直接拉高团队的隐形维护成本。
三、披着工作站外衣的桌面家电
除了底层架构的摩擦,系统的选择同样充满分歧。
微软把所有的优化精力都倾注在 Windows 11 和 WSL2 身上。然而,正统 AI 工程界几乎完全建立在原生 Linux 生态之上。WSL2 哪怕做得再精致,终究是一层依托虚拟化架构的运行环境。微软在技术说明中对原生 Linux 发行版避而不谈,未明确承诺为该机型提供官方原生 Linux 支持。
社区开发者结合其 100 瓦功耗包线与统一内存带宽测算,这台机器的真实计算吞吐,其实更接近一台搭载低功耗版 RTX 5070 级别的桌面系统,而不是传统认知里拥有澎湃浮点能力的数据中心级工作站。
显存决定了你能否把大模型塞进去,但架构与带宽决定了它跑得有多痛苦。
很多开发者看中 128GB 显存,是希望能在一台机器上微调或者快速推理 70B 乃至上百 B 的开源大模型。在这个场景下,能载入模型只是第一步。如果在推理过程中缺乏高效的注意力算子加速,带宽吞吐被卡在低功耗框架内,生成速度掉到个位数,大显存的意义就会大打折扣。
- 建议.如果你的工作流重度依赖 Windows 与微软全家桶,需要一台高集成度、能把大模型塞进本地内存的调试盒子,它是目前少数的现成选择;但若目标是高吞吐的模型训练或主流 Linux 产线迁移,不如观望量产后的真实每秒 Token 表现再做决断。
微软在硬件工程上一向擅长开辟细分赛道,这次打出低价大显存的牌确实切中了开发者的痛点。但当潮水退去,决定一台机器生命周期的,往往不是它在发布会上列出的理论峰值,而是它能否在最普通的命令行里,稳定输出一行行没有报错的推理结果。