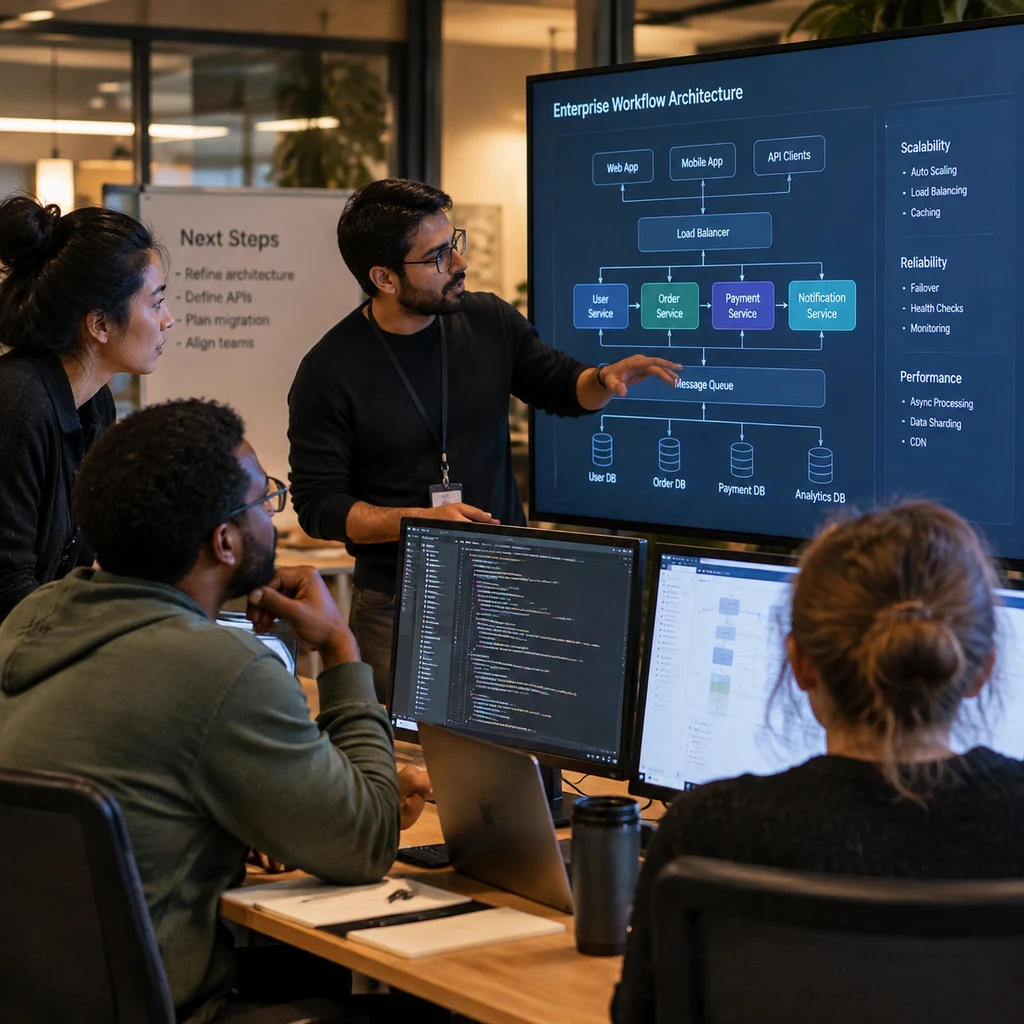
让非技术人员自己搭建 AI 工具的热潮,正在企业落地实践中撞上现实的墙。Stripe 披露了内部运转的知识 AI 平台 Kai,不仅用统一系统接管了销售、财务与合规部门的日常分析,更彻底终结了此前泛滥失控的 4,000 多个无代码微型 Agent。
企业落地的核心矛盾向来不在于大语言模型有多聪明,而在于缺乏工程维度的确定性约束。当硅谷还在争论让每个员工手搓 Prompt 算不算生产力革命时,Stripe 的实践给出了一个截然相反的判断:无约束的低代码微智能体只会制造治理灾难,知识工作的 AI 化必须回归平台化工程与严苛的数据隔离。
告别 4,000 个失控的微型 Agent
在引入 Kai 之前,Stripe 内部曾经历过一段野蛮生长的试验期。公司最初上线了无代码 Agent 构建器,允许任何人根据业务需求拉取工具、组装 Prompt。几个月内,内部催生出超过 4,000 个微型 Agent。
结果很快演变成维护黑洞。大量业务人员写着概念相似却质量参差的提示词,业务逻辑重复建设,系统既无法监控数据调用,也无法评估产出质量。部分业务员工转而直接求助面向开发者的编码智能体,结果把没有受过代码质量与权限规范训练的人员推向前台,直接冲击了数据安全红线。
Stripe 随即调整路线,在 2026 年 4 月上线 Kai,用统一的平台治理替代分散的自制工具。上线短短 4 周内,Kai 的活跃用户数从 296 人激增至 5,000 人以上。目前全公司各业务线已在统一管理后台中配置并维护了超过 1,000 个特定任务技能。
知识工作为何缺少天然护栏
技术界普遍感受到编程 Agent 的成熟度远高于业务 Agent。在 Stripe 内部,代号为 Minions 的编码智能体已被工程师广泛使用,其背后依靠的是软件工程几十年来形成的天然反馈环:语法有编译器拦截,逻辑有自动化测试兜底,操作失误有 Git 历史提供可逆版本控制。
但在财务测算、客户调研与合规审查等非技术领域,这类可验证的闭环根本不存在。知识工作的完成标准往往高度依赖人工主观判断,单次任务流程无法通过自动化测试集进行断言检验。
缺乏编译器的确定性约束,是知识型任务难以直接复用代码智能体的根本原因。
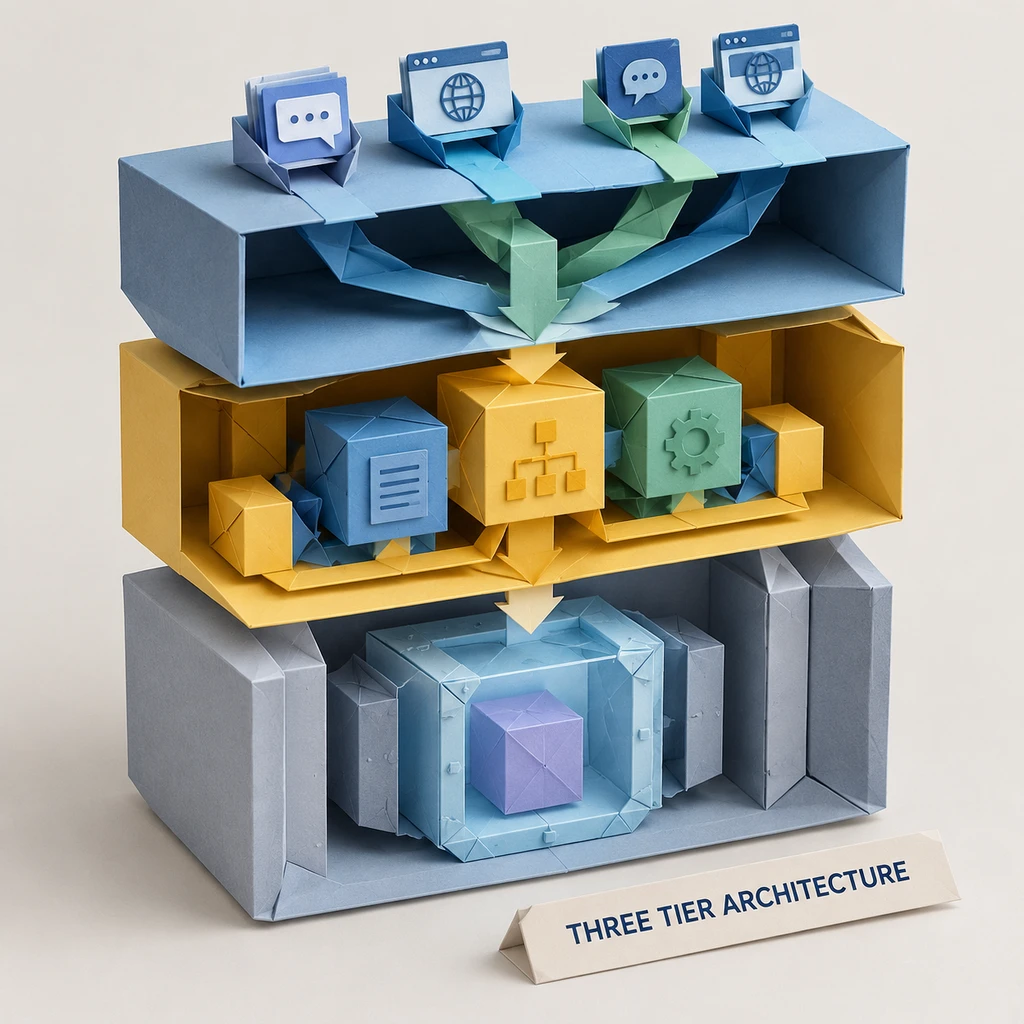
为给模糊的业务流程装上底座,Kai 将系统拆分为三层架构:最上层是适配 Slack、Web 和内部系统的多入口 API,中间层是供业务人员自主配置流程规则的 AgentStudio,底层则是基于 Deep Agents 构建的持久化环境与代码执行沙箱。当销售分析财务报表或合规排查风险时,数据计算被下沉到隔离沙箱中运算,通过代码执行产出确定性结果,以此代替大模型不稳定的直接数值推导。
权限重构:从身份权限转向任务级隔离
企业在推行大模型时最常遭遇的安全瓶颈,是传统基于角色的访问控制(RBAC)彻底失效。传统权限体系解决的是特定身份有没有查阅某条数据的资格,但在复杂的长链路 Agent 交互中,危险往往发生在多源上下文的混合污染。
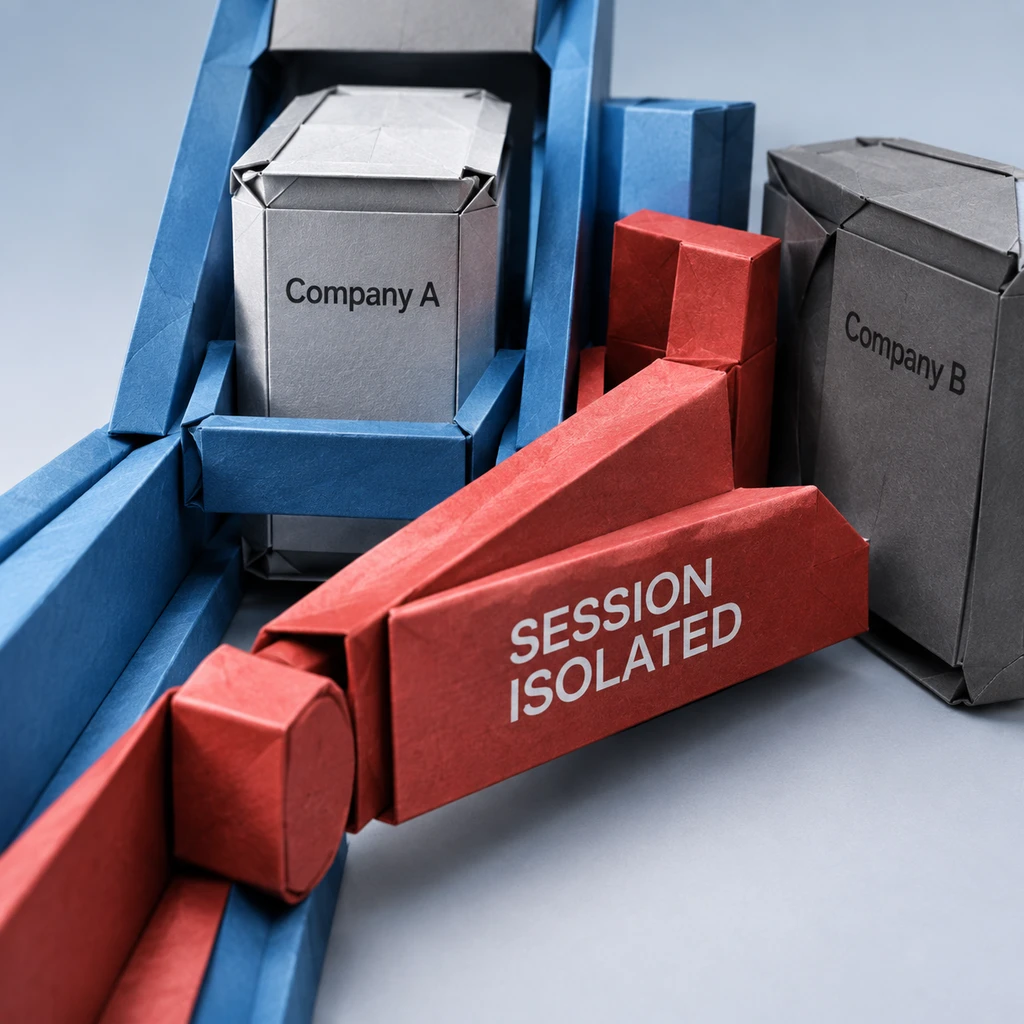
Stripe 在 Kai 中确立了一条硬性规则:绝不允许在单次分析任务中聚合两家无关客户的数据。
一名资深客户经理可能在权限系统里合法拥有 A 公司与 B 公司的查看权限。但在 Kai 的机制下,如果一个会话正在分析 A 公司的账单,系统就会切断对 B 公司的访问通道。安全边界从员工能看什么,转变为当前任务允许看什么。对于金融机构与跨国支付服务商而言,这种动态任务隔离是守住合规底线的真正门槛。
自研沉重代价与数据公关的水分
Stripe 宣称 Kai 每年为公司节省约 25,000 小时行政工时,销售人员成单效率出现明显提升。但仔细审视官方口径与外部披露,依然存在值得关注的信息温差。
关于 83% 周活跃度的统计基数,不同渠道存在口径分歧。原博客和技术社区报告往往表述为全员采纳率,而在面对特定市场的官方公关通稿中,这一数字被严格限定为 GTM(业务拓展与销售运营)团队的周活比例。此外,工时节省与销售业绩改善目前均为 Stripe 内部评估,并未排除宏观市场复苏与季节性采购周期的变量影响。
更深层的权衡在于平台自研的高昂代价。相比直接采购市面上成熟的 Glean 或 Microsoft 365 Copilot,Stripe 选择了一条极重的路线。维持 Deep Agents 基础设施、持续开发 AgentStudio,以及由各部门专家对 1,000 多个分散技能进行生命周期管理,需要巨大的长期研发预算投入。
- 风险.商业集成软件具备成熟连接器,却无法做到深度的专有任务隔离;自研平台虽契合业务,但维护千级自定义技能足以拖垮中小企业的技术基建。
Stripe 的尝试给行业留下了一个清晰的参照物。当企业的 AI 探索走出尝鲜阶段,比拼的不再是谁的员工更能写出精妙的提示词,而是架构师能否在沙箱环境与任务隔离机制上,为业务筑起足够严密的工程防线。