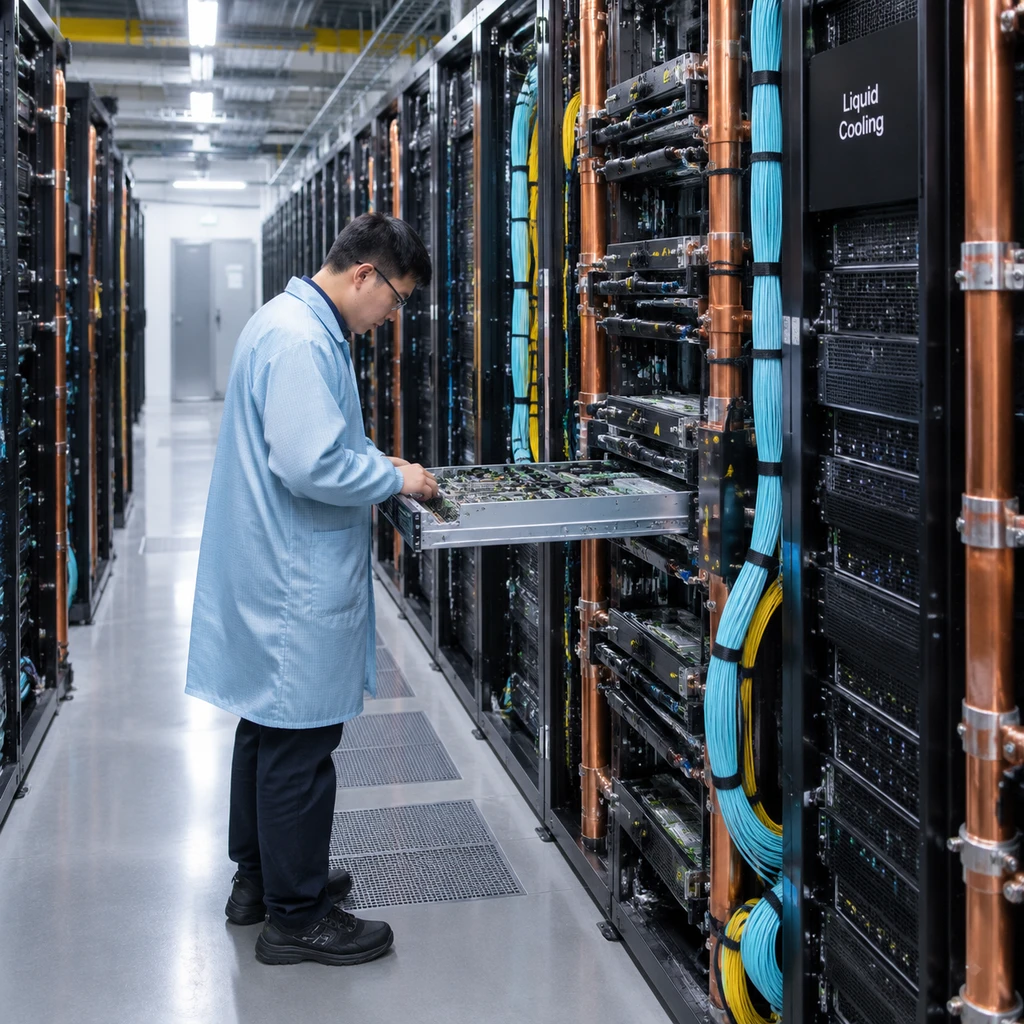
算力集群厂商 SkyPilot 刚发了一篇技术博客,声称给 NVIDIA Grace Blackwell(NVL72)换上他们的新调度器,能在同样的机柜里多榨出 27% 的可用 GPU。只看标题,很容易以为这家公司发明了什么点石成金的调度算法;但把账本扒开,这 27% 其实是一道用留白换存活的概率数学题,而且公式最早还是 NVIDIA 自己写出来的。
理解这件事,得先看清 NVL72 机柜制造的物理断崖。在 Hopper 架构及更早的年代,NVLink 高速互联只限于单台服务器内部(通常是 8 颗 GPU),跨节点训练必须走 InfiniBand 网络。到了 GB200 NVL72,NVIDIA 用 18 颗 NVSwitch 芯片把整个机柜里的 18 个计算节点、共 72 颗 GPU 焊成了一个共享显存的超级节点。机柜内部单卡双向 NVLink 带宽高达 1.8 TB/s(单向 900 GB/s),而跨机柜的 ConnectX-7 InfiniBand 网卡折算到单卡,单向带宽只有 50 GB/s。
机柜内外 18:1 的带宽落差,直接把跨机柜通信变成了减速带。大模型训练里的张量并行(TP)和混合专家模型(MoE)的专家并行(EP),通信全都卡在计算的关键路径上,没法跟计算过程完全重叠。
- 吞吐量腰斩.Hugging Face 测算过,一旦张量并行被迫从 NVLink 掉到 InfiniBand 上,训练吞吐量直接下跌 43%;在未优化的 64 路专家并行训练里,跨节点通信甚至能吃掉 60% 的训练时间。
- 推理与预训练实测.在实时推理服务 DeepSeek-R1 时,支持 32 路专家并行的 GB200 NVL72 单卡吞吐量是 8 卡 B200 服务器的 4.4 倍;NVIDIA GR00T 团队在 512 颗 GB300 GPU 上做预训练时,仅仅是把任务整齐塞进 8 个机柜(避免跨机柜乱切),单次迭代时间就从 1.59 秒缩减到 1.39 秒,吞吐量提升 14.4%。
拆穿 27% 的数字魔术與木桶效应
既然机柜内通信这么快,把每个任务都按 18 个节点的满配机柜去分配不就行了?问题出在 GPU 的故障率上。
Meta 在其吉瓦级超算集群上花了大力气做可靠性工程,测算出的 4 卡节点平均无故障中断时间(MTBI)依然只有约 490 天。到了 NVL72 机柜,18 个节点绑成一根绳上的蚂蚱,故障爆炸半径直接放大 18 倍——平均每 27 天,单台机柜就会遭遇一次硬件中断。如果把集群扩大到 128 个机柜(共 2,304 个节点),平均每 5 个小时就会有一台机柜因为坏了一个节点而无法满配运行。
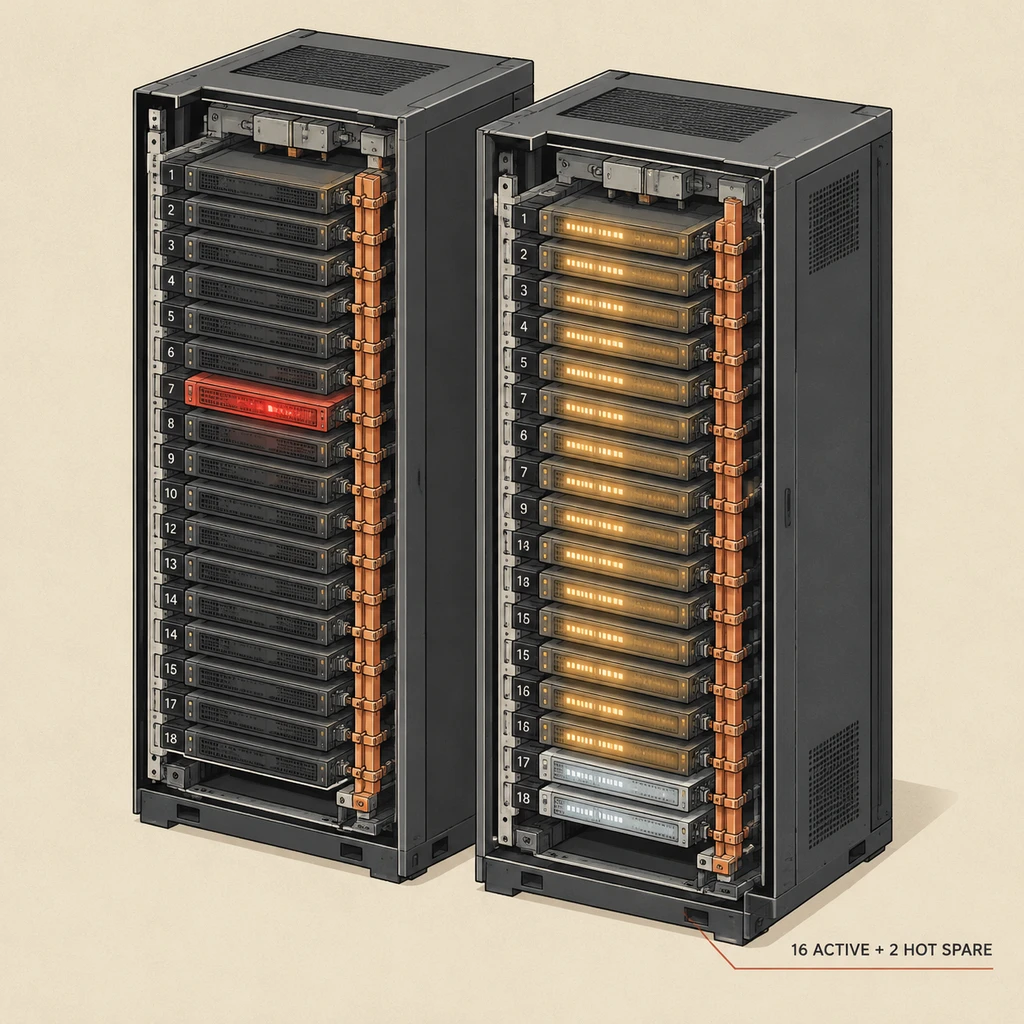
这就是 SkyPilot 标题里 27% 的真正来历。在生产环境约 2% 的节点不可用率下,如果死磕 18 节点满配切片,任何一个节点故障都会导致整台机柜搁浅,2,304 个节点里最终只有 1,602 个节点可用。反过来,如果退一步采用 16 节点切片(即 64 颗 GPU,恰好契合二进制并行分组习惯),每个机柜留出 2 个节点当热备冗余,只要单机柜坏的节点不超过 2 个就能就地顶上,可用节点数立刻回升到 2,037 个。
2,037 对比 1,602,多出来的 27% 容量就是这么算出来的。而且这套概率模型根本不是 SkyPilot 的独门秘籍,而是 NVIDIA 官方在讲怎么用 Slurm 块调度(block scheduling)管理 GB200 机柜时给出的简化数学模型。把硬件切片策略算出来的理论容量差,包装成新调度器的功劳,这属于典型的营销借力。
调度器暗战与算力俄罗斯方块
拆穿了 27% 的口径把戏,并不意味着 SkyPilot 指出的是假问题。恰恰相反,NVL72 把大模型集群拖进了一场极难伺候的俄罗斯方块游戏。
19 世纪美国铁路大扩张时,各州铁路公司各用各的轨距,火车开到州界就得把货物卸下来重新装车,运力全耗在换轨上。今天的 NVL72 机柜就像一段段内部极速的宽轨铁路,一旦训练任务被调度器切碎、跨过了机柜边界,就得在 InfiniBand 换轨点上排队挨罚。
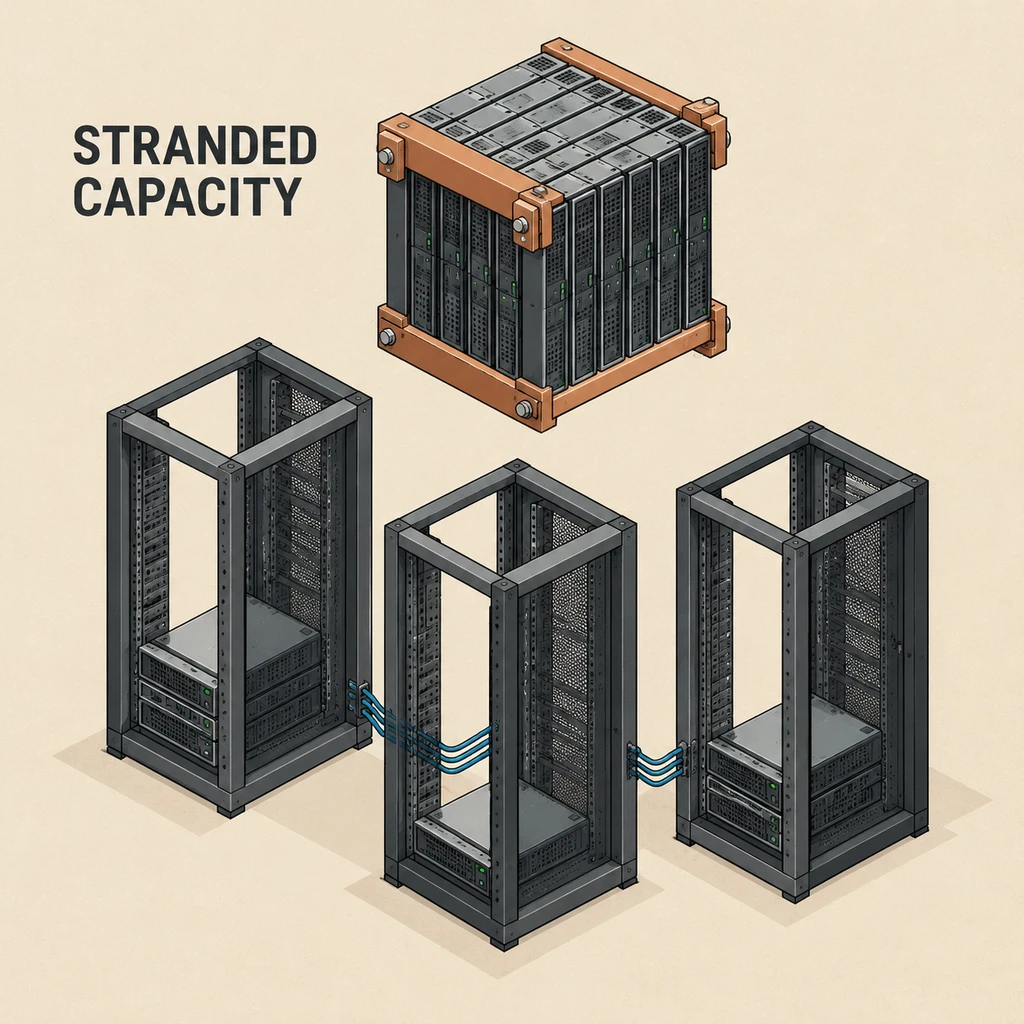
在真实生产集群里,除了硬件随时会坏,不同规模的任务启动和结束时间也参差不齐。跑着跑着,每台机柜里都剩下一两个零散的空闲节点。账面上看集群还有上百张空闲 GPU,但因为凑不齐同一个机柜里的连续 16 个节点,新的大模型训练任务根本排不进去。这批看得见用不上的卡,就成了价格高昂的搁浅算力(Stranded Capacity)。
为了拼好这盘俄罗斯方块,SkyPilot 祭出了三招:拓扑感知放置、同机柜热备原位恢复(in-place recovery),以及抢占式的自动碎片整理。但放到整个 AI 基础设施牌桌上审视,我不太买账的是它把这套方案写成了一场从零到一的拯救:
| 对比维度 | 原生 Slurm (配 topology/block) | NVIDIA Run:ai | SkyPilot Platform |
|---|---|---|---|
| 机柜拓扑感知 | 原生插件支持,27% 模型最初出处 | 原生支持多层级拓扑组调度 | 支持机柜局部性放置与切片 |
| 核心优势场景 | 裸金属超算集群,运行时开销极低 | 深度绑定 NVIDIA 硬件生态与 K8s | 跨 Slurm、K8s 与多云的统一抽象层 |
| 隐性工程代价 | 故障热替换与跨云编排需深度脚本定制 | 商业授权绑定,受限于 K8s 生态体系 | 自动碎片整理依赖抢占,增加 Checkpoint 开销 |
在 Reddit 的 HPC 和 Slurm 运维社区里,一线工程师对换掉 Slurm 的叙事相当冷淡。配置好 topology/block 插件的 Slurm 早就具备机柜感知能力,且底层开销更小。更重要的是,SkyPilot 并没有拿出控制变量的对照实验——既没有把拓扑放置、热备替换和碎片整理三项收益拆开量化,也没有提供在相同工作负载轨迹下跟开启拓扑插件的 Slurm 或 Run:ai 的正面跑分对比。
硬件越是焊死成铁板一块,软件调度就越得学会留出容错的呼吸缝。
况且,自动碎片整理绝非免费的午餐。要把散落在不同机柜的小任务腾挪合并、给大任务腾出整柜空间,就得频繁抢占正在跑的作业。在动辄上千张卡的生产集群里,暂停任务、把显存状态写入存储(Checkpoint)、换个机柜再重新拉起,消耗的存储带宽和排队等待延迟(Queue-time),全都是实打实的真金白银。
- 提醒.云厂商与智算中心在交付 GB200 与升级了 800 Gb/s ConnectX-8 网卡的 GB300 机柜时,若仍按传统的满配节点售卖和调度,2% 的常规硬件故障就能废掉近三成机柜可用性;大模型团队在设计并行方案时,也必须放弃吃满 72 卡的执念,主动向 64 卡(16 节点)的容错切片妥协。
《淮南子》里讲,大厦之成,非一木之材也;大海之阔,非一流之归也。过去两年,AI 行业比拼的是谁能从黄仁勋手里抢到更多的卡;当单台机柜被 NVLink 焊成价值数百万美元的紧耦合巨兽,粗放堆卡的日子就到头了。接下来检验各家 AI Infra 成色的真实变量,不再是谁能喊出更大的集群总卡数,而是在日常 2% 的硬件坏死率下,谁的调度器能用最少的抢占停机代价,守住机柜内那条 900 GB/s 的生命线。