前一天刚发 0.4 修复小警告,第二天就直接改写大版本推上 1.0。Simon Willison 给命令行分词工具 ttok 做的这次连跳,不是因为底层架构有什么脱胎换骨的重写,起因非常戏剧化:他用 uv tool upgrade 升级后顺手测了一行命令,发现默认分词器居然还在按 GPT-4 切文本。
与其慢慢修补,他索性借着变更默认值的由头把版本号直接拉到 1.0,将默认模型直接挂靠到 GPT-5 与尚未发布的 GPT-6。
这件事最值得警惕的地方不在于工具更新多快,而在于整个开发链条出现了一处极不健康的断层:
- 事实变动.ttok 默认模型从 GPT-4 时代的旧词表,硬切至对应 GPT-5 的更大词表。
- 关键风险.OpenAI 官方至今未确认 GPT-6 的分词器规则,这一版 1.0 完全建立在社区对云端 API 的黑盒逆向测试之上。
- 影响对象.那些在自动化脚本里用 ttok 做硬性截断、但下游业务接口仍停留在旧模型的工程师。
信息交付完毕,后面看清楚这把尺子到底歪在哪里。
44,794 个黑盒样本:当开源生态不得不替厂商抢跑
要看懂这次 1.0 跃迁,必须先看官方仓库里的一场僵局。
在 OpenAI 官方维护的 openai/tiktoken 仓库里,Issue #608 至今悬而未决。官方代码的映射表收纳了 gpt-5、o1、o3 以及 gpt-4o,把它们统统指向词表更大的 o200k_base,但对 GPT-6 始终只字不提。
Simon Willison 敢把 GPT-6 写进自己的发版说明,依据不是任何官方文档,而是开发者 William Liu 的一组经验测试。
William Liu 用 434 次无报错调用,在 31 个固定样本上对比了 7 款模型,包括 GPT-5.5、GPT-5.6 以及 GPT-6 的三个变体。这 7 款模型在全部样本下的计数分毫不差,全都落在一个具体的数字上:44,794。作为对照,同一批文本丢给 Claude 测出的结果是 68,940。
端点返回的数字一致,只能说明计费逻辑目前采用了相同的统计规则,无法证明底层切分细节完全同构。特殊控制符、多语言冷僻字或者保留词会不会在某种极端边缘下产生切分分歧,黑盒调用根本给不出保证。
当大厂不再把基础分词规范公开透明地写进开源库,下游工具链为了不被宣发抛下,只能靠盲人摸象式的探针把测出来的经验值当成真理。
更荒诞的是分发渠道脱节。直到 1.0 的 GitHub 标签打出来,PyPI 官方索引上的包甚至长期停留在 0.3。很多工程管道如果只靠包管理器拉取,用到的依然是上一个时代的旧规则。
默认值迁徙的暗礁:从词表扩容到截断溢出
换掉一个默认参数,对日常随手玩玩终端的人来说毫无知觉,但对正经跑在生产线上的脚本来说却是一枚延时引信。
ttok 的核心用途之一是在流水线中切分长文本。当默认模型从基于 cl100k_base 的 GPT-4 换成基于 o200k_base 的新模型时,度量衡的物理刻度变了。
| 分词器编码 | 覆盖模型代际 | 词表规模与切分特性 | 自动化脚本升级风险 |
|---|---|---|---|
| cl100k_base | GPT-3.5, GPT-4 | 词表规模相对收敛,中文等多语言压缩比较低 | 截断阈值保守,估算调用量常高于实际开销 |
| o200k_base | GPT-4o, GPT-5, o 系列 | 词表翻倍扩容,非英文字符压缩效率大幅提升 | 本地截断放行更多字符,推送至旧模型必爆窗口限制 |
o200k_base 塞进了多出一倍的词表空间,中文等多语言文本的切分效率大幅改善。这意味着完全相同的一篇中文长文,在新分词器切出来的数字会明显变小。
如果生产脚本更新到了 ttok 1.0,本地用 -t 8000 截出了一段自以为合规的提示词,而后端业务为了稳定性依然调用老版 GPT-4 接口,老接口按旧规则一算,实际长度很可能达到 9500。原本用来保护接口不超限的截断工具,因为换了度量衡,反手把超出上限的文本塞进了老模型的怀里,当场触发上下文溢出。
借来的算法与切碎的字符:被忽略的管道硬伤
即便抛开跨版本的词表差异,ttok 作为极简终端工具的底层机制,本身就带着难以回避的粗糙。
它从来不是一套独立的分词引擎,只是给 Python 库 tiktoken 套了层 Shell 外壳。参数设计极简,-i 读入,-t 按数量截断,-m 换模型。这种设计面对纯英文文本省心省力,但面对中文等多字节编码时,缺陷显露无遗。
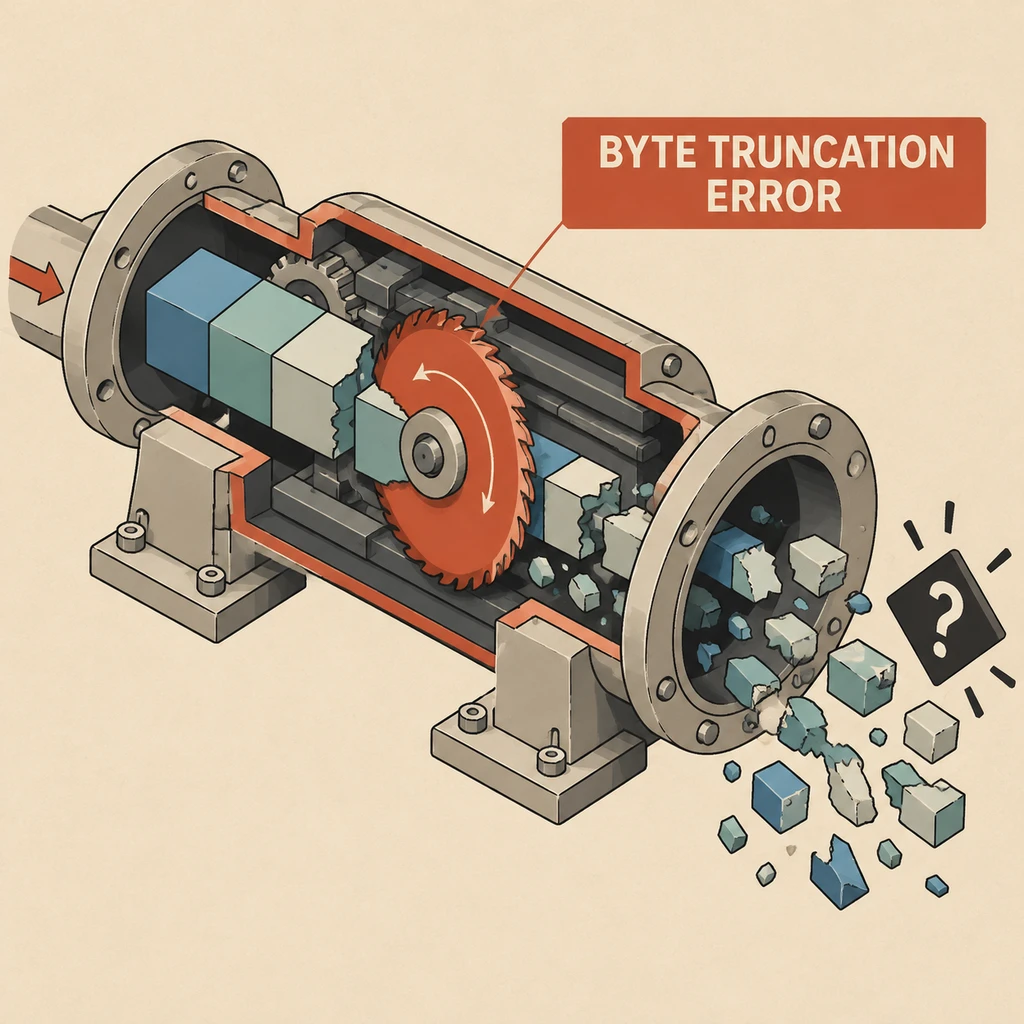
截断逻辑极为粗暴:先将文本编码为整数数组,直接按数字切片,再将剩下的序列逆向解码回字符串。对于 UTF-8 编码的汉字,一个字符通常占 3 个字节,分词切片的位置极有可能卡在某个汉字编码的正中间。
在边界强行掐断时,末尾的字节序列自然就残缺了。底层的 tiktoken.decode() 面对残缺字节并不报错,而是默默换成占位符。这种静默替换让管道从不中断,却神不知鬼不觉地在尾部留下乱码与语义破损。
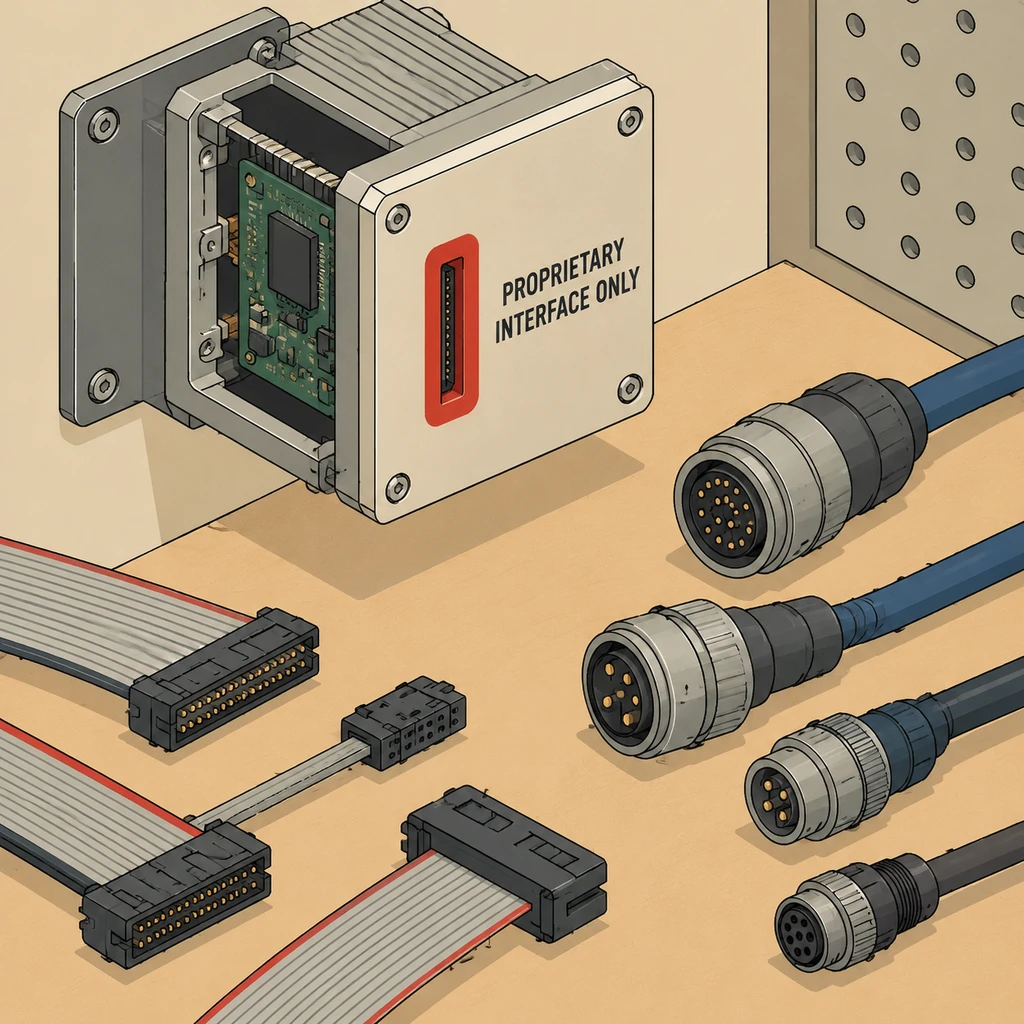
与此同时,整个工具依然深陷在专有围墙里。在 0.4 和 1.0 中,作者加了 --list-models,但社区早在多年前就提出的 Issue #8(接入 Hugging Face 分词生态并支持开源权重)依然无人理睬。今天的技术团队早就不会死守某一家接口,前端调用商用闭源模型、后端部署开源权重是常态,一个只能切分特定商用词表的终端小工具,越维护越像个与世隔绝的孤岛。
终端计数不等于计费账单
很多写脚本的人还有另一个根深蒂固的误解:在数据灌库前用 cat prompt.txt | ttok 扫出来的数字,就是月末调用 API 要付钱的基准。
这种把纯文本分词直接等同于 API 计费的做法,几乎必定算错成本。
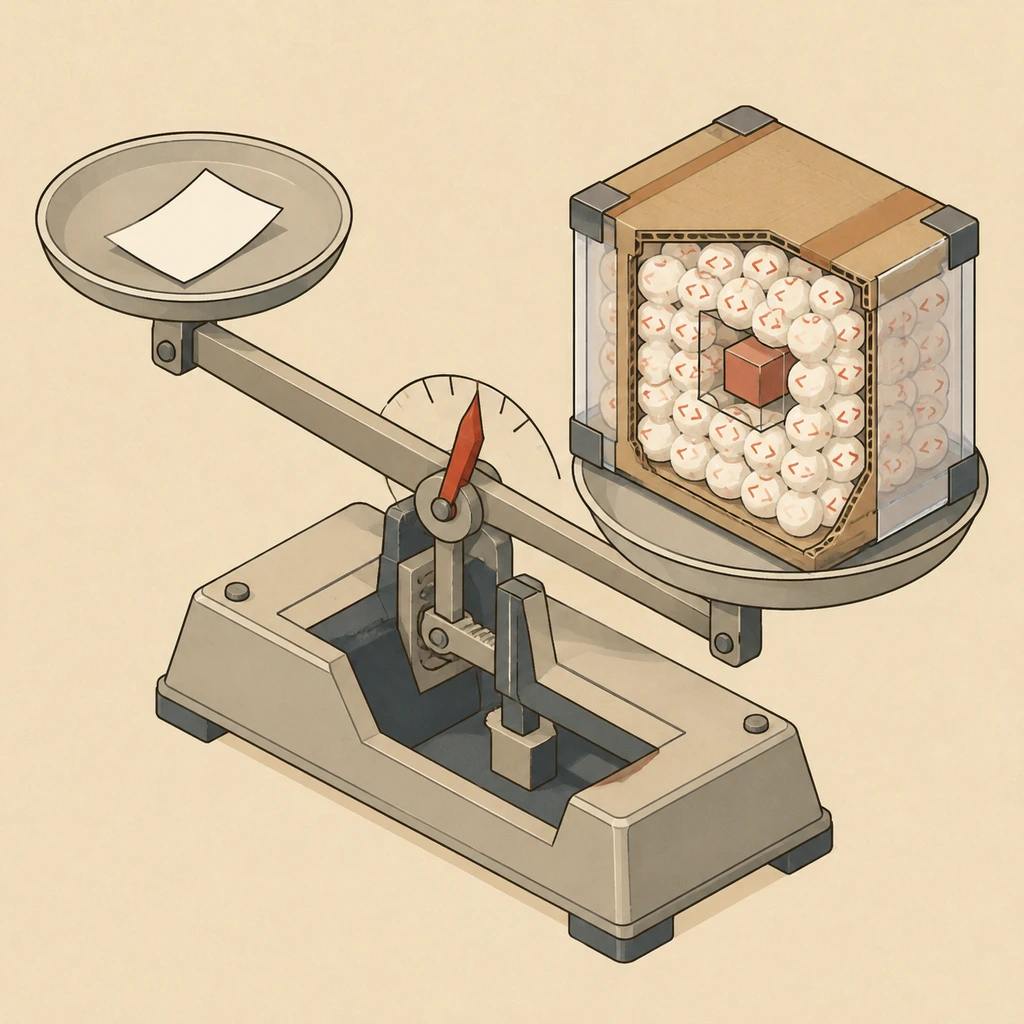
在终端里随手敲一个 echo "hello" | ttok,echo 自带的末尾换行符就会切碎边界,平白多算出一到两个 token。
更大的开销在接口封装层。真实的对话接口不会裸奔接收文本,服务端会在外部嵌套 Chat Template,把角色头、对话隔离符以及各类保留控制标记全部塞进上下文。你在终端里量出来的只是裸文本骨架,计费网关扣除的却是穿上整套工服之后的完整体量。
度量衡的本质是契约。秦始皇统一度量衡,前提是官府颁布标准衡器,天下遵行。当大模型寡头选择把尺子的物理刻度藏在云端深处、连底层库都懒得同步时,开源作者为了维持工具的体面,只能靠几次端点调用的吻合去赌明天。
用 ttok 在终端里扫一眼文本规模依然顺手,但若要拿它当成截断上游、核算成本的严谨基准,最好想清楚:当造尺子的人都在摸黑猜谜,你手里的刻度随时都可能落空。