大模型应用跑进自动化流水线时,最先击穿工程预算的往往不是线上用户,而是持续集成里的自动化测试。
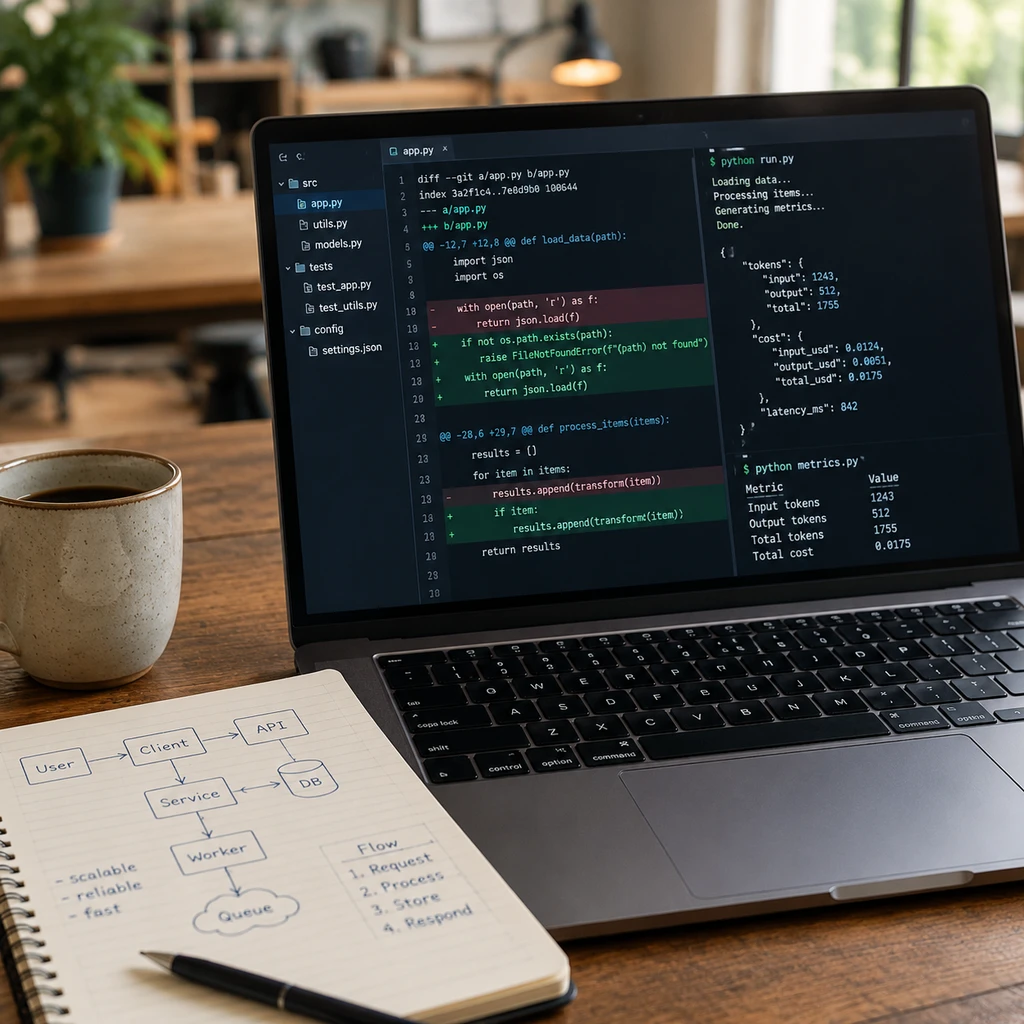
Simon Willison 发布了调试插件 llm-echo 0.5。这个工具最特殊的地方在于,它名义上挂着大模型插件的招牌,内部却完全不调用任何 LLM。它本质上是一台纯粹的代码复读机,接收提示词,随后原样吐出。但新版本做了一件至关重要的事情:将模拟 Token 的统计口径,从原先的基础输入输出,一口气延伸到了系统提示词、工具调用以及思维链推理 Token。
在大部分人盯着前沿大模型跑分和推理速度的时候,软件工程的基础设施正在悄悄完成一次转向。
从纯文本复读到模拟复杂状态机
早期的大模型测试非常直接:向接口发送一句话,断言接口返回一段文本。只要测试框架能捕获字符串,流水线就算跑通。
但今天的智能体逻辑完全变了。调用一次支持推理的模型,返回的结果不再是扁平的字符串,而是包含预设思考、工具触发动作和最终回答的多层结构。旧版的本地桩程序一旦无法解析这些结构,下游的所有计费审计与日志归档功能就会在单测中集体崩溃。
llm-echo 0.5 明确要求主框架依赖版本 ≥ 0.36。在这个版本中,由开发者 Jaden Fix 提交的代码引入了完整的推理模拟。通过附加 -o thinking 1 选项,这台复读机在吐出最终结果前,会先固定喷射出两个预设的思考切片,精准模拟底层数据流。
从表面上看,这种写死的数据块毫无智能可言。但这正是工程测试需要的特性:完全确定、零延迟且没有网络成本。
核心框架底层的账本是怎么记的
为了支撑这种复合调用的测试,主项目的核心层必须提供足够标准化的数据协议。
在主框架的运行机制中,每一次模型交互都会通过结构化对象返回结果。底层接口通过挂载在响应中的统计方法产出规范记录,将消耗明细拆解为标准的输入、输出与细节字典。针对思考过程的计量,数据会在 SQLite 日志中被归档为专门的细分指标。
在高级模型插件的设计中,系统允许在流式传输过程中分发独立事件。当数据块标记为特定类型时,上层交互界面可以实时渲染折叠的推理状态;当调用结束时,框架层再通过统一接口将消耗明细写入本地数据库。
如果开发者的测试插件没有跟上这种多层计量,本地构建就会出现严重的断层:你以为写好了防御逻辑,但一推到线上遇到多轮工具调用,下游监控模块就会立刻因为解析不到字段而宕机。
为什么测试大模型最需要的是“没有大模型”
软件工程里有一句流传已久的老话:买得起马,就得配得起鞍。但在智能体时代,开发者面临的窘境是:连测试马匹到底能不能跑,每次都要向供应商刷一次卡。
在自动化构建流水线中,如果每一个 Pull Request 都要发起数十次商用接口调用,团队不仅要承担陡增的 API 账单,还会面临网络抖动、偶发超时以及生成内容随机带来的单测误报。把这种不确定性放进持续交付系统,本身就是一场灾难。
决定系统健壮性的,不是模型有多聪明,而是外围的兜底防线有多坚硬。
当行业开始探讨为大模型系统设立严格的预算硬上限时,Mock 层的颗粒度就成为了防御能力的关键。如果本地的桩模块无法精确回显由系统提示词、长链推理和外部工具带来的消耗膨胀,开发者根本没办法在代码上线前,验证自己的熔断策略是否真的生效。
- 风险.完全依赖固定数据的复读机插件,无法反映真实切词器的分词差异与多轮调用的复杂上下文压力。
- 建议.在持续交付中使用确定性 Mock 覆盖绝大部分限额、日志和流式状态测试,仅将少量端到端真实调用留给发版前的冒烟验证。
古人讲求“假作真时真亦假”,但在严肃的工业软件交付里,恰恰需要先造出一个严谨的假目标,才能确保真系统上线时不至于盲目裸奔。Agent 生态的演进不仅是算法的军备竞赛,也是这些看似枯燥、甚至略显笨拙的本地工程脚手架,在泥泞中一步一步搭出来的结果。