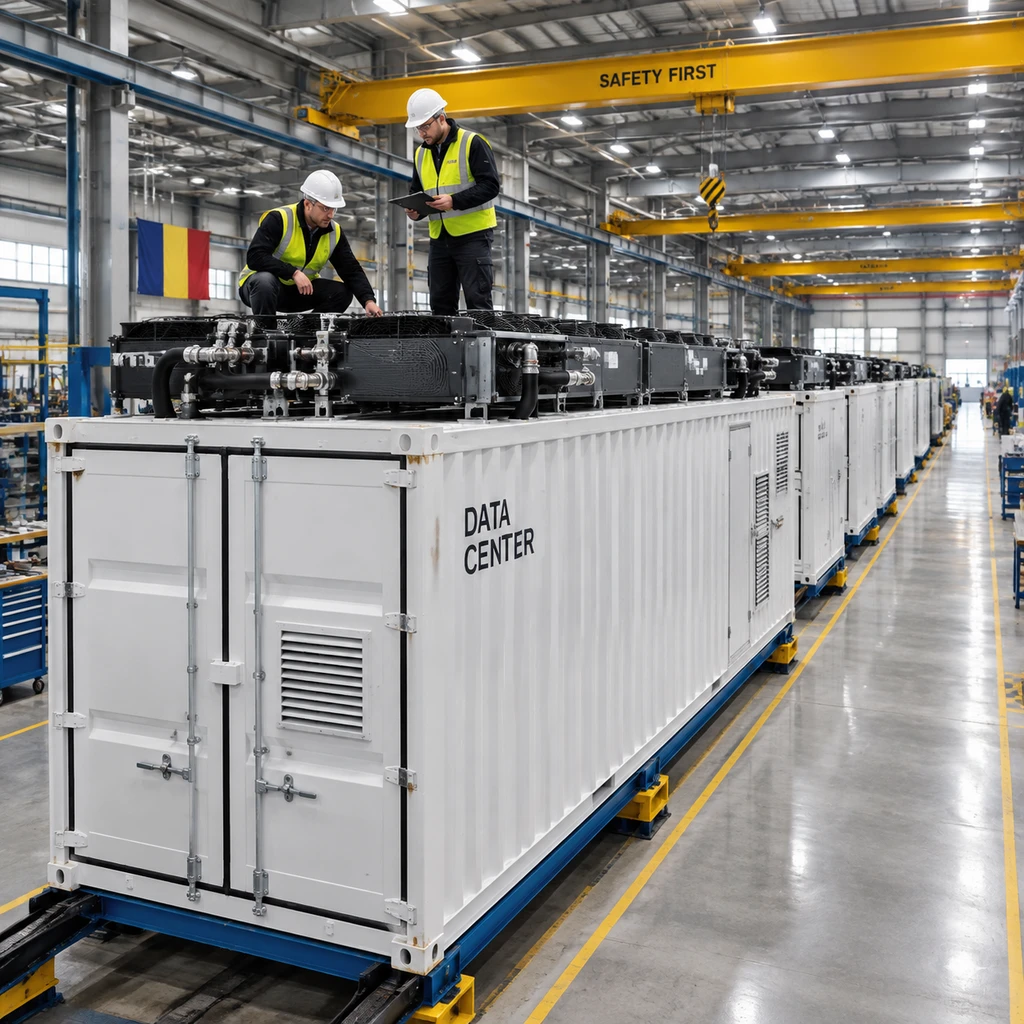
AI 基础设施初创公司 Runware 打算像造汽车一样,在流水线上批量生产数据中心。公司联合创始人兼 CEO Flaviu Radulescu 宣布,正利用 2025 年 12 月筹集的 5000 万美元 A 轮融资,在罗马尼亚扩建第二座工厂(预计明年初投产),目标是把旗舰产品 Sonic Inference Pod(模块化数据中心)的单台制造时间从三周压缩到一天,到 2028 年实现日产 30 兆瓦、月产近 1 吉瓦的产能,并在运抵现场后 48 小时内上线。
如果按这一速度满产,Runware 一年下线的数据中心容量将达到约 10 吉瓦,几乎追平高盛预测的全美今年新增数据中心总电力规模。但剥开这套宏大的工业叙事,Runware 卖的并不是传统意义上的超算中心:它装的是工作站级显卡,省掉的是本地备用电源,而流水线造箱子造得再快,也绕不开数据中心真正的死穴——电网并网与重资产周转。
单箱 1200 张显卡与百倍低价:靠工作站芯片和砍冗余换来的账面奇迹
Runware 最吸引眼球的两个数字,是单箱塞入 1200 张 GPU 的高密度,以及号称比传统数据中心低 100 倍的基建成本。
一个标准 Sonic Inference Pod 是一只 20 英尺集装箱,内置 1 兆瓦 IT 算力,顶部自带闭环液冷加风冷散热器,现场无需接入水源。但这 1200 张显卡的主力型号是 RTX PRO 6000,而非英伟达顶级的 Vera Rubin 或 GB300 NVL72 机架架构。这决定了它的真实定位是跑轻量、高并发的生成式 AI 推理(如图像与视频生成),而不是替大模型公司做前沿训练。目前 Runware 披露的平台客户包括 Wix、Freepik、Quora 和 Higgsfield AI,其中仅 Higgsfield AI 在 2026 年 8 月被明确提及从 API 调用扩展到了底层推理设施,其余哪些客户真正掏钱买箱子或租专用算力(按需 1.60 美元/GPU 小时起,预留 0.63 美元起)并未公开。
更关键的差异藏在基建成本账本里。Runware 宣称其内部设施与部署成本(不含 GPU 硬件)仅为 1.5 亿美元/吉瓦,折合 150 美元/kW,而传统数据中心高达 150 亿美元/吉瓦。
这 100 倍的价差并不是靠罗马尼亚工厂的流水线省出来的,而是因为 Runware 直接砍掉了本地冗余。传统企业级数据中心之所以昂贵,很大一部分预算花在了冗余 UPS(不间断电源)、备用发电机和 N+1 冷却系统上,以确保单机房断电时不掉线。Runware 的逻辑是放弃单箱的高可用硬件兜底,一旦某个站点断电或故障,直接靠软件把推理请求路由到其他地区的集装箱集群。拿砍掉本地防灾设施的简配箱体,去跟 Tier-3 级传统机房比造价,本身就是错位对比。
百倍成本优势的真相,是用软件跨区切流量替代了昂贵的本地不断电冗余。
为了看清 Runware 在预制模块化数据中心赛道里的真实位置,可以把它与同赛道的另外三家主流方案放在同一张表里对照:
| 厂商与方案 | 单模块/单元功率 | 芯片与硬件配置 | 交付与现场安装周期 |
|---|---|---|---|
| Runware Sonic Pod | 1 MW / 20英尺箱 | 约 1200 张 RTX PRO 6000,无本地冗余 UPS | 造箱目标 1 天,场地就绪后 48 小时上线 |
| Crusoe Spark Liquid | 最高 3.5 MW / 模块 | 支持 GB300 NVL72 与 Vera Rubin NVL72 | 最低 3 个月交付(预计 2027 年初投产) |
| 施耐德电气 RD115 | 10.4-11.4 MW / 单元 | 单机架 188-227 kW,含冗余 UPS 与 N+1 冷却 | 白空间模块现场安装仅需 15 小时 |
| 英伟达 DSX POD | 视参考设计规模而定 | Vera Rubin 级参考设计架构 | 场地就绪前提下最快 14 天部署 |
横向对比就能发现,把现场安装压缩到几十个小时并非 Runware 独创——施耐德电气带完整冗余的模块现场拼装也只要 15 小时。真正的区别在于,Crusoe、施耐德和英伟达解决的是如何把单机架近 200 千瓦的顶级训练/推理集群快速落地,而 Runware 造的是低成本、可随时牺牲单点的分布式推理盒子。
造箱子缩到 1 天,也治不好电网审批与重资产周转的慢病
即便客户接受这种无本地冗余的推理架构,Runware 承诺的“48 小时通电上线”和“日产 30 兆瓦”依然面临两道物理铁律的拷问。
第一道铁律是工厂产能不等于通电产能。Runware 承认,48 小时仅指集装箱运抵现场后的吊装与接通时间,前提是场地的土地平整、市政审批、高容量电网并网和光纤网络已经全部就绪。在欧美新建数据中心,最卡脖子的从来不是服务器机柜要装几个星期,而是动辄耗时数月甚至数年的电网并网许可。
Runware 的应对策略是避开亚马逊、微软那种动辄几百兆瓦的超级园区,转而寻找现成带电的小型场地。公司声称目前已锁定 397 兆瓦的站点电力管线(有潜力扩展至 1.2 吉瓦)。但哪怕这 1.2 吉瓦管线全部按期通电,也只够其 2028 年规划产能(日产 30 兆瓦、相当于每天下线 30 个集装箱)消化 40 天。没有匹配吉瓦级扩张的带电土地,工厂流水线转得越快,积压在仓库里的铁箱子就越多。
第二道铁律是重资产制造的现金流黑洞。Runware 迄今累计总融资额为 6600 万美元(领投方包括 Dawn Capital,参投方有 Comcast Ventures、Insight Partners 和 a16z speedrun 等)。用软件初创公司的融资体量去干汽车流水线的重工业,历史上不乏前车之鉴:曾试图用微型工厂颠覆造车流程的电动车初创公司 Arrival,估值一度突破 130 亿美元,最终却因无法低成本规模化量产而在 2024 年破产清算。
Runware 虽然挖来了汽车行业的资深厂长并自研液冷方案,但核心供应链依然受制于人——冷却水泵和风扇要从德国采购,网络设备依赖英伟达,更不用提单箱 1200 张显卡所需的巨额备货营运资金。
值得注意的是,Runware 对外释放的业务数字已经出现明显的口径打架:
- 2026 年 8 月发布产品时,公司设定的 2027 年目标是超过 1 吉瓦;但目前其 Sonic Pods 官网页面写的是 2027 年达到 10 吉瓦,而在最新采访中又改口称 2028 年才达到日产 30 兆瓦(年化约 10 吉瓦)。
- 公司宣称开放销售一个月就拿到了价值 10 亿美元、对应超 20 兆瓦的“承诺意向”(committed interest),但这一表述在财务上既不是确认收入,也不等同于打入账户的现金定金或不可撤销合同。
- 风险.对于考虑采购或租赁其算力的 AI 应用团队来说,Runware 的无本地冗余架构虽然把预留算力压到了 0.63 美元/GPU 小时,但必须确认自身的业务能否承受单站点断电时的跨区流量切换延迟;而对于潜在的 B 轮投资人,明年一季度罗马尼亚二厂能否如期投产、那 20 兆瓦意向订单究竟有多少能真正通电并收回现金,才是检验这套造车故事成色的唯一标尺。