连 Rust 图形学社区的领军人物,在 每像素 6 个时钟周期 的硬实时预算面前,也决定把 Rust 放到一边。2026 年 11 月 7 日,Linebender 核心作者 Raph Levien 公布了树莓派 RP2350 复古电脑项目 vic-2350 的文本渲染方案,用自研的 Cortex-M33 汇编语言 symbolasm 配合即时编译(JIT),在仅有 520kB SRAM 的微控制器上跑出了早期 Macintosh 级别的比例字体与字距调整(kerning)。
在演示负载中,这套方案生成 JIT 代码耗时约 21,000 个周期,执行耗时约 42,000 个周期,合计只占 RP2350 单核可用吞吐量的 2.6%。综合下来每像素耗时约 2 至 2.5 个周期,与同类方案 dvhstx 相当;但后者只能显示死板的 14×24 固定字符网格,vic-2350 却塞进了可变字宽和精细排版。
为什么 520kB 内存装不下帧缓冲,却装得下膨胀 10 倍的 JIT
RP2350 主频最高 150 MHz,配有双核 ARM Cortex-M33 和 HSTX 视频输出外设,算力远超 80 年代初的 1MHz 6502 处理器,但 520kB 的片上 SRAM 依然捉襟见肘。如果效仿 Xerox Alto 和早期 Macintosh 建立全屏位图帧缓冲,内存会被瞬间吃光,分辨率和色深都得妥协;如果退回 80 年代终端机的硬件字符 ROM 模式,又只能忍受等宽字体。
vic-2350 选了第三条路,也就是早期游戏机常用的追逐电子束(racing the beam),不建全屏缓冲,赶在显示器逐行扫描的间隙实时合成每一行像素。
这里有一个反直觉的工程账本。常规观念里,微控制器内存太小,最忌讳引入会让代码体积膨胀的 JIT——在这套方案里,JIT 生成的机器码体积确实达到了输入字符串的 10 倍。但 Raph Levien 没有缓存这些机器码,而是做成用完即弃的瞬态编译。
只有当某个文本对象的顶部边界进入当前扫描线(加入活动列表)时,系统才在暂存内存里动态分配空间,花 不到 100 微秒 把字符串编译成机器码;一旦扫描线扫过该文本底部,这块内存立刻释放。比起在双缓冲显示列表里预先展开所有文本,这种随用随编、用完即扔的做法,本质上是拿微不足道的 CPU 编译开销,换取了高达 10 倍的运行态内存压缩率。
为了把字库常驻 SRAM 以免读取 Flash 造成视频停顿,字形存储也做到了极致。所有字符的像素被紧凑打包进同一张宽位图,且严格保证没有任何字形跨越 32 位字边界,确保单次 32 位读取就能拿全一行像素。更绝的是重叠检测:字母 l 直接复用 U 的左半边,数字 0 直接复用去掉中间空白的 (),连 {][} 都能首尾相接,硬生生把示例字库从 1,140 字节压到了 960 字节。
复杂的 OpenType 字距调整则被简化成了位运算。每个字形只配 2 字节的左右边缘特征位向量,在构建显示列表阶段,把前一个字的右向量和后一个字的左向量做按位与(AND),再统计 1 的个数(popcount),算出需要缩进的像素数并插入负间距字符。扫描线实时合成阶段完全不用为排版分心。
深入流水线延迟槽:高级语言的零成本抽象在哪里失灵
很多人好奇,Raph Levien 本人就是 Rust 生态的重要建设者,为什么会在 vic-2350 里直言 Rust 无法满足性能要求,甚至专门写了一门叫 symbolasm 的汇编语言来干这件事?
答案藏在 Cortex-M33 的指令流水线里。在 JIT 生成的最内层循环中,把一个字形的单行像素塞进累加器只需要三条 ARM 指令:ldr 从字库加载 32 位数据,ubfx 提取对应宽度的字形位段,orr 移位后合并到输出寄存器。
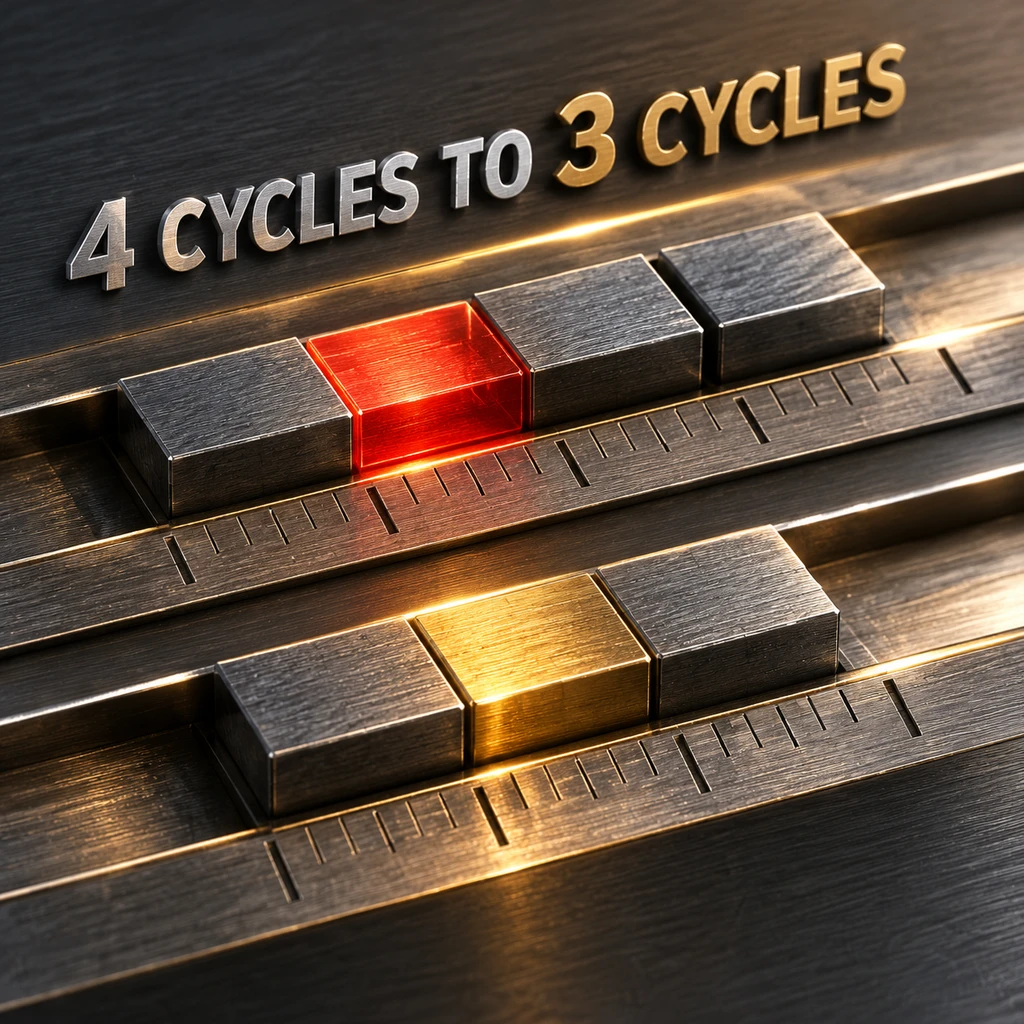
如果按正常顺序写这三条指令,硬件层面会撞上一个隐蔽的墙:ldr 加载的数据无法在下一个时钟周期立刻喂给 ubfx 使用,中间存在 1 个周期的加载使用延迟(result-use delay),导致原本 3 条单周期指令实际要跑 4 个周期。
当算力预算精确到单个时钟周期,编译器的黑盒优化就成了不可控的风险。
为了抠出这 1 个周期,JIT 生成器做了一次跨字形的指令交错调度:把渲染第 i 个字形的最后一条 orr 指令,挪到第 i+1 个字形的 ldr 和 ubfx 之间。这个空档正好填平了流水线延迟槽,硬是把单字形单行的核心渲染耗时从 4 个周期压到了 3 个周期,凭空省出 25% 的算力。
这正是 Rust 等现代系统语言力有不逮的地方。高级语言标榜零成本抽象,但在硬实时像素管线里,开发者需要精确控制 r0 到 r15 每一个寄存器的驻留状态、手动查表拼装 16 位与 32 位混合编码的 Thumb-2 机器码,还要盯着条件跳转指令在未命中时产生的 2 周期惩罚。哪怕 LLVM 后端因为某次寄存器溢出多生成一条访存指令,每像素 6 周期的预算就会直接爆表,画面当场撕裂。
更耐人寻味的是把核心路径压榨到极致之后的算力账单。当 1-bit 单色位图合成快到飞起后,真正的性能大头反而转移到了看似毫无技术含量的第二步:把 1-bit 缓冲区展开成 16 位色深的 RGB565 格式。这一步稳定消耗 1.75 个周期/像素,开销大约是前面 1-bit 位图渲染本身的 3 倍。
《韩非子》里讲,长袖善舞,多钱善贾。现代软件工程习惯了在几吉字节内存和乱序执行大核上挥霍,早已忘记了没有资本时的算法长什么样。但在赞叹手艺精巧之余,这套方案的工程边界也必须看清:
- 结论.瞬态 JIT 为嵌入式 GUI 框架(如 LVGL、Slint)提供了一条新思路,证明在没有全屏帧缓冲的廉价 MCU 上,靠极短生命周期的动态代码生成,完全可以兼顾高分辨率与比例字体排版。
- 风险.该方案目前缺乏与常规无 JIT 位图 blitter 的同构基准对比;2 字节位向量点积仅适用于特定低分辨率位图字体,无法替代真实排版引擎中的复杂连字与文种塑形;且在 SRAM 中动态拼装并跳转执行机器码,对超长字符串越界与指令缓存一致性的安全边界仍缺乏明确文档。
截至 2026 年 11 月 8 日,vic-2350 的代码库尚未放出针对跨 32 位字边界等极端输入的专项测试套件。接下来值得盯紧两个真实变量:一是作者预告的不透明区间遮挡剔除(opaque spans)落地后能否进一步压低多图层开销;二是 symbolasm 会不会从个人玩具演化为 Cortex-M 生态通用的极客工具链。