在大模型开源阵营被中国团队接连刷新标准的关口,沉寂许久的Reflection AI试图用一组夸张的数字打破僵局。其宣布推出首个开源权重混合专家模型Beam,总参数量达5010亿(501B),激活参数仅230亿(23B),预训练吞吐23.8万亿Token,并在逾万张顶级算力卡上完成了超过1亿次强化学习迭代。
官方宣称这款模型在具备顶尖代码与智能体能力的同时,推理计算量较同类模型降低3至4倍。然而,在这场被冠以主权AI反击战的宏大叙事背后,技术社区并未迎来预想中的狂欢。由于发布节点未放出任何可下载权重,且团队头顶过往跑分造假的严重诚信赤字,这次看似惊艳的算力秀,在真正兑现前更像是一张充满公关意味的期货账单。
万卡轰鸣下的能效账本与空仓现实
按照联合创始人Misha Laskin与Ioannis Antonoglou在2026年10月5日给出的口径,Beam是从零构建的大规模稀疏混合专家(MoE)模型,未来计划采用Apache 2.0开源协议。为了打破智能体多步推理的算力瓶颈,Reflection此前与SpaceX签署了算力合作协议,借此调动了多达10500张英伟达GB300 GPU,在长达四周的强化学习训练中完成了超过1亿次Rollout。
这种万卡规模的强化学习在开源领域极为罕见。官方强调,Beam的杀手锏在于极高的推理性价比,凭借23B的精简激活参数,在高级推理测试中能以同级别几分之一的算力代价,逼近甚至匹敌参数规模大得多的顶尖模型。
但在聚光灯之外,开源生态看到的却是另一幅光景。截至发布当天,Reflection在Hugging Face平台上的公开模型数量依然为零,官网既没有附带详尽的模型卡,也没有任何可供下载验证的权重哈希。所谓抗衡业界的开源先锋,目前仅仅停留在博文预告和内测申请表单里。
- 提醒.在模型权重、Tokenizer与完整环境镜像公开并接受第三方验证前,任何单方公布的算力能效与跑分都只能视为商业邀约,不可直接作为生产选型依据。
被剥离的推理开销与真实的基准断层
Reflection所宣扬的推理能效优势,在严谨的技术审计下显得颇为脆弱。官方在测算生成FLOPs时,采取了极简的理论近似公式,只计算了23B激活参数与平均生成Token数,却主动剔除了Prompt预填充开销、上下文注意力计算负荷以及实际服务集群的部署损耗。
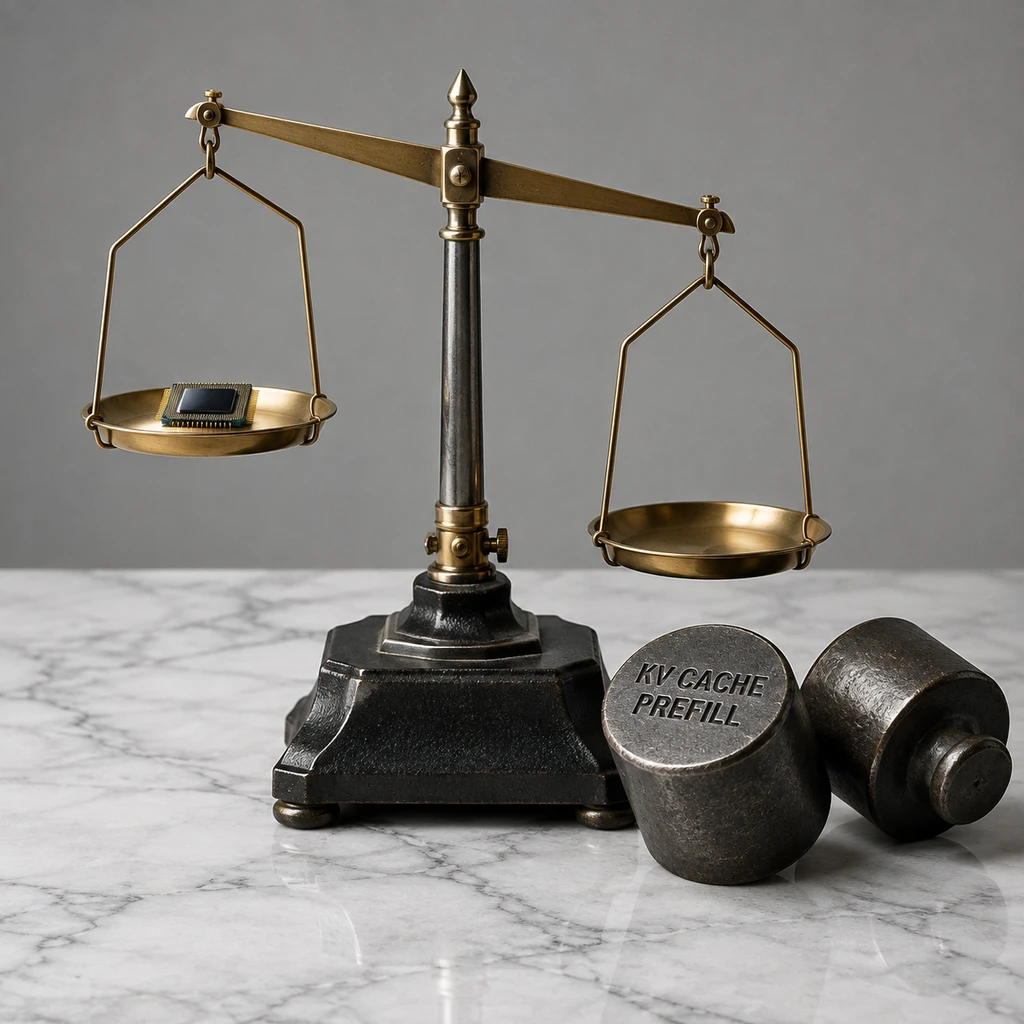
在复杂的智能体编码场景中,决定真实API调用账单与显存占用的关键,从来不是理想状态下的单Token前向计算,而是思维链膨胀所带来的KV Cache驻留与超长上下文管理。一旦把这些真实系统开销纳入考量,剥离了注意力代价的能效神话就会大打折扣。
更直接的差距体现在绝对解决能力上。Reflection官方在评测表中试图展示自身与GLM 5.2的抗衡,但在更严苛的软件工程评测DeepSWE v1.1中,Beam仅取得了44.4分。
与之相对,智谱的GLM 5.3得分达到61.0,月之暗面的Kimi K3录得68.0,而DeepSeek V4.1 Flash更是冲上了74.2。这意味着即便在官方精选的测试集里,Beam在处理长链代码构建与复杂报错排查时,与前沿开源阵营依然存在肉眼可见的代差。抛开绝对解题能力单谈理论推理能效,在工业级代码工程中很难说服精打细算的工程团队。
主权AI包装下,难以摆脱的信任赤字
面对性能上的代差,Misha Laskin在发布时将话语体系转向了地缘政治与安全叙事。他向媒体明确表示,Beam的核心使命是充当主权部署的工作马模型,旨在为西方本土提供抗衡中国前沿开源势力的替代方案,并透露团队正配合英国AI安全研究所(UK AISI)以及美国超级智能创新与标准推进中心进行安全评估。
政治叙事只能为技术买来短暂的宽容,却无法在基准复现时掩盖代码的破绽。
这一套说辞之所以未能迅速平息业界的疑虑,根源在于Reflection无法回避的历史污点。2024年9月,该团队曾高调发布Reflection 70B模型,宣称全面击败GPT-4o与Meta旗下的Llama 3.1 405B。但仅仅数日后,独立评测机构Artificial Analysis与开源社区开发者实测发现,其公开下载的权重实际表现甚至劣于原始的Llama 3.1 70B。那场依靠私有API特殊提示词粉饰跑分、公开发行版本大幅缩水的闹剧,至今仍是开源社区最为恶劣的翻车案例之一。
- 结论.对于企业CTO而言,当前最合理的动作是按兵不动。本月晚些时候官方若能按约定释出完整的开源权重与技术白皮书,且第三方机构在固定无污染测试集上完成同机复现,才是评估其是否值得接入生产管线的真正起点。