由前Salesforce首席科学家Richard Socher创立、估值达46.5亿美元的人工智能初创公司Recursive,正式发布了其首款开源代码大模型Flint。这家今年5月刚刚斩获6.5亿美元巨额融资的企业,将Flint视为递归自进化理论的第一次公开试水:模型总参数约40B,但在执行任务时仅激活2.5B参数,且据称其架构设计、量化与底层编译算子几乎全部由名为Eureka Machine的自动化科研系统自主完成。
Flint以Apache 2.0协议开源,并提供BF16权重及独立量化变体。它让业内兴奋的地方在于端侧脱机部署的高性能承诺,但随之而来的也是现实硬件的冷水。把一个40B量级的MoE模型搬进个人设备,本质上是一场极为激进的系统级工程压缩,绝非普通消费级笔记本能轻易消受的甜头。
48GB统一内存:轻量背后的硬件门槛
在Recursive公布的技术指标中,Flint在搭载M4 Pro芯片的MacBook Pro上跑出了约131 tokens/s的生成速度,短上下文场景下亦普遍高于125 tokens/s,几乎是Google Gemma 4和Nvidia Nemotron 3.5 Lightning等同级模型在同台设备上58至69 tokens/s的两倍。在Nvidia RTX Spark上,该速度进一步突破150 tokens/s。
这一数字确实刷新了本地代码生成的体验,但必须分清计算量与内存墙的界限。Flint采用混合专家(MoE)架构,确切模型结构参数为39.8B总参数,单Token仅激活2.5B。激活2.5B意味着计算核心的瞬时浮点运算压力大减,可这并不等同于显存占用只有2.5B。要在本地完成推理,模型底层的全部40B权重仍需常驻显存。
官方配套的本地推理引擎rec在技术文档中明确标出,本地运行的硬性底线是至少48GB统一内存以及约30GB硬盘空间。媒体测试所使用的设备也是一台配备48GB内存的高规格Mac。这意味着,所谓可以在笔记本上运行,针对的是售价昂贵的专业工作站,普通大众手头的8GB或16GB轻薄本根本无法加载完整模型。
官方测得的131 tokens/s,很大程度上归功于极度深度的工程剪裁。Flint将权重压缩至4-bit,并针对Apple芯片编写了合并decode forward pass的专用Metal算子;在英伟达体系下,NVFP4量化版与16位精度的基准得分差距维持在0.7分以内。这种用算子换带宽的做法把设备压到了极限,换取了端侧的高响应,但它未能打破物理内存容量的硬约束。
跑分狂欢与单方验证的技术盲区
在代码能力基准上,Recursive交出了一份颇具进攻性的成绩单。在业界公认衡量真实软件Bug修复能力的SWE-Bench Verified评测中,Flint取得了74.2%的得分(基于mini-swe-agent且平均pass@1>=5次),并在SWE-bench Pro v2拿下89.7%,Terminal-Bench 2.1拿下54.9%。
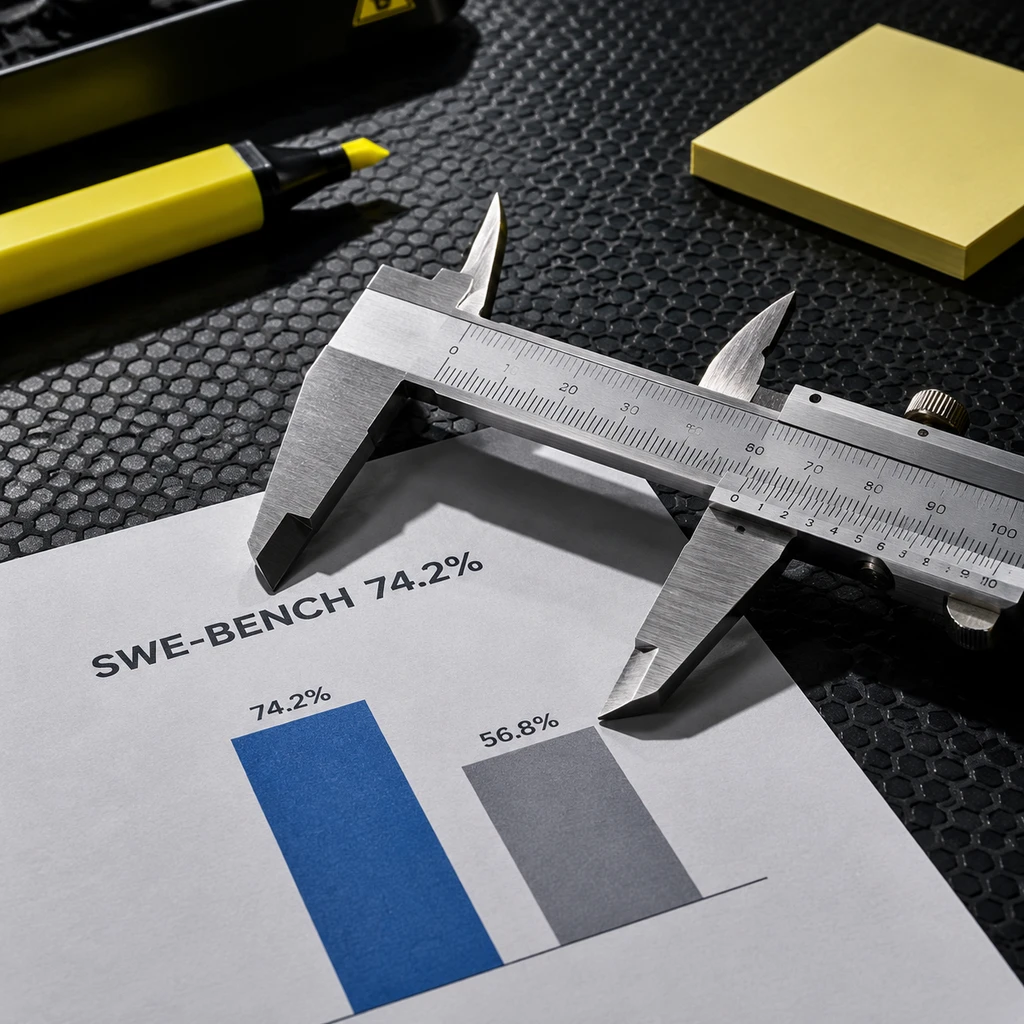
74.2%的SWE-bench高分暂无第三方复现,端侧落地仍需长上下文检验。
Recursive公布的数据显示,在50B参数以下区间的综合均分中,Flint仅次于阿里的Qwen3.8 27B。对于一款能跑在单机上的离线模型而言,这种成绩几乎逼近了部分闭源云端大模型的水平。然而,代码评测向来充满微妙的工程变量。
| 评测维度 / 指标 | Flint (Recursive 官方数据) | 行业同级基准 / 运行约束 | 现实评估与结论 |
|---|---|---|---|
| SWE-bench Verified | 74.2% | pass@1>=5次采样测试 | 尚无第三方无偏差独立复现 |
| SWE-bench Pro v2 | 89.7% | 针对企业级工程环境设计 | 复杂长上下文场景需分步拆解 |
| Terminal-Bench 2.1 | 54.9% | 终端环境综合操作执行 | 依赖 Agentic 框架协同驱动 |
| M4 Pro 推理速度 | 131 tokens/s | 同级竞品仅 58-69 tokens/s | 高度依赖底层专有 Metal 算子 |
当前所有耀眼的对比曲线和跑分,均来自Recursive内部环境的自测披露。在代码智能体领域,Agent循环调用的脚手架差异、Prompt工程微调以及重试策略,都会对SWE-Bench的分数产生数十个百分点的扰动。官方也坦承,Flint在应对大规模工程任务时,需要人类提供更多指引,开发者必须将复杂需求拆解成更细碎的执行步骤。
- 提醒.不要被官方高分直接套算为工程免检凭证,端侧模型在真实几十万行代码库中的跨文件理解力,仍待独立开发者在无辅助环境下的公开检验。
自动化科研管线与自进化神话的距离
比端侧部署更受资本追捧的,是Recursive讲述的AI造AI故事。这家在2026年6月刚刚与AWS签署4.1亿美元算力协议的企业曾放言,算力采购的目的不是堆砌人力,而是扩充智能体规模。Flint正是其系统Eureka Machine在不到四个月内催生的产物。
官方展示的研发清单极具科幻感:更稀疏的结构设计、将体积压缩71%且几乎无损的低比特训练,以及高度优化的专用硬件内核,均来自AI系统的主动探索。然而,若据此认定计算机已经掌握了自我升级的钥匙,则显然高估了现阶段的技术实质。
Eureka Machine此前公开的技术验证,主要展示在高度明确的受限优化任务中,例如将NanoGPT的训练耗时从79.7秒压减至77.5秒。这在本质上是一套工业级的自动机器学习(AutoML)流水线。它依托人类工程师搭建的强化学习沙盒,通过并行跑网格搜索、超参调试与代码合成来加速试错。就连系统设计者也承认,底层逻辑依然在大量借用人类已有开源社区沉淀的先验知识。
脱离人类干预、多代指数级跨越的纯粹递归自进化(RSI),在工程实践中依然面临严重的奖励欺骗(Reward Hacking)与误差自放大难题。Eureka Machine眼下更像是一个不知疲倦的超算助理,而非拥有自主设计意图的机械造物主。
端侧突围与云端账单的拉锯战
Meta此前发布的开源端侧模型Muse Spark Open参数高达816B,即便做了开源,也需要近1TB内存支持,把绝大多数独立开发者拒之门外。Flint的真正价值,是把这场关于端侧编程的实验带回了现实工作站能承受的区间。
对于习惯了向云端代码助手支付昂贵订阅费、又时刻担忧商业代码被云端大模型吸收训练的专业团队而言,一个能吃满48GB内存、无需外部联网、响应速度超过每秒百字的代码引擎,具有极其清晰的商业吸引力。这种吸引力来自成本和合规的双重安全感。
OpenAI此前曾披露其科研智能体记录的工时已达到人类研究人员的3.1倍,整个AI工业界的人效比正在发生质变。Richard Socher和Recursive所押注的方向没有错:由AI代理接管繁重底层的模型超参剪枝与量化编译已是大势所趋。但这属于自动化工程的阶段性胜利,无需过早披上机器觉醒的外衣。
- 结论.对于拥有高配Mac或RTX工作站的工程团队,Flint值得立刻部署以替换部分云端代码补全流程;但在评估其自进化潜力时,不妨多看几代模型迭代的真实谱系。