多数带 AI 标签的记账软件,本质上都在做一件事:把你的每一笔消费记录打包,通过 API 扔给云端的大模型。
Pulse Local 0.4.0 试图逆转这个逻辑。这款刚在社区公开的 Mac 应用,把一个完整的大语言模型直接装进用户的电脑。2.9 GB 的模型包存放在本地磁盘,核心账本完全不离机,号称不需要账号、不采集崩溃日志,连问答推理都在本机芯片上跑完。
天下熙熙,皆为利来。个人财务是数据隐私里最敏感的切口,但在端侧运行大模型算账,远不是一句「为了隐私」那么轻巧。它直面的是大语言模型最致命的弱点——算术幻觉,以及端侧硬件不得不承受的计算代价。
不让模型做算术的精明架构
让语言模型去逐行加减账单,几乎必然导致数字错漏。Pulse Local 聪敏的地方在于没有把整本账单塞进上下文窗口,而是设计了一套极度克制的三层分工。
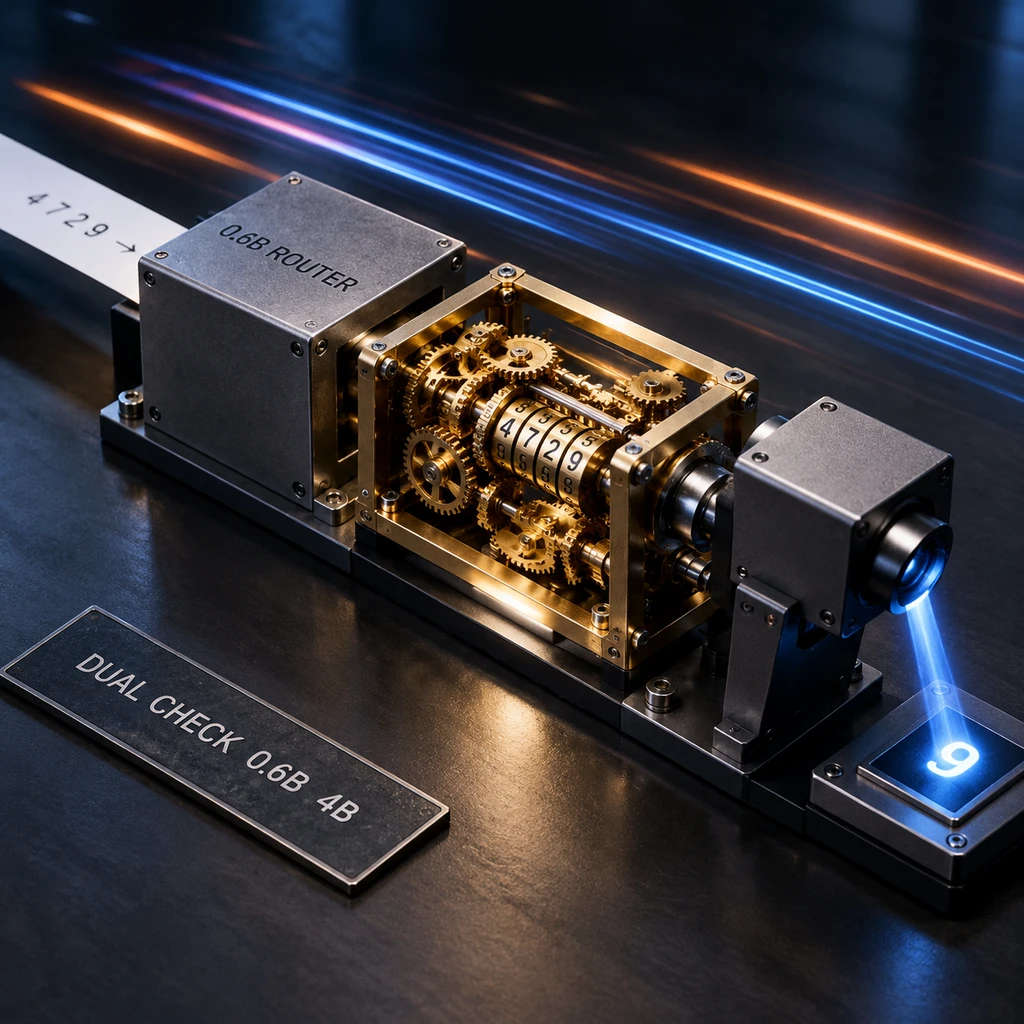
应用初次加载的 2.9 GB 权重并非单一整体。它包含用于意图路由的 bge-small-en-v1.5,一个仅 397 MB 的量化微调模型 Qwen3-0.6B,以及一个大约 2.5 GB 的校对模型 Qwen3-4B-Instruct-2507。
当用户提问上个月在餐饮上花了多少钱时,Qwen3-0.6B 只做一件事:理解自然语言,转译为确定性的结构化查询语句。真正的数值加减、分类汇总完全交由本地原生代码执行。算出的数值再交给 4B 模型做二次校对,确保回答口径与提问对齐。一旦两套校验出现语义冲突,软件会直接声明无法确定,而不是强行给出一个估算值。
根据开发者公开的数据,开启双重校验后,模型在 494 个测试样本中的错误率从约五分之一压到了 5 次。这套做法把语言模型从不擅长的数学运算中剥离,只利用它的自然语言解析能力,是端侧小模型落地垂直工具非常合理的工程范式。
绝对隐私背后的三重代价
技术路径虽然巧妙,但工程永远是一场取舍游戏。要在没有云端服务器支撑的本地设备上跑完这一套管线,用户必须交出对等的系统资源与使用耐心。
最直接的代价是时间。开启 4B 校验后,端侧运行一次完整的查询与复核,耗时在 12 至 14 秒。在云端模型普遍能做到秒级流式输出的当下,等待十多秒去获取一个本可以在报表里点选查到的数字,对于非极客用户而言是一道极高的心理门槛。
其次是硬件门槛。Pulse Local 目前仅支持 Apple Silicon Mac,老款 Intel 芯片不在支持之列,Windows 版本仍在开发中。端侧推理对内存带宽和统一内存的要求,直接划清了适用人群。
模型把算术让渡给代码,换来了准确;用户把计算留在本地,付出了时间。
- 风险.494 个测试用例均出自开发者自测,在缺乏第三方独立基准验证前,小模型面对真实生活里五花八门的交易备注时,实际召回率仍需打个问号。
商业妥协与银行同步的悖论
单机软件的终极理想是与网络完全物理隔绝,但现代个人财务的现实是高度碎片化的银行机构。纯手动导入 CSV 文件的体验,早已被自动化账单习惯彻底抛弃。
Pulse Local 在这里出现了某种妥协式的裂痕。它提供了一个可选的「Sync Pass」服务,通过 Plaid 接入美国银行机构,3 家机构定价 29 美元每年,每增加 1 家加收 8 美元。虽然官方强调交易明细只在服务器内存中转、绝不落盘持久化,但只要数据流经外部节点,不可穿透的技术隔离就退化成了商业信誉承诺。
| 方案 | 核心软件费用 | 银行同步年费 | AI 对话支持方式 |
|---|---|---|---|
| Pulse Local | 自由定价(含 $0) | $29 起 / 年 (Plaid) | 内置 2.9GB 本地模型 |
| Actual Budget | 开源免费 | $15 / 年 (SimpleFIN) | 依赖外部 Ollama 插件 |
| Moneydance | 约 $65 买断 | 约 $40 / 年 (Moneydance+) | 无内置大模型对话 |
这种模式也映射出它的商业考量。软件本体采用自由定价模式,用户可以输入 0 美元免费使用,也可以自愿支付建议的 20 或 40 美元。这意味着团队必须依赖银行同步通道的溢价来维持持续现金流,但受限于 Plaid 的支持范围,这套变现逻辑目前仅在美国市场成立。
- 结论.真正的本地化与自动化财务之间天然存在张力,要么忍受手工导表的摩擦,要么接受向云端开放一道缝隙。
Pulse Local 展现了一种健康的软件趋势:不再迷信参数规模,用小模型各司其职,解决高隐私垂直领域的真实问题。但它也清晰地画出了边界——当用户为了绝对的安全感把模型锁在机箱里,就必须学着接受十几秒的沉默等待,并重新拾起对数字的耐心。