分布式训练起家的 Prime Intellect,把手伸向了生产级推理市场。
2026 年 10 月 2 日,团队正式上线统一推理平台 Prime Inference,入口设在 api.pinference.ai。官方抛出的运营数据非常吓人:平台日均处理的 Token 量已经接近 1 万亿。服务全面兼容 OpenAI 协议,分成了 Serverless 弹性端点与 Reserved 预留算力两种形态,首发重点直接押在支持 100 万上下文窗口的开源旗舰模型 GLM-5.3 上。
很多开发者下意识以为这又是哪家云厂商把开源框架简单套壳拿出来卖。实际翻开底层的工程堆栈会发现,这不是一次常规的资源倒卖,而是针对百万上下文 Agent 频繁读写前缀瓶颈的一次重构。但在光鲜的指标背后,随之而来的计费暗坑与架构双轨机制同样不容忽视。
把显存拆开卖:长上下文推理的物理手术
大模型推理的技术重心正在从通用高并发转向超长上下文的多轮调用。过去由 Fireworks AI 主打极限吞吐、Together AI 专注隔离实例、Modal 按秒计费的格局,在面对百万级上下文推理强化模型时都遇到了共同的瓶颈:显存里的 KV 缓存会被长会话迅速吃满。
Prime Inference 选择在 Blackwell 硬件迭代期切入,将底层基础设施架在 GB200 NVL72 集群之上。工程的核心改动在于两点:Prefill 与 Decode 解耦,以及引入基于 Mooncake 的 GPU 外部 KV 缓存存储系统。
输入阶段的提示词处理属于计算密集型,生成阶段的自回归输出属于访存密集型。两者绑在同一张卡上,就会互相拖累。通过解耦,GLM-5.3 在单会话支持 1,048,576 上下文与 131,072 输出长度的环境下,P90 逐字延迟降低了约 40%。
在 66 个并发会话压力下,官方测得单用户输出速度保持在约 101 tokens/s。配合前缀感知路由算法与底层 NVLink 级连续健康检查,超长文本反复调用公共 System Prompt 时的缓存命中率大幅上升,首字响应时间不再线性暴增。
官方宣称,自 2026 年 9 月 22 日在 OpenRouter 灰度部署 GLM-5.3 以来,平台不仅保持了 100% 正常运行时间,还利用结构化语法约束,解决了未声明工具调用被丢弃与 HTML 转义字符损坏等解析漏洞,实现近乎为零的调用报错。
算力账单的明面与暗面
技术指标相当惊艳,但把视角切回真实的商业采购,事情就变了味道。
最大的落差在于价格透明度。当前主要的算力服务商都有明晰的硬件租赁与调用基准:
| 平台 | H100 裸机价格 | H200 裸机价格 | B200 裸机价格 |
|---|---|---|---|
| Modal | $3.95/hr | $4.54/hr | $6.25/hr |
| Baseten | $6.25/hr | 暂无公开 | 暂无公开 |
| Replicate | $5.49/hr | $5.49/hr | 暂无公开 |
| Fireworks | $8.00/hr | $8.00/hr | $13.00/hr |
Prime Inference 至今没有公布标准统一的每百万 Token 定价明细表,目前仅支持按模型目录预充值余额扣费。
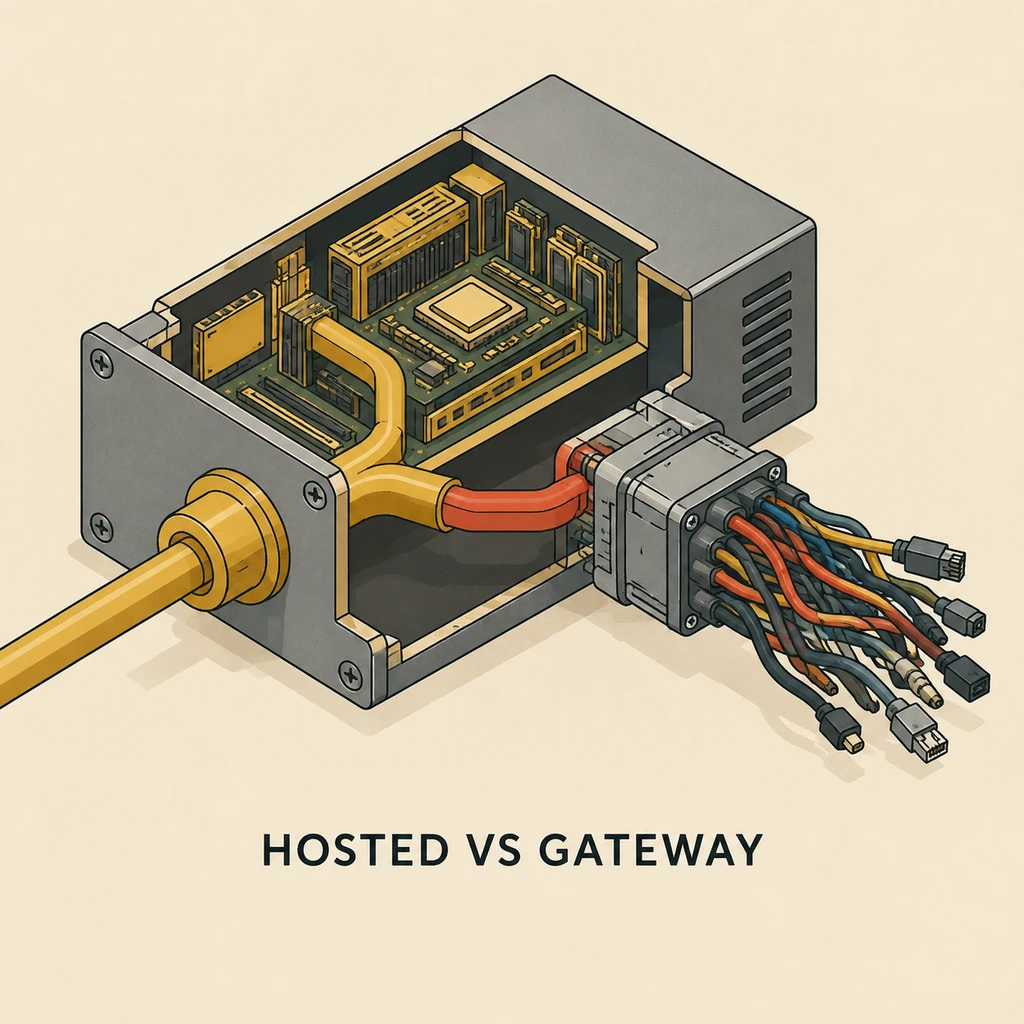
更值得关注的是其底层的双轨架构设计。在其统一的 API 端点下,实际上暗藏两套完全不同的执行路径:一种是 Prime 自建集群承载的 Hosted 模型,另一种是直接代理转发至第三方的 Gateway 路由模型。
对外暴露的是一个统一入口,但内部到底是自建硬件处理,还是外包转接,两者在数据合规、网络时延抖动乃至可用性承诺上存在隐性差异,企业客户很难追溯具体请求的真实链路。
更细微的计费陷阱藏在鉴权逻辑里。调用 API 时,如果系统请求头里没有显式注入 X-Prime-Team-ID,系统不会自动关联企业工作空间,而是静默扣减发起者的个人账户余额。一旦个人账户见底,请求就会立刻抛出资金不足异常中断服务。
- 风险.统一 API 抹平了 Hosted 与 Gateway 的底层边界,将外部路由封装在自研叙事内,给对数据隐私敏感的企业用户埋下了审计隐患。
战报好看,但算力不是一次性测验
天下熙熙,皆为利来。推理服务商争相秀肌肉,本质上是想在存量 Token 市场里切蛋糕。
跑分是一瞬间的单科测验,而推理账单是按月结算的生存耐力赛。
Prime 宣传的 OpenRouter 最快纪录、零错误率以及 100% 在线时间,统计区间仅仅是从 9 月 22 日到 10 月初这短短十天左右的窗口。拿特定硬件、特定模型在受控流量下跑出的单点极限,替代多租户高负载下的常态表现,是行业惯用的营销手法。
更深层的信任疑问来自团队过往的分布式验证机制。技术社区此前对其去中心化协议 TOPLOC 在防作弊与节点数据完整性方面的安全性提出过质疑。当同一团队转向集中式的生产推理云时,如何证明多租户隔离、高并发防作弊与算力计量完全可靠,依然缺乏独立第三方的长期压力评测。
更何况,低 GPU 租金从来不等于低 Token 成本。Modal 的 B200 租金只要 6.25 美元每小时,Fireworks 报出 13 美元每小时,但后者的批处理密度与投机解码往往能摊平单 Token 开销。Prime 隐去核心 Token 定价,只展示硬件利用率与峰值吞吐,把真正的成本核算推给了开发者。
长序列推理的架构优化确实打中了 Agent 开发者的软肋。但真正能把客户留下来的,从来不是公关稿里的万亿口径,而是高并发冲垮节点时的容灾硬实力,以及敢于明码标价的商业坦诚。