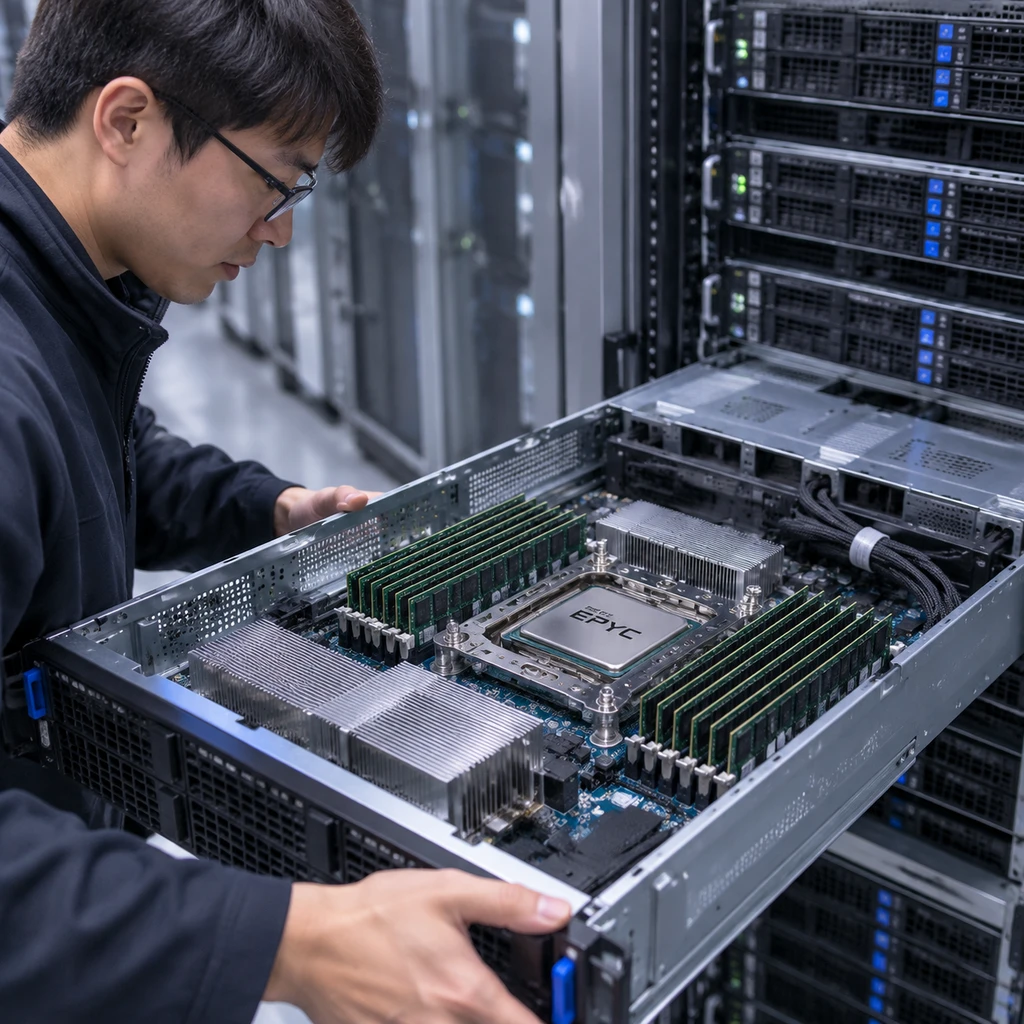
监控面板上 100% 的 CPU 使用率,往往是基础架构里最昂贵的障眼法。2026 年 10 月 28 日,数据库引擎团队 Pivot 的作者 Maor Kern 发表了一篇副标题为“通过做更多(CPU!)工作让 GROUP BY 更快”的实测文章,直接拆穿了这个假象。在面对千万级唯一键的聚合查询时,看似满负荷运转的处理器其实大部分容量都在原地发呆,等待慢如蜗牛的主存喂数据;而破局的办法反而极其反直觉:故意给 CPU 增加近七成的指令工作量。
为了看清底层硬件到底在干什么,测试绕开了屏蔽底层性能计数器的 AWS 和 GCP 公有云虚拟机,直接租用 CherryServers 的裸金属服务器(搭载 AMD EPYC 9124 Genoa 处理器,16 核,128 GB DDR5 内存)。在绑定单核、对 ClickBench 的 hits 数据集(约 9900 万行数据,包含约 1700 万个唯一 UserID)执行最朴素的 HashMap 分组聚合时,首次运行耗时 3.9 秒,页缓存预热后的二次运行耗时 3.6 秒。在 4.03 秒的 perf stat 采样运行中,高达 50.1% 的流水线槽位卡在内存停顿(backend_bound_memory)上,真正完成微操作退休(retiring)的有效工作比例只有可怜的 16.1%。
400 条指令的鸿沟与“赔本赚吆喝”的算力账
为什么操作系统显示 CPU 100% 满载,它却在摸鱼?因为 Linux 只要发现有任务需要 CPU 时间,就会把核心标为非空闲,哪怕处理器内部正卡在主存读取上动弹不得。
现代 CPU 每纳秒可以吞吐 4 到 8 条指令,访问贴在核心旁边的 L1 缓存(约 64KB)只需约 1 纳秒,L2 缓存(约 1MB)要 3 到 4 纳秒,L3 缓存(最高几百 MB)要 10 到 15 纳秒。一旦数据不在缓存里,穿透到 DRAM 主存,延迟立刻暴涨到 50 至 100 纳秒。这相当于 CPU 本可以一口气跑完 400 到 800 条指令的时间,全部用来干等一次内存返回。当 1700 万个唯一键撑爆缓存容量,几乎每一次哈希表查找都会沦为穿透到 DRAM 的冷命中,单次查询硬生生从主存按需拉取了 4.5GB 数据(约 7619 万次 64 字节缓存行填充)。
为了填平这道鸿沟,Pivot 在测试中换上了基数分区(Radix Partitioning)算法:第一阶段先算哈希,取高 12 位把数据切进 4,096 个独立分区;第二阶段再逐个分区建小哈希表做聚合。
表面上看,这完全是脱裤子放屁。数据不仅多走了一遍内存写入,CPU 退休微操作总数更是从 114.3 亿次暴增到 193.5 亿次。但算力经济学的账不是这么算的:切成 4096 份之后,每个工作哈希表小到足以塞进 CPU 缓存。结果预热后的查询耗时直接从 3.6 秒降到 2.7 秒,内存停顿槽位占比砍半至 23.5%,DRAM 按需拉取量更是从 4.5GB 骤降到 1.5GB。而在加上完整的引擎优化后,Pivot 单核跑完同一查询只需 1.848 秒(DRAM 按需拉取降至 954MB),16 核全开更是直接压进 171.773 毫秒。
别把基数分区当银弹:工业界的暗战早换了战场
这篇博客在 Hacker News(编号 50291570)上只拿到 2 分、零评论,冷清得有些可惜。但如果只看完原文,你很容易带着一个“遇到大表就切小塞缓存”的单线程结论离开,而漏掉工业界真正的深水区博弈。
算力过剩的时代,最蠢的优化是省指令,最赚的买卖是用指令换延迟。
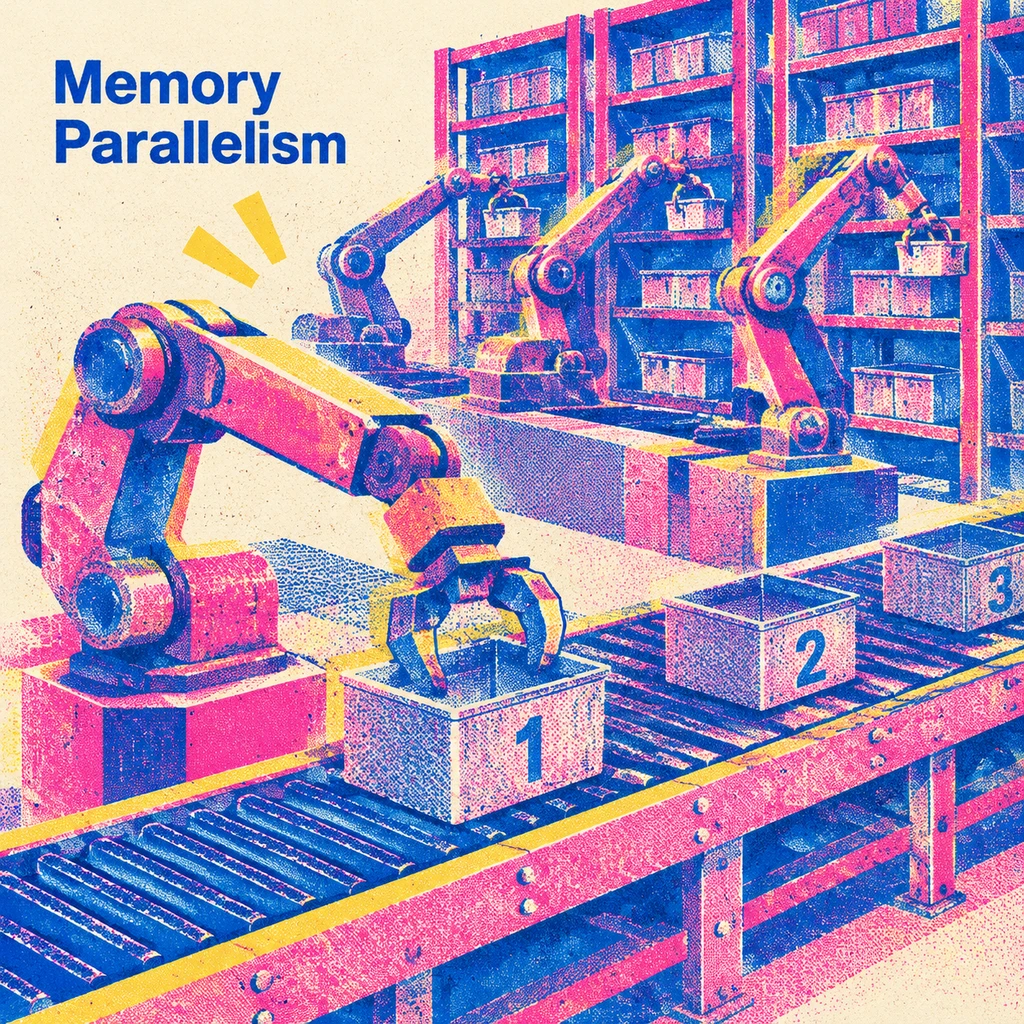
《孙子兵法》讲“以迂为直”,基数分区靠绕远路赢了时间,但它绝不是高基数聚合的唯一银弹。原文为了教学直观,把内存延迟简化成了“50 纳秒等于干等 400 条指令”的纯串行账,却在正文里轻轻带过了现代处理器的内存级并行(MLP)能力。实际上,只有上一条没读出来就不知道下一条地址的依赖性指针追逐,才会老老实实吃满全部延迟;如果能把独立的内存请求重叠起来,根本不需要大动干戈改数据布局。
2026 年 8 月 13 日提交的 ClickHouse Issue #114638 就是一个极硬的反例。在 96 核 AArch64 机器的热运行测试中,工程师仅仅通过预先计算哈希值并执行桶预取(bucket prefetching),让 CPU 在处理当前行时提前把未来几行的哈希桶拉进缓存,就把 ClickBench Q16 的耗时从 326 毫秒压到 209 毫秒(提速 1.53 倍),Q18 从 487 毫秒降到 387 毫秒(提速 1.25 倍)。
更残酷的边界在于,当唯一分组数几乎等于总行数,或者聚合状态极宽时,分区的搬运开销反而会反噬性能。这也是为什么主流列式引擎都在搞复杂的动态混合装甲:
| 引擎与方案 | 核心工程策略 | 实测表现与边界条件 |
|---|---|---|
| DuckDB (2024 外部聚合) | 小型固定线程局部表预聚合 + 可落盘分区元组存储 | ICDE 2024 论文 32GB 内存限制下跑完最大宽分组负载 |
| ClickHouse (26.8 / 26.9) | 自适应局部聚合与跨线程哈希分发 + 统一 L2 临界点预取 | 23.11.1 曾因内存超限在极宽负载中止,但在中等规模宽负载更快 |
| 并发全局哈希表 | 理想基数估计 + 合适表大小的专用无锁/并发设计 | 论文《Global Hash Tables Strike Back!》证明可匹敌甚至反超分区法 |
看着各家引擎在 L2 缓存临界点(如 ClickHouse 26.9 刚刚对齐的预取激活阈值)上精打细算,你就会明白:单靠一招基数分区吃遍天的日子早就过去了。
读懂硬件计数器,先避开三个测量陷阱
Pivot 这篇实测之所以值得数据库内核与 FinOps 团队细读,不仅在于它展示了裸金属调优的威力,更因为它在无意间暴露了性能工程师最容易踩的三个指标陷阱。
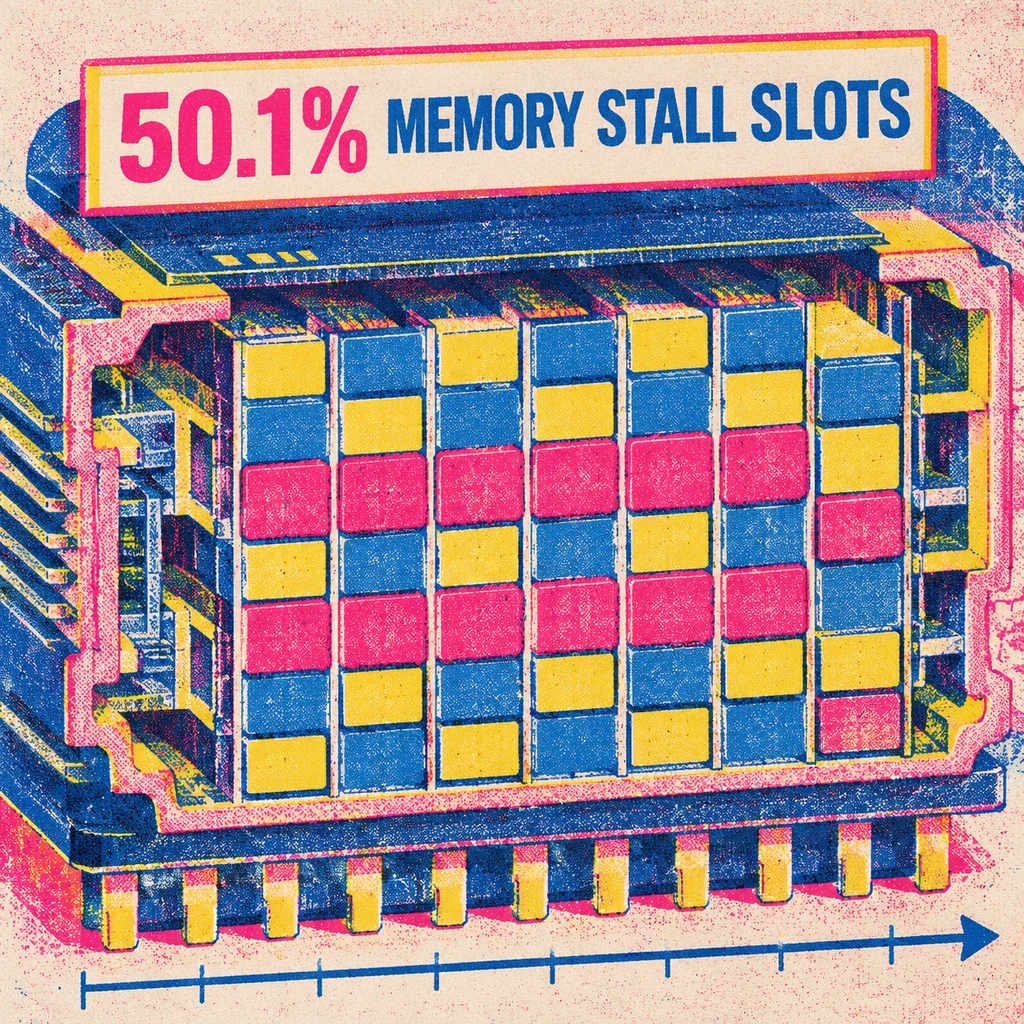
原文在解读 perf 结果时,直接把 50.1% backend_bound_memory 翻译成了“50.1% 的时间里 CPU 在等待内存”。这在日常聊天里无伤大雅,但在微架构剖析上是典型的概念混淆。按照 Intel Top-down 微架构分析方法,这个百分比统计的是超标量处理器的流水线槽位(Pipeline Slots)容量占比,而不是物理挂钟时间(Wall-clock time)。一颗现代核心每个周期能发射多个微操作,槽位停顿过半,不等于物理时间刚好浪费了一半。
同样需要留心的是测试口径的微小错位。原文对比优化前后的预热查询耗时是 3.6 秒对 2.7 秒,但贴出来的 perf 硬件计数器采样运行时间却是 4.03 秒对 3.58 秒;而且其统计的 DRAM 流量只抓取了按需填充(demand fills),明确排除了硬件与软件预取流量,并不能代表内存控制器上的全部带宽消耗。
- 提醒.云原生团队看着监控面板上 100% 的 CPU 告警就签字扩容算力,本质上是在为低效的内存访问买单;而公有云虚拟化隐藏底层硬件计数器,更让无数基础架构团队失去了看见这层真相的眼睛。
回到文章开头那个问题:当你的数据库 CPU 飙到 100% 时,它到底在干什么?如果内核没有做好缓存分区与内存预取的自适应平衡,它大概率只是在用最贵的计算核心,排着最慢的内存长队。