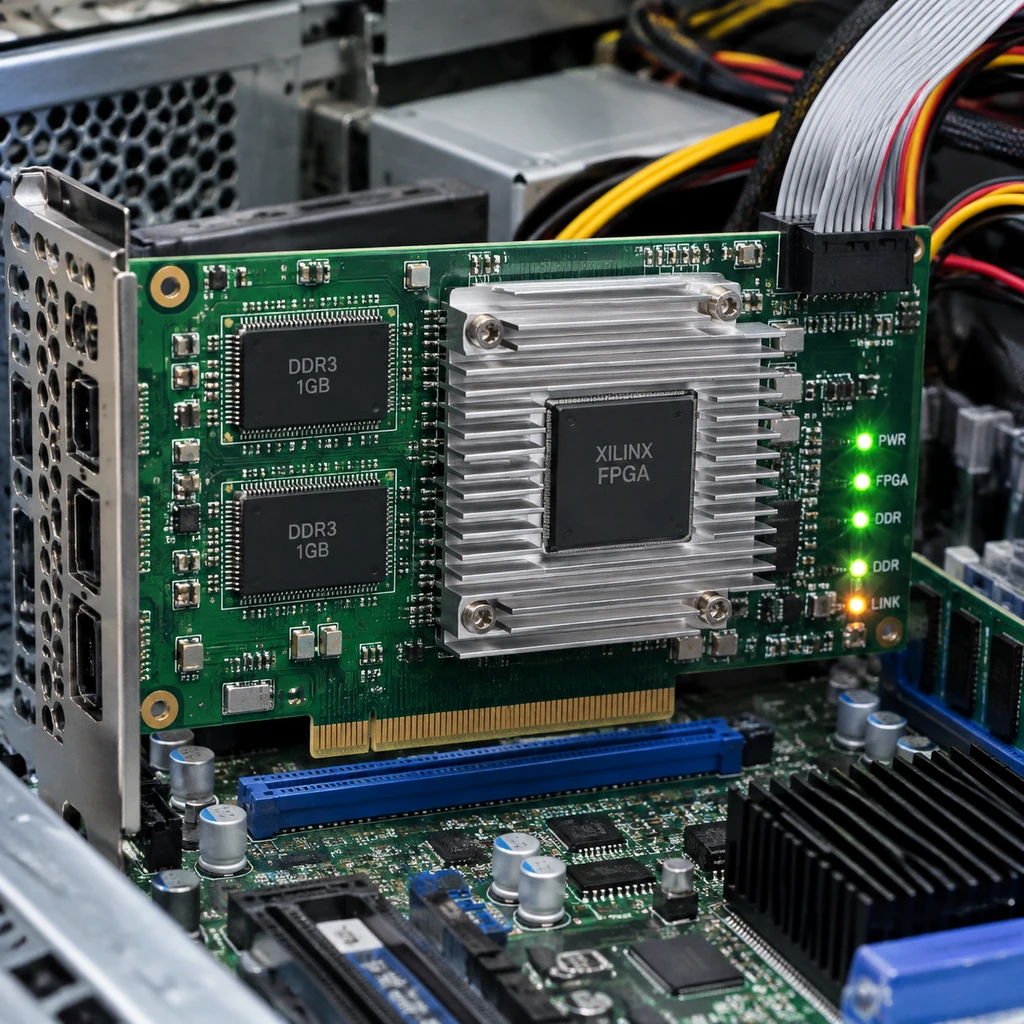
开发者 Felipe Sens Bonetto 近日开源了名为 openTPU 的硬件项目,宣称这是业内首个由 AI 代理全栈开发的开源 AI 加速器。在单体代码仓库中,项目完整覆盖了 SystemVerilog 编写的硬件逻辑(RTL)、专用指令集(ISA)、位精确软件模拟器、算子编译器乃至驱动程序,并在二手市场上售价仅约 80 美元的浪潮老旧板卡上,成功运行了 Qwen3、Qwen3.5 与 LFM2.5 等 10 款主流开源大模型。
这并不意味着通用芯片设计工业迎来了无人干预的奇点时刻。穿透社交媒体上对机器自造硬件的狂热叙事,openTPU 的真正价值不是算力能效超越了英伟达,而是人类工程师通过构建一套防作弊闭环验证流水线,首次证明了 AI 代理能够在极其廉价、陈旧的物理平台上,走通一条从高层算子到物理引脚咬合的全栈硬件工程路径。
80美元板卡上的带宽奇迹与现实落差
openTPU 选择的物理载体是一张极具草根色彩的硬件:浪潮 Inspur YPCB-00338 加速卡。这块卡搭载了十年前制程的 Xilinx Kintex-7 芯片与双通道 DDR3 内存,原本是服务器市场淘汰的边缘料件。项目在此硬件上成功加载真实权重,驱动包括 Qwen3.5-0.8B、Phi-4-mini 及 Gemma 4 在内的模型,硬件端生成的每一个 Token 与软件模拟器保持着逐位对应(bit-for-bit)的严格一致。
在实测表现中,系统针对大语言模型自回归生成的内存瓶颈,展现出了极高的硬件调度效率。借助定制的 LiteDRAM 控制器,该设计在 133.33 MHz 的时钟频率下,将 DDR3-1066 的传输效率压榨到了理论上限(17.1 GB/s)的 82% 至 94%。在内置评测脚本 tools/bench_llm.py 的标准扫描中,项目历经 88 次硬件逻辑仿真与基准验证,并在实体板卡上通过了包含内存校准、链路自检以及持续 180 秒热浸测试在内的 34 项硬件测试,全部维持零失败记录。
需要厘清的是,该项目与加州大学圣塔芭芭拉分校早前基于 Python 硬件生成框架 PyRTL 构建的教学项目 UCSBarchlab/OpenTPU 没有任何代码关联,属于完全独立的研发成果。后者的重点是复刻早期张量处理器的结构形态,而 Felipe Sens Bonetto 的目标则是检验现代代码生成模型在缺乏专属物理流片资源时,究竟能否打通从高级语言到底层硬件的全套链路。
防作弊沙箱:把AI关进形式化验证的牢笼
许多技术讨论往往将 openTPU 归功于大模型的所谓微架构灵感,这忽视了其背后的工程约束。openTPU 的核心思想沿袭了作者此前针对 RV32IM 处理器发起的自动化微架构竞赛框架 auto-arch-tournament。在这套体系中,AI 代理并非在一个毫无限制的空白画布上挥毫,而是被关进了一个人类精心铸造的工程沙箱。
为了防止编码代理在优化过程中走捷径,自动化体系设计了严密的防御机制。AI 仅被允许在独立的 Git worktree 中修改硬件逻辑代码,无权触碰形式化验证套件、基准模拟器以及 EDA 工具的时序约束文件;系统利用文件指纹校验随时监控环境完整性,杜绝模型通过修改测试用例来虚报性能。
决定自动化硬件生成上限的不是生成模型本身,而是人类给它套上的防御性验证边界。
但这套机制并非无懈可击。为了在有限的算力内快速收敛,底层架构在形式化验证的覆盖范围上作出了明显妥协。在基准验证中,框架使用名为 ALTOPS 的简化算子替代了真实的乘除法计算,仅用以验证控制流水线与数据旁路逻辑,并没有在数学层面上形式化证明乘除法运算模块本身的算术准确性。系统的计算正确性,实质上是退回到传统的定向测试与硬件协仿真来做兜底。
- 提醒.代码仓库缺乏针对人类介入程度的消融实验,没有提供工时记录与代码修改占比,无法证明该项目脱离人类资深架构师指导后仍能独立复现。
消失的时序冗余与低置信度的功耗神话
任何将 openTPU 视作商用级加速器的想法都是危险的。将陈旧板卡推向性能极限的同时,该项目几乎耗尽了所有工业级的工程冗余。
在 133.33 MHz 的时钟约束下,整个电路设计的时序收敛到了令人心惊肉跳的临界状态:其最差建立时序裕量(WNS)仅剩下 +0.032 ns,最差保持时序裕量(WHS)更是低至 +0.016 ns。在集成电路工业中,数十皮秒的冗余意味着这套电路只能在特定的温控环境下勉强跑通,一旦芯片遭遇现实中的供电电压抖动、环境升温或半导体工艺角偏差,整套计算逻辑将不可避免地面临建立时间违例。
功耗方面同样存在认知落差。虽然项目公开了基准版本约 8.89 W、四列阵列强化版本约 9.53 W 的数据,但代码库明确保留了 Vivado EDA 工具的软件评估标记:由于未导入真实的物理开关翻转率(Switching Activity),这些功率数据被明确定义为低置信度估算,并非实际整板物理功耗。目前项目尚未提供在同等变量下对比现代 x86 处理器运行 llama.cpp 的实际每瓦吞吐数据(tok/s/W)。
- 结论.openTPU 并非英伟达的平替,它的突破性完全体现在工程研发的组织形态上——它抹平了从编译器到门级电路的协同断层。
硬件研发的核心成本向来不是代码编写,而是验证闭环与跨栈对齐。传统定制硬件开发通常需要编译器开发、数字逻辑设计与驱动工程师多方协同数月,而 openTPU 凭借单个代码仓库,打通了从上层 Python 算子到物理板卡的完整逻辑链条。对于边缘计算初创团队与个人极客而言,定制专用硬件的研发启动门槛正在被系统性凿穿。