开放网络自诞生起维系了三十年的朴素默契正在被单方面撕毁:爬虫爬取内容以换取搜索流量,内容方靠流量获得商业变现。2026年9月,《纽约时报》等出版商诉微软与OpenAI的版权侵权案中解密了一批核心卷宗,撕开了这场博弈最残酷的一角:两家巨头在产品立项之初就已推演过这一走向,微软内部甚至直接将这种生态崩塌定义为毁灭循环。
这不是技术演进无意造成的附带损伤,而是一场巨头在完全知情、精准测算过后果之后的既定推进。
算清账后的知情推进
解密卷宗里最刺眼的并非原告方的控诉,而是被告自身高管的定性。微软应用科学总监在内部交流中直言,AI大规模摄取创作者内容可能是人类历史上最大规模的劳动力盗窃,并指出若以此主张合理使用,将彻底沦为笑柄。
与此同时,OpenAI的高管也在内部记录中承认,其产品对出版商内容具有大幅替代性,且随着模型能力的提升,这种替代性还会进一步加剧。
微软官方随后紧急切割,称这些言论只是个别员工的前瞻学术观点,并不代表公司立场。但卷宗中的数据比修辞更冰冷:微软自身测试显示,Bing聊天机器人给出版商带来的点击率,比传统Bing搜索低了83%至93%。
一边在法庭动议里辩称产品未对媒体流量产生负面影响,一边在内部系统里记录着九成点击的蒸发。这种口径上的剧烈撕裂,彻底暴露出巨头在商业利益与生态责任之间的真实取舍。
流量剪刀差与归零危机
这场生态危机的本质,是旧有分发契约的实质性破产。以往搜索引擎是连接人与网站的跳板,现在的AI搜索则把跳板直接改建成了终点站。
第三方机构与基础设施服务商的监控数据完整印证了这一点:
- Pew研究表明,在带有AI摘要的搜索结果中,用户点击传统网页链接的比例直接从15%腰斩至8%,而AI摘要内部标注的引用链接,点击率仅有约1%。
- Similarweb统计估算,AI搜索摘要上线后,新闻媒体的自然搜索流量整体下降了26%;尽管来自ChatGPT的推荐流量增长了25倍,但因基数极小,根本无法弥补缺口。
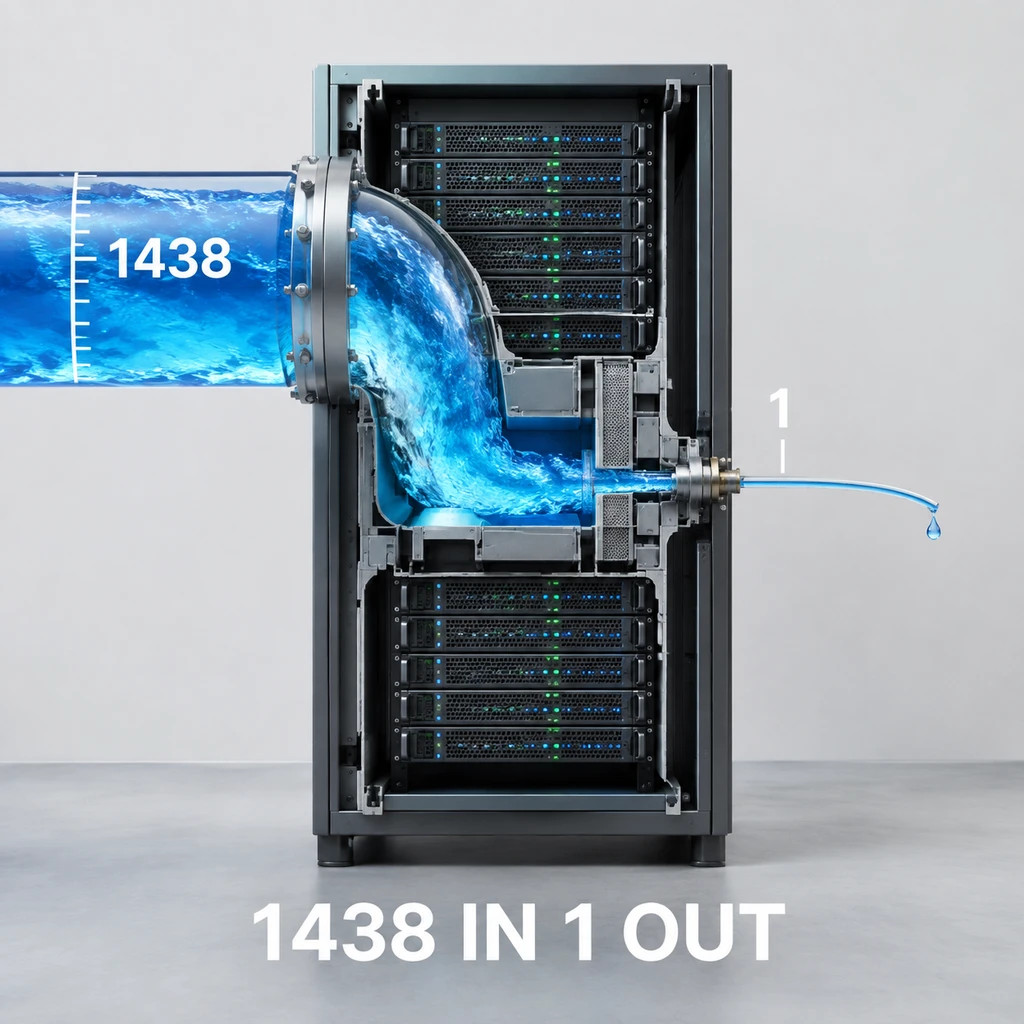
更触目惊心的是资源索取与回报之间的倒挂。网络安全与基础设施机构Cloudflare在2025年1至7月统计了各大爬虫的页面抓取数与带回访客数之比:
Google虽然也在截留流量,但抓取近12个页面尚能还回1次点击;而OpenAI每抓取1438个页面才向内容源输送1个访客,Anthropic的比值更是夸张到了接近15万比一。
所谓信息互联的公社契约,变成了单向抽水机。
内容站点的带宽与算力成本由站长承担,生产原创内容的人力由出版机构支付,而由此产生的商业价值与用户时长,却全部沉淀在了AI公司的对话框内。
虚假的选择权与公地悲剧
面对侵权质疑,科技巨头常拿出的防御理由是:我们遵守了robots.txt,出版商完全可以选择屏蔽爬虫。
这是一种典型的虚假选择。2026年一项针对10个主流AI助手的对照研究显示,robots.txt协议存在广泛的执行漏洞,部分助手不仅不遵守规则,甚至会在模糊User-Agent标识、甚至完全不请求协议文件的情况下强行抓取受限内容。技术防线在工程实现层面已千疮百孔。
退一步讲,即便协议完全生效,现实中的囚徒困境也让创作者无路可退:彻底屏蔽爬虫,意味着在未来的信息检索入口中彻底隐形;放任抓取,则面临千倍回报比的吸血剥削。
更为关键的是,这种权力结构正在走向严重的割裂。截至2025年1月,OpenAI虽然已与近20家媒体机构达成直接授权合作,覆盖了160多家新闻机构,但这笔过路费只流向了极少数拥有谈判筹码的头部媒体。数以百万计的独立博客、中小型专业媒体和垂直论坛,既拿不到商业授权费,又无法阻挡自身数据被打包清洗。
- 风险.当原创内容的生产通道无法获得经济回流,高质量信息源的收缩将不可逆转,互联网将迅速被低成本的AI生成垃圾填满。
巨头在早期为了抢占入口份额,选择对生态代价视而不见。但毁灭循环从来不是单向的。
古人讲竭泽而渔,岂不获得,而明年无鱼。大语言模型能力的基石是人类文明沉淀下来的高质量语料。当写作者因为断流而离场、新闻机构因亏损而收缩、深度调查被AI摘要彻底洗白,开放网络这片公地便不可避免地走向荒芜。
当池塘里的活水被抽干,下一代大模型面对着由上一代模型反复蒸馏出的合成垃圾数据时,这堵被巨头亲手推倒的生态多米诺骨牌,终究会倒在他们自己的服务器机房门前。