OpenAI在2026年10月19日公开了一组针对低资源编程语言的评测数据,GPT-6 Astra在20种语言从零构建数据库引擎的测试中拿到87.4%的平均通过率,GPT-6.1 Sol在COBOL迁移任务里更是冲到了97.9%。不少人第一反应是,那些运行了半个世纪、连原作者都已不在人世的银行核心系统,终于能被AI一键打包重写了。
事情远没有这么简单。
全球至今仍有超40%的在线银行系统、80%的线下信用卡交易和95%的ATM交易跑在COBOL上,气象预测与核安全分析则靠Fortran托底。这类语言在开源社区的训练语料极少,但牵动的资产规模惊人。大模型厂商把战火从高频的Python和JavaScript引向这些古老深水区,商业逻辑极顺:谁能啃下传统政企的遗留系统改造,谁就能切下企业级市场最肥的一块预算。
MultiLangBench测出了什么
OpenAI开源的MultiLangBench,核心逻辑是用一套标准接口衡量多语言工程能力。它要求模型在指定语言中从零构建一个与SQLite 3.40.1兼容的数据库引擎,通过共享数据库文件的输入、操作与验证查询,在60秒超时阈值内验证语法之外的语义一致性。
在单样本API成本从3.48美元降至0.77美元(降幅约78%)的同时,低成本模型GPT-6 Luna拿到了40.3%的通过率,而旗舰模型GPT-6 Astra在20种语言里平均冲到了87.4%。即便在最吃力的COBOL上,Astra也从前代的10.9%跃升至72.1%,Fortran从21.4%提至83.5%,Visual Basic从27.5%提至89.4%。
但高分背后藏着严苛的限定条件。MultiLangBench虽然从SQLite官方约51,000个Tcl测试中转换了约24,000个用例,但其推荐评测子集仅为272个用例。87.4%代表模型能通过这套选定的功能性SQL测试,这与SQLite官方声称的严苛分支覆盖完全是两个维度的概念。
更关键的是测试环境的细节。MultiLangBench的初始化脚本中,默认直接执行退出拦截,评测者需要手动解除安全拦截,才能彻底清理运行环境里预装的SQLite嵌入式副本。加之仓库文档并未披露去污染审计流程,历史悠久且完全公开的SQLite测试代码,是否在预训练阶段就被模型吸收过,目前仍缺少独立的第三方交叉验证。
跑分跨越的是语法壁垒,遗留系统最硬的骨头却是未落于纸面的业务惯性。
定点数截断与隐式规则的暗礁
COBOL代码迁移之所以让人望而生畏,从来不是因为语法结构晦涩,而是因为业务逻辑深嵌在极细微的语言特性里。
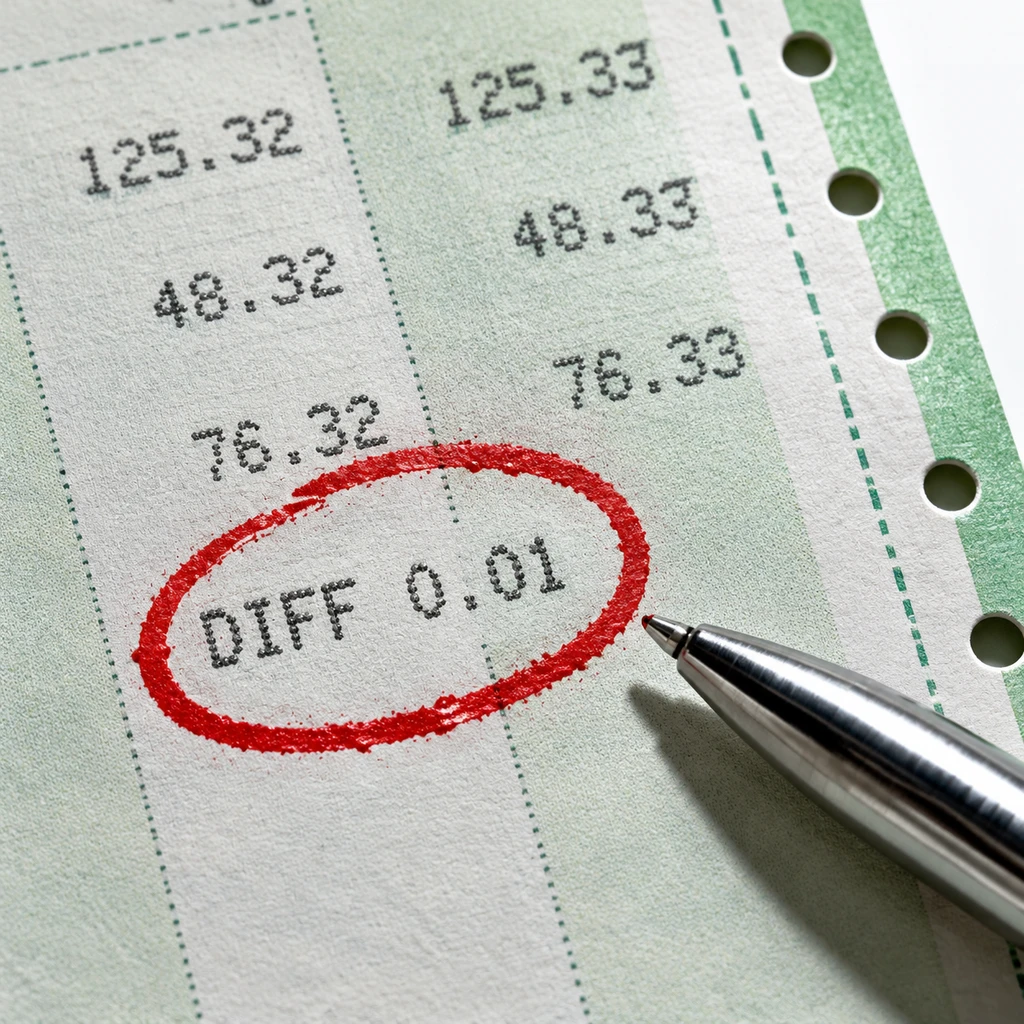
在金融计算中,COBOL的定点算术在未显式声明舍入时,会直接丢弃多余小数位。如果模型在转写为Java或Python时,自作聪明地套用了通用浮点数四舍五入,整套代码在语法上完全跑得通,却会在几百万笔交易后产生致命的财务差错。
OpenAI这次在COBOL迁移任务中设计了严苛的隐藏测试,要求迁移后的C++、Java或Rust输出与原程序达成字节级对齐。GPT-6.1 Sol在低推理努力度下跑出86.6%(而GPT-5.6 Sol仅5.4%),高推理努力度下达到97.9%,证明大模型已经摸透了定点截断与舍入的死板规则。
但这也正是认知偏差最大的地方:单程序的字节级对齐,距离真实的大型机重构,中间还隔着几个工程代差。
路线之争与真实重构的距离
遗留系统的现代化赛道上,各家切入的角度截然不同。
| 参与方 | 核心产品 / 方案 | 验证指标与口径 | 解题重心 |
|---|---|---|---|
| OpenAI | GPT-6 系列 / MultiLangBench | COBOL 迁移 97.9% 准确率 | 大模型提示流与语义字节级对齐 |
| IBM | watsonx Code Assistant for Z | 2,871 个程序段 97.19% 分支覆盖率 | 符号执行驱动的自动化单元测试 |
| AWS | AWS Blu Age / Transform | CardDemo 314 个文件耗时 36 分钟 | 大型机架构反向工程与解耦工具链 |
IBM在COBOL转Java的方案中,借助符号执行生成自动化测试,测的是代码路径的覆盖能力,不是端到端迁移成功率;AWS在CardDemo演示应用(包含314个文件、59,327行代码)的反向工程测试里耗时36分钟,拼的是对整体结构的拆解效率;OpenAI拿出的则是孤立用例的输出正确率。
三者的数据口径互不相通。真实世界的大型机核心系统,从来不是孤立的算法逻辑,而是深埋在CICS事务管理器、JCL作业控制语言、VSAM层级数据文件以及无数嵌套Copybooks组成的网状泥潭中。
古人讲工欲善其事,必先利其器。通用大模型在低资源语言上的算力灌顶,确实造出了一把更锋利的语法手术刀,但它目前切开的只是皮下脂肪,尚未触及分布式事务和主干业务流这些真正连着骨头的韧带。
- 结论.大模型在COBOL上的突破,最大价值是把老系统维护者的角色,从手写晦涩代码中解放出来,转变为边界条件审计员与隐式规则确认者。
- 风险.若脱离去污染审计与完整的运行时验证流水线,盲目将高分指标等同于工业级重构能力,生产环境将面临难以预估的容灾隐患。
对于政企IT决策者而言,与其为97.9%的跑分欢呼,不如先看接下来各家能否把JCL作业调度、CICS事务隔离与端到端解耦纳入统一基准。这场攻坚战才刚刚越过语法起跑线。