OpenAI 在 2026 年 10 月 21 日发布了由 Ritendra Datta 与 Karthik Gopalratnam 撰写的技术文章,首次对外完整披露了 ChatGPT 的广告技术架构。这套系统以一个专门后训练的前沿大模型为调度中枢,通过工具调用驱动检索、排序与竞价全流程,并在不到200天的时间内,实现了10亿美元的年化营收运行率(ARR),吸引了超过 10 万家广告主进场投放。
这不仅是生成式 AI 从免费普及走向商业自造血的关键转折,也宣告了长达二十年的搜索广告范式正在发生移位。面对高昂的推理算力成本,OpenAI 必须证明对话式产品具备匹敌甚至超越传统搜索的变现效率;但它面临的核心挑战始终如一:如何在商业广告渗入对话流的同时,守住用户对大模型中立性的信任。
意图漂移:为什么传统搜索广告在对话流中失效
传统的计算广告体系建立在单次离散事件之上。用户在搜索框敲入一个关键词,或者打开一个独立网页,广告引擎接收到即时请求,在毫秒级内完成关键词匹配、候选召回、出价排序,最后把广告位推送到屏幕上。这种单次请求对应单次曝光的机制,在多轮对话中几乎必然碰壁。
在 ChatGPT 的日常交互中,用户的意图是不断漂移和展开的。用户可能最初只是询问优胜美地的天气,几轮之后开始讨论长途徒步的体力分配,最后才提到适合特定地形的徒步鞋。如果系统在第一轮就根据零散词汇硬塞广告,不仅会严重打断用户的思考链路,还会因为过早误判真实意图而导致转化率极低。
微软早在 2024 年 10 月就曾公开披露过基于整场会话上下文的广告触发机制,但 OpenAI 这次拿出的方案走向了更极端的代理化路线。ChatGPT 引入了有状态的广告会话机制,让后训练大模型扮演编排者的角色,通过动态工具调用来感知整场对话的上下文演变。
在这一流程中,广告中枢大模型先将长对话提炼为多组语义查询并生成向量表示,调用近似最近邻检索从庞大广告池中捞取候选集。随后,系统逐级进行预算消耗进度、时段控速以及合规策略过滤,再由评分工具完成相关性测算。在这个架构中,空手返回也是成功结果:若没有找到足以提供实用价值的商业内容,系统宁可不向用户展示任何推广。
服务物理隔离:大模型只管提名,二价拍卖定终局
许多人直觉上认为,AI 广告就是让正在生成回答的同一个大模型顺便提一句品牌赞助。如果真是这种设计,生成式 AI 最底层的公信力将迅速崩塌。
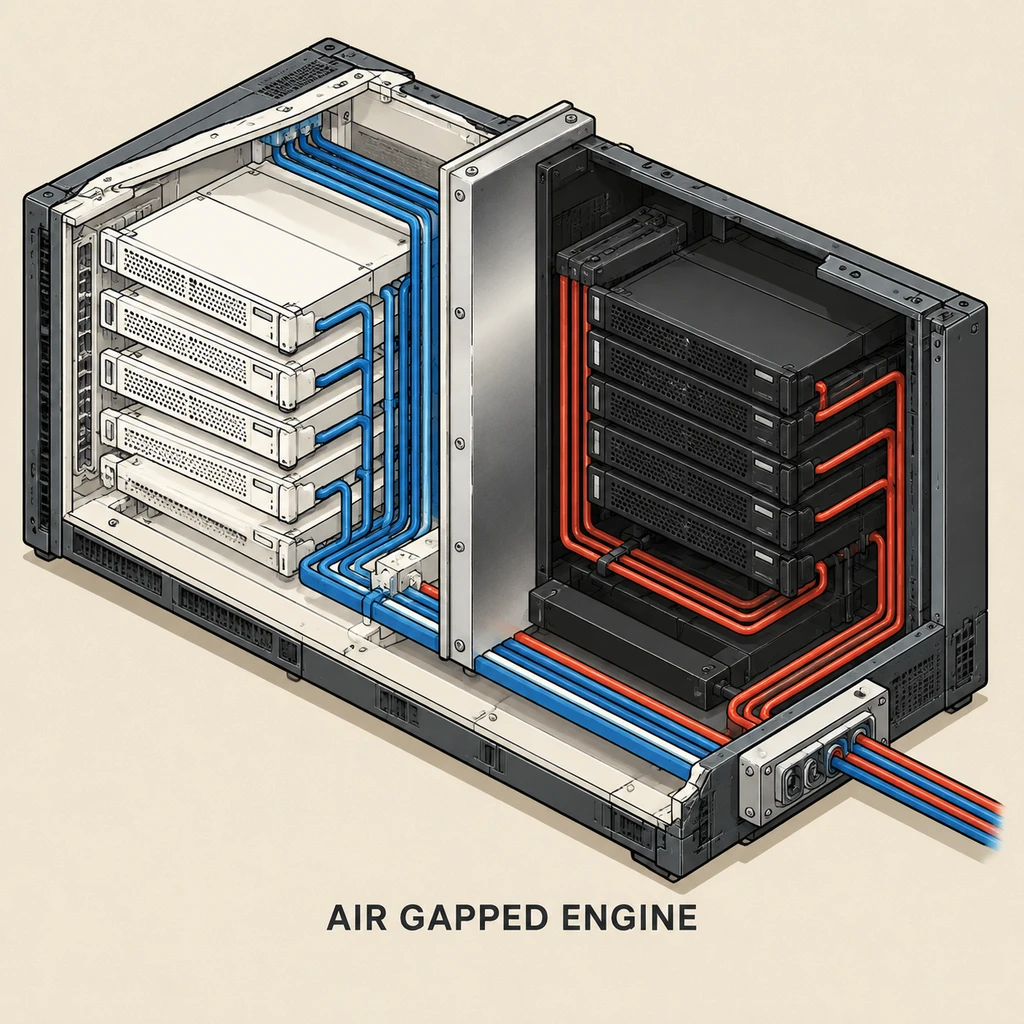
OpenAI 采取了彻底的微服务物理隔离。处理用户日常提问并生成正文的,是核心推理服务;而广告流则运行在完全独立的后端微服务中,拥有独立的代码库与专门的后训练模型。两者唯一的交集,是前端在组装内容时拉取各自的输出。即使广告系统出现严重超时或完全宕机,ChatGPT 的正常文字生成也丝毫不受干扰。
物理隔离是防止回答被商业买通的工程底线,核心推理绝不能向竞价逻辑让步。
更关键的技术细节在于权限划分:后训练大模型并不直接决定哪条广告胜出,更没有给曝光标价的权力。它仅依据语境提名少量候选对象,最终筛选与扣费交由经典的相关性加权二价拍卖机制完成。
为了进一步把赞助内容与模型本身的观点剥离开,广告微服务在把素材送往前端时,会附带一段由系统自动生成的简短前导引言。这个引言用客观语调解释该推广为何与当前对话相关,广告文案本身则被严格圈定在卡片内,防止赞助商的话术侵蚀回答本身的信誉。
隐秘的代价:跨对话记忆调用与独立的控制开关
OpenAI 官方一再向外界承诺,绝不会将用户的私密聊天记录转交给广告主。从技术通信层面看,这一陈述属实。但很多普通用户没有意识到的是,这套广告架构内部默认调取了用户的跨对话历史、系统长期记忆以及过往广告点击记录。
商业系统虽然没有把原始文本卖给第三方,但它在 OpenAI 的服务器内部对用户的全部对话进行了全方位的特征提炼与商业匹配。对于注重隐私的用户而言,这构成了一个易被忽视的认知陷阱。
更微妙的设计体现在复杂的账户设置逻辑中。ChatGPT 的广告控制与模型训练控制是完全解耦的两套体系。许多用户误以为在设置中关闭了用于改进大众模型的选项,自己的对话就不会再被商业系统调用。但事实上,关闭训练仅仅是停止向基础模型输送语料,广告个性化仍然照常运转。
用户若想真正切断历史数据的商业调用,必须手动进入设置中的广告控制面板,单独关闭关于历史聊天与记忆的授权,或者索性关闭全量个性化。
与此同时,产品层级的划分也极为现实。付费的 Plus 与 Pro 会员维持着纯净的无广告界面;而针对想要免除广告却不愿按月掏出真金白银的免费用户,OpenAI 提供了一种名为免广告降级的折中模式。选择该模式的用户确实可以屏蔽一切商业赞助,但代价是模型的使用额度上限被大幅压低,可调用的高级工具集也会被直接削减。
- 风险.虽然物理隔离阻断了广告代码对答案生成的直接篡改,但平台单方面宣称的“竞品也能获得客观评价”至今仍缺乏独立的第三方自动化审计,商业化程度越深,这种中立性背书面临的公众拷问就越严苛。
不到 200 天狂揽 10 亿美元年化营收,证明了 Agent 驱动的广告技术在商业变现上的巨大威力。但把对话记忆深度编织进广告系统的做法,也让 OpenAI 在隐私敏感型用户中埋下了摇摆的种子。接下来最值得行业紧盯的变量,是免费层级中有多少高频用户会因反感数据调用而选择降级模式,以及当广告主与普通用户的利益真正正面相撞时,这套精巧的微服务物理隔离墙究竟能承受多大的妥协压力。