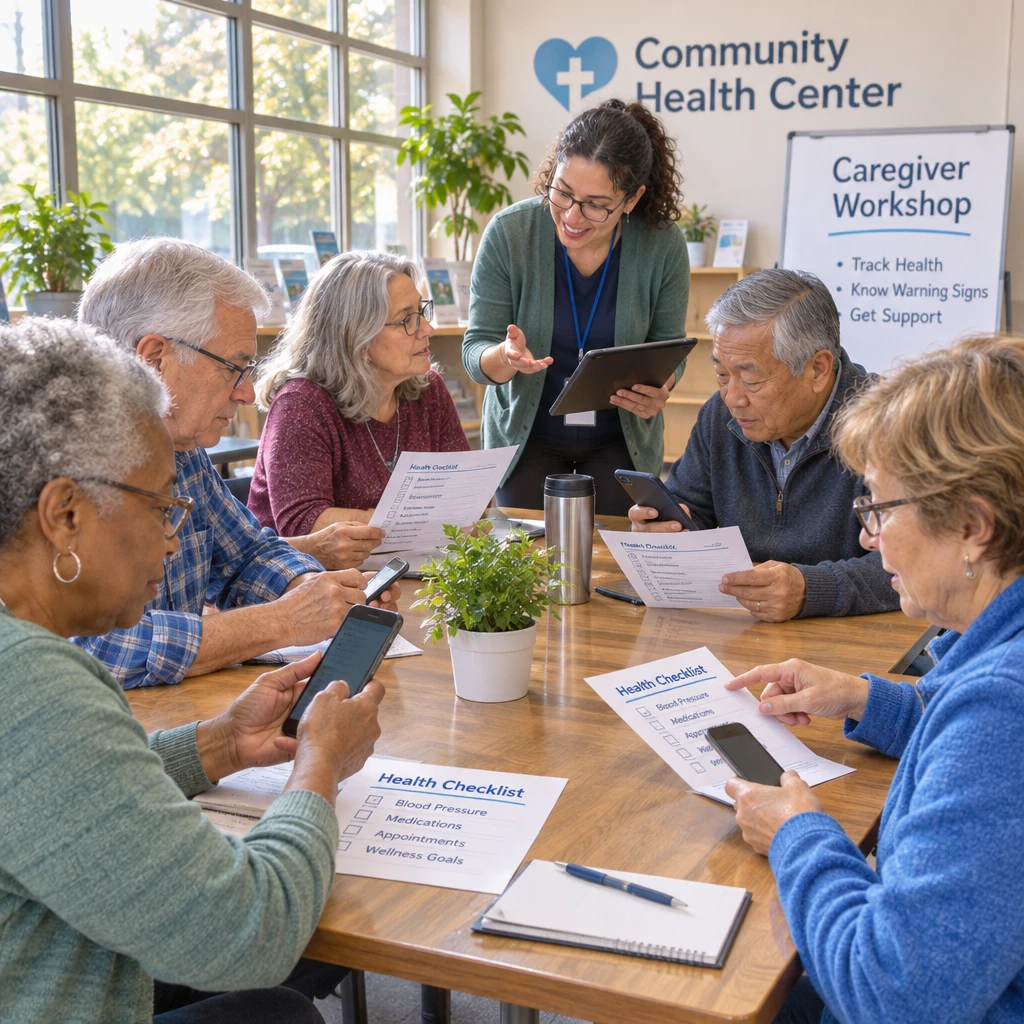
OpenAI 正在把公益培训变成医疗健康下沉市场的获客漏斗。11 月 10 日,OpenAI Academy 联合照护者行动网络(Caregiver Action Network)、阿尔茨海默病协会和美国糖尿病协会,在奥克兰、坦帕、匹兹堡、亚特兰大和底特律 5 个城市办了一场免费线下培训,教家庭照护者用 ChatGPT 排班、找社区资源、把专业资料改成大白话。借着这场活动,OpenAI 抛出一个极具冲击力的数字:全美每周有超过 4000 万条 关于医疗保健的 ChatGPT 消息是在替他人咨询。
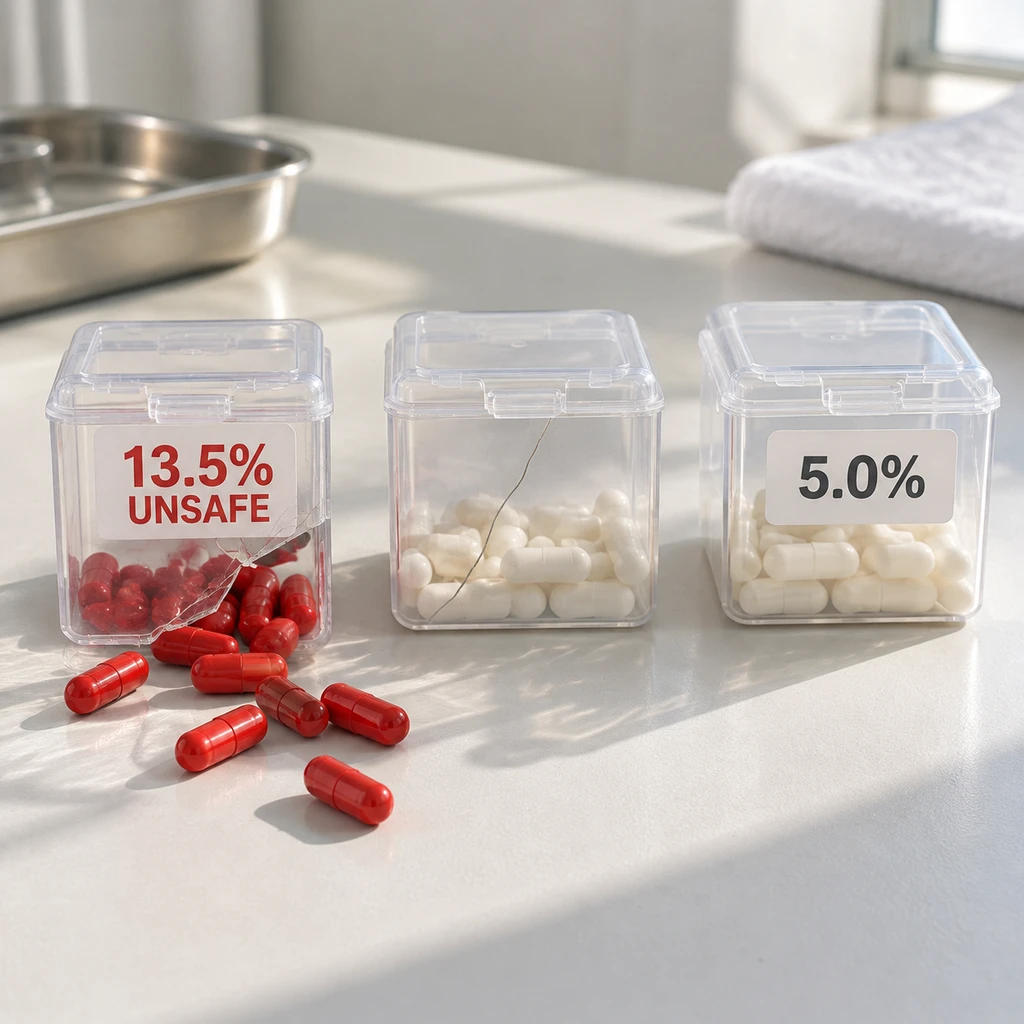
这个数字看着吓人,但照护者如果真把 ChatGPT 当成医疗助手的首选,踩坑的概率比想象中高得多。独立医学测评显示,在回答患者医疗提问时,GPT-4o 产生不安全回复的比例高达 13.5%,几乎是竞品 Claude(5.0%)的三倍;而且照护者随手输入的病患亲属隐私,即便开了临时聊天,也会在 OpenAI 后台留存最多 30 天。
4000 万条消息的口径戏法与安全错位
OpenAI 在通稿里把 4000 万这个数字放在最显眼的位置,很容易让人以为全美有上千万照护者正依赖它看病。翻看页面底部的脚注就会发现,这只是基于 2026 年 10 月 9 日至 29 日三周数据的黑盒估算,且统计单位是消息条数而非独立用户数。一个焦虑的家属为了搞懂一张化验单,一次追问十几轮就能贡献十几条消息,真实覆盖的照护者规模远没有字面上那么庞大。
不可否认的是,照护者确实在自发涌向大模型。合作方照护者行动网络在 2026 年 10 月 15 日发布的调查显示,272 名受访家庭照护者里已有 59% 尝试或定期用 AI 处理照护任务。但用得多不代表用得安全,尤其当他们把 ChatGPT 当作默认工具时。
《npj Digital Medicine》在 2026 年发表了一项针对患者医疗提问的实测,医生团队评估了 222 个问题的 888 条大模型回复。结果显示,GPT-4o 被标记为不安全的比例达到 13.5%,排在同场测试的末位,而 Google Gemini 为 7.7%,Anthropic 的 Claude 只有 5.0%。匹兹堡大学 2025 年针对痴呆症家庭照护场景的博士论文评估也印证了这一温差:GPT-4o 在贴合科学共识上得分较高,但安全底线最强的依然是 Claude 3.5 Sonnet。
最积极向照护者推销自己的大模型,恰恰在临床安全测试里漏得最多。
截至 11 月 10 日活动当天,OpenAI 只给出了日程与美好预期,没有公布实际到场人数或任何可量化的照护改善结果。拉上三大权威患者组织背书,更像是用公益培训抢占社区心智,顺便把高风险的医疗咨询框定在低风险的行政事务里。
划不准的医疗红线与被代交的病患隐私
OpenAI 在培训手册里画了一条看似清晰的合规红线:只教照护者做排班表、准备互助小组讨论提纲、把权威医学材料转成通俗语言,同时反复强调 AI 不能替代医疗、法律或财务建议。这种防御性公关能帮厂商规避法律风险,却经不起真实照护场景的推敲。
一个既要上班又要照顾失智老人的家属,半夜打开聊天框把出院小结粘进去,要求把专业术语变成大白话时,根本分不清哪里是信息简化,哪里是病情解读与用药建议。《npj Digital Medicine》2025 年针对中风照护的评估与《Digital Health》2026 年的范围综述都给出了相似的警告:在预防、诊断、治疗和康复各个阶段,现有大模型没有一家能跨阶段稳定达到临床标准,在检查解读和治疗建议上必须保留人工监督。教家属用错误率超过十分之一的模型去改写医学资料,等于把合规免责留给 OpenAI,把甄别医疗幻觉的担子甩给了不懂医术的普通人。
更隐蔽的暗礁在于代际隐私的被动让渡。照护者在培训里学的是保护个人信息,但他们在实际对话中喂给模型的,往往是被照护亲属(如阿尔茨海默病老人、重症慢病患者)的病历、用药记录和生活细节。这些病患本人大多没有签署过任何大模型隐私协议,却成了数据裸奔的承受者。
| 平台与无痕模式 | 模型训练豁免 | 后台最长留存时间 | 隐私与安全审查例外条款 |
|---|---|---|---|
| ChatGPT 临时聊天 | 不用于训练 | 最多保留 30 天 | 出于安全目的保留副本并可审查 |
| Gemini 临时聊天 | 不用于训练 | 保留 72 小时 | 关闭记录后仍可能因安全目的受人工审查 |
| Claude 无痕聊天 | 排除在模型改进外 | 适用单独保留期 | 适用单独的保留与安全例外条款 |
即便是懂点技术的家属专门开启了各家产品的临时或无痕聊天,消费级聊天机器人也不是受医疗法规严格保护的保险箱。按各家现行隐私条款,ChatGPT 的临时聊天虽然不用于训练,但出于安全目的最多会保留副本 30 天;Google Gemini 的临时聊天保留 72 小时,关闭活动记录后仍可能接受安全人工审查;Claude 同样设有单独的保留和安全例外条款。
- 风险.家庭照护者把长辈或病患的化验单、诊断书发给消费级大模型前,必须意识到开启临时聊天仍会留下 72 小时至 30 天的服务器存档;遇到需要解释检查结果或调整护理方案的场景,优先交叉核对安全性更高的模型或直接咨询主治医生,切勿把通俗化改写当成诊疗依据。
对于阿尔茨海默病协会和美国糖尿病协会这类公益机构而言,帮焦虑的家属减负无可厚非,但跟单一商业大模型绑定搞培训并不是长久之计。接下来真正值得盯紧的,是这些患者组织在 11 月 10 日的活动后能不能拿出真实的照护改善数据,以及它们会不会打破单一厂商背书,牵头建立一套跨平台的医疗安全基线与第三方病患隐私保护规范。