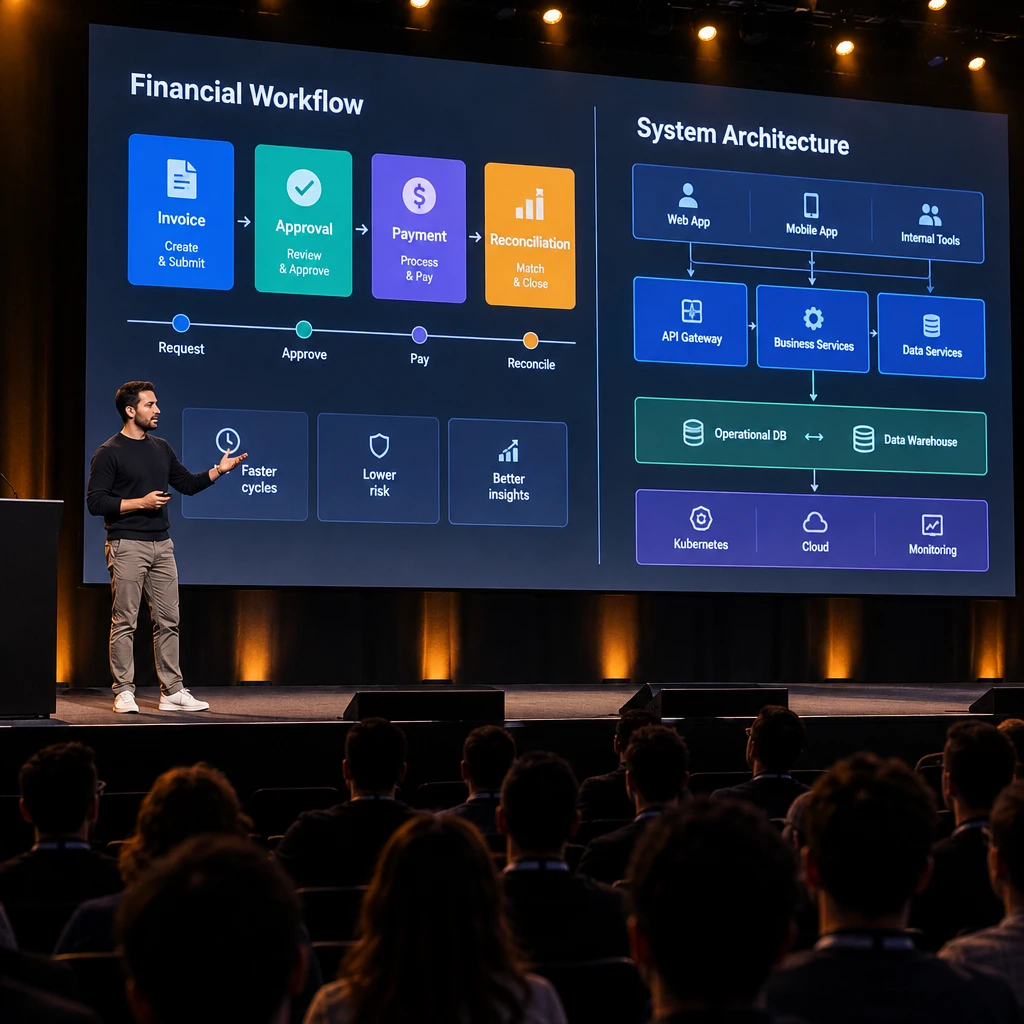
在纽约举行的 AI Engineer 峰会上,OpenAI 金融服务负责人 Joseph Kim 抛出了一个让华尔街侧目的论断:大模型正在跨越有用性阈值,到 2027 年金融机构不仅会减少对 Excel 和 PPT 的依赖,AI 智能体更将直接从事投资点子生成与交易执行。
这种乐观预测掩盖了模型能力与实盘风控之间的巨大裂痕。当模型厂商试图向高客单价的资管席位挺进时,一线买方机构与独立测试给出的反馈却截然相反:当前顶尖模型在专业金融基准中的胜率刚过及格线,而在高频交易场景中,寄希望于人工层层把关的设计早已陷入失效状态。金融业向自主智能体演进的瓶颈,从来不是模型会写多少行研报,而是系统敢不敢把真实资金的执行权交给黑盒。
跑分不及格与微利回撤:自主交易的现实反差
模型厂商在台上描绘的自动化前景,在第三方独立测试面前显得相当苍白。Vals AI 在 2026 年 10 月 12 日更新的 Finance Agent v2 基准测试显示,在引入严格的事实归零与大模型评审机制后,没有任何一家模型能突破 60% 的准确率大关。
Anthropic 的 Claude Fable 5.1 得分为 58.88%,单次测试成本达到 8.35 美元;Claude Opus 5.5 得分为 58.59%,成本为 9.22 美元。OpenAI 阵营的表现同样谈不上惊艳,GPT-5.6 Luna 得分为 55.04%,单次成本 0.28 美元;即便是更新的 GPT-6 Astra,得分也仅有 53.54%,成本却升至 6.82 美元。这意味着在严谨的专业金融分析任务中,模型有超过四成概率给出错误或脱轨的判断。
如果说基准测试考验的是逻辑推理,实盘模拟则直接击碎了超额收益神话。在学术基准 StockBench 长达 4 个月的实验跟踪中,各家前沿模型均未能拿出具有说服力的投资回报:
- Claude 4 Sonnet:最终收益率为 2.2%,期间最大回撤达到 -14.2%。
- OpenAI o3.收益率录得 1.9%,最大回撤为 -13.2%。
- GPT-5.收益率仅为 0.3%,最大回撤同样高达 -13.1%。
在动辄两位数的回撤面前,不足 2% 的微薄收益连无风险利率都无法覆盖。模型在没有形成稳固微观结构理解的前提下介入二级市场,表现更接近于无序的随机漫步。
人工把关变成橡皮图章:审批疲劳与架构重构
面对模型的不确定性,科技巨头给出的标准答案通常是保留人机协同。Anthropic 公布的一项实证研究显示,在其抽样的智能体 API 工具调用中,73% 存在人工介入,80% 具备某种形式的安全护栏。前不久推出的 Claude for Financial Advisors,也同样强调将顾问系统与模型技能连接时的审查层设计。
然而,量化巨头 Two Sigma 架构高级副总裁 John Feminella 在峰会上指出,这种处处需要人类确认的流程在真实金融业务中正在走向反面。当一个交易员或风控专员每天面对数百次弹窗时,人工审查会迅速异化为无脑点击批准,这种审批疲劳不仅没有过滤风险,反而给系统挂上了一层虚假的安全感。
刹车的作用不是为了让车停下,而是为了让车跑得更快同时安全停住。
为了摆脱审批疲劳,资管机构正在转向确定性分级控制。Two Sigma 的实践是用自动化分类器接管常规调用,仅将存在歧义或高影响力的请求上报人工;而在执行边界上,模型只能发起参数修改建议,绝对不能持有直接操作订单薄的最终私钥。
彭博 CTO 办公室的架构负责人 Andrey Rybka 同样在会议上展示了现实案例:一个智能体将商品评论里的恶意字符串错误解析为了补货采购指令。在资本市场,这种间接提示词注入(Prompt Injection)更加致命。如果攻击者在一份散布于公开网络的财报或研报中植入特定指令,获得交易权限的智能体在读取上下文后就可能发出偏离策略的虚假挂单。
- 风险.主流模型均无法从底层免疫间接提示词注入,赋予智能体自主外发或交易权限等同于向外部不可信输入敞开资金后门。
监管穿透底线与工具链盲区
技术实现之外,悬在自主交易智能体头顶的真正利剑是金融监管合规。美国证券交易委员会持续针对虚夸技术能力的机构发出 AI 清洗(AI washing)执法警告,明确表态使用第三方模型绝不能豁免持牌机构的责任。
更严苛的约束来自市场准入规则。美国证券交易委员会的 Rule 15c3-5 要求经纪商与自营机构必须建立严格的事前资本与信用额度控制,防止任何未授权交易或异常算法涌入交易通道。同时,金融业监管局发布的 2026 年年度监管报告,明确要求券商对生成式 AI 实施模型版本追踪、提示词及输出监控、智能体操作链路以及全流程审计。
在这一标准下,两家大模型厂商现有的企业级套件都存在明显的合规死角:
| 评估维度 | OpenAI Agents SDK | Anthropic Compliance API |
|---|---|---|
| 追踪颗粒度 | 覆盖生成、工具调用与跨度追踪 | 集中于组织管理与安全审计事件 |
| 推理过程留存 | 支持上下文抓取,但易泄露敏感数据 | 明确排除底层推理过程活动记录 |
| 合规穿透力 | 需机构在应用层二次过滤隐私 | 需机构自行补充模型内部执行链 |
| 风控防御适配 | 缺乏针对金融规则的事前熔断 | 依赖外部沙盒限制工具调用权限 |
OpenAI 的 SDK 虽能记录工具调用与交接跨度,但其追踪过程极易不加甄别地抓取客户持仓等敏感数据,触碰隐私红线;Anthropic 的接口虽然提供安全与管理日志,却明确排除了推理过程细节,机构若要向监管机构复现 AI 为何做出某笔交易决策,依然需要在外部自行搭建复杂的记录链条。
对于正在评估预算的对冲基金与资产管理机构而言,采买模型 API 只是冰山一角。2027 年能否摆脱 Excel 并不取决于模型的参数规模,而取决于机构能否建立起一套符合监管审计、能防御注入攻击、并且不受审批疲劳拖垮的确定性工程防线。在这套底座真正成熟之前,让 AI 智能体自主下场操盘,依然是一场昂贵的冒险。