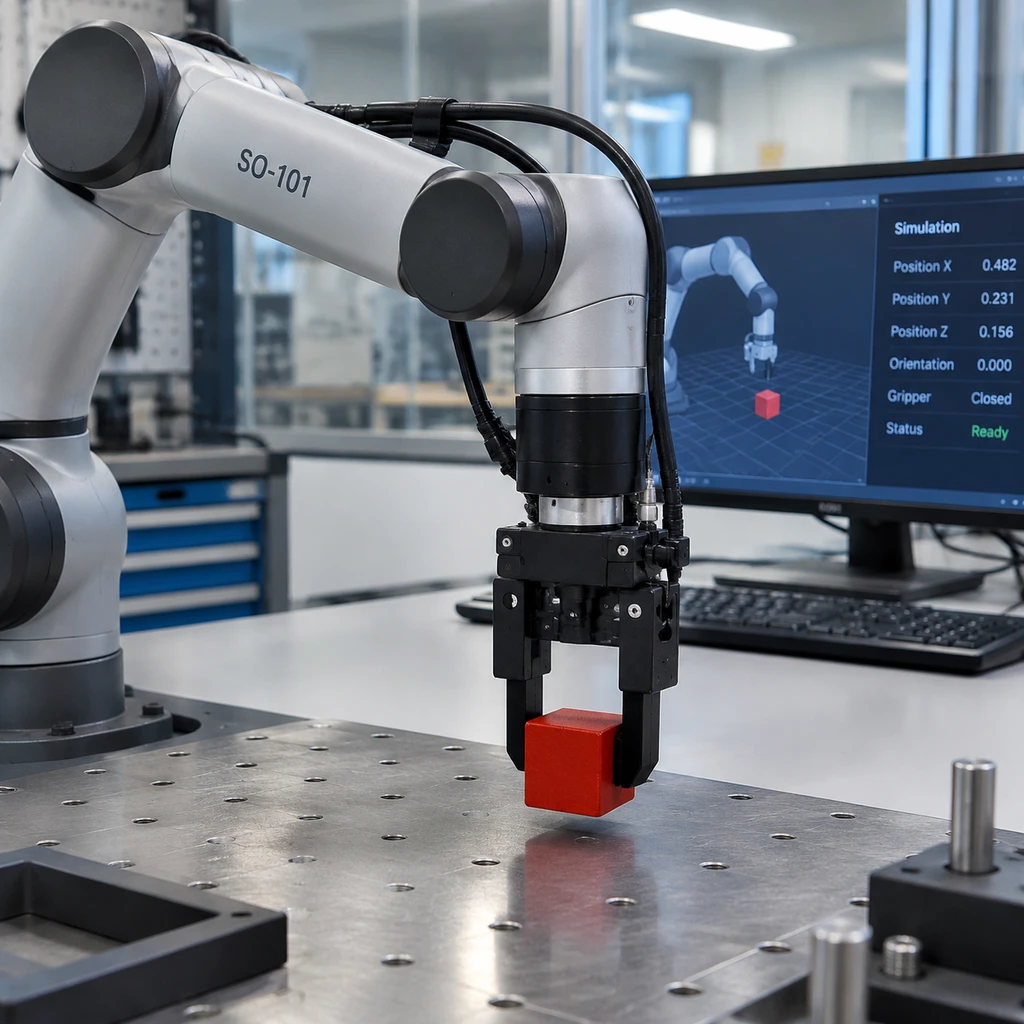
2026年9月23日,NVIDIA在Hugging Face技术博客发布物理AI仿真系列实践,正式展示如何通过其Python内嵌CUDA编译器NVIDIA Warp,将机器人学界标杆物理引擎MuJoCo迁移为GPU原生执行的MJWarp。在官方演示中,一个经典的SO-101机械臂堆叠魔方任务被直接拉起至2048个并行环境。
这篇技术文档表面上是传统仿真向GPU高吞吐迁移的操作手册,但技术底牌很清晰:这绝非一次无痛升级,而是具身智能算法团队在算力焦虑下,主动以物理精度和求解特性为代价换取训练吞吐的工程妥协。
从单核低延迟到2048个并行世界
在具身智能模型训练中,核心矛盾早已从单台机器人的实时控制延迟,转向了强化学习所消耗的经验采样总量。经典CPU架构下的MuJoCo凭借双精度解算、极高的单步响应速度和稳定的接触动力学,牢牢统治着模型预测控制与遥操作领域。然而,受限于多核CPU的进程间调度开销与数据跨总线搬运,CPU方案在面对成千上万个智能体并发采样时逐渐力不从心。
NVIDIA切入这一痛点的武器是Warp。作为一个将类似Python语法的代码即时编译为CUDA核函数的工具,Warp为MuJoCo补齐了批量化GPU执行能力。MJWarp所做的工作,是把MuJoCo的MJCF场景模型编译并载入GPU显存,利用一个批处理函数驱动成百上千个姿态各异的机械臂同步运行。
这种架构抹平了主机内存与显卡显存之间的数据交换鸿沟。在官方测试中,SO-101机械臂在单个GPU上能够以极高的并行度推进时间步,直接为下游强化学习提供高密度的状态转移样本。
精度降级与缺失的物理特性
将物理引擎搬上GPU并非零成本。机器人团队在获得并发能力的同时,首先要面对数值稳定性的明显滑落。
标准CPU版MuJoCo默认采用64位双精度浮点数解算,而MJWarp为了最大化GPU流处理器的吞吐性能,默认降级为32位单精度浮点数。在简单的刚体运动中这一变化尚可接受,但在机械臂夹爪与物体边缘的高摩擦接触点、微小滑移及热启动处理上,单精度的舍入误差会导致仿真轨迹与CPU基准产生行为偏差。这意味着开发者在CPU上验证成功的抓取姿态,搬到GPU环境后无法实现轨迹严格对齐。
更深层的代价格局体现在求解特性的阉割:
- 求解器与特性裁剪MJWarp目前不支持MuJoCo原生的PGS投影高斯-赛德尔求解器,不支持消除接触漂移的noslip特性,也无法运行IMPLICITFAST的中点积分算法。
- 传感器与插件缺失依赖外部插件编写的特殊执行器和定制传感器在MJWarp中暂时无法调用。
- 结构自由度限制对于单连通结构超过60个自由度的复杂机械机构,MJWarp存在显著的计算性能瓶颈,官方文档目前仍将其标注为活跃改进区。
- 动力学不可微虽然底层Warp框架支持基于磁带机制的反向自动微分,但MJWarp本身的物理流水线目前暂不支持动力学自动微分。相比基于JAX重构、原生支持解析梯度的MJX-JAX,MJWarp无法直接用于基于梯度的轨迹优化任务。
此外,显存管理也埋下了工程隐患。MJWarp要求开发者在初始化时严格预分配碰撞与约束缓冲区。一旦机械臂在复杂接触任务中产生的瞬时接触点超出上限,系统并不会自动扩容,未捕获的缓冲区溢出会直接引发未定义物理异常。
- 提醒.盲目追求并行规模容易忽视单精度带来的数值退化,在细微装配与高灵巧操作场景中,虚拟仿真与真实硬件之间的传递误差会被非线性放大。
吞吐神话下的真实性能账本
NVIDIA在此前公布的数据中曾展示过极具冲击力的加速比:在配备RTX PRO 6000 Blackwell显卡、MuJoCo 3.5的基准测试中,针对特定负载测出相较MJX最高475倍的双手机器人操作加速和252倍的足式移动加速。在Humanoid人形与Aloha双手场景的纯物理步评测中,MJWarp分别跑出每秒335万步与245万步的极值,略高于MJX-Warp的296万步与233万步。
纯物理推演的秒级吞吐,并不能直接兑现为端到端训练的同等收益。
真实强化学习流程由物理推进、策略网络前向推理、梯度反向传播和环境封装调度共同构成。当进入端到端训练时,纯物理单步的亮眼表现会迅速被框架开销稀释。
在社区针对Unitree Go1四足机器狗的标准化任务实测中,将并行环境扩大至4096个后,基于MJWarp封装的PyTorch训练框架mjlab最终录得的端到端吞吐约为190k steps/s。这一表现甚至略低于同硬件配置下Isaac Lab跑出的240k steps/s。
导致这种落差的关键变量之一在于CUDA Graph执行机制。MJWarp的一组单步计算涉及多个离散的小核函数发射,如果不启用CUDA Graph重放,显卡发射延迟将直接吞噬性能;而一旦由于环境重置或分支变动导致图结构失效、必须强制重新捕获时,仿真吞吐会遭遇断崖式下跌。在基准评测中,强制重新捕获的MJX-Warp在Humanoid和Aloha场景下的吞吐直接滑落至每秒80万步和65万步。
机器人团队的选型坐标系
伴随MJWarp的就位,机器人仿真的技术选型不再存在单一解,而是裂变为针对特定工程目标的权衡游戏:
| 引擎方案 | 核心定位 | 典型吞吐量级 | 核心缺陷与边界 |
|---|---|---|---|
| 经典 MuJoCo (CPU) | 单机精细控制、遥操作与实机调试 | 单进程极低延迟 | 无法直接利用GPU进行万级并发采样 |
| MJX-JAX (DeepMind) | 自动微分动力学、硬件加速解析优化 | 依赖设备与算力 | 接触密集与强几何约束下解算瓶颈严重 |
| MJWarp / mjlab | PyTorch原生生态、百万级高并发无缝迁移 | 物理层超300万步/秒 | 降级单精度、缺失noslip、不支持动力学微分 |
| Isaac Lab (Newton) | 复杂传感器渲染、大规模工业级整机仿真 | 工业端到端高吞吐 | 依赖USD资产格式、生态捆绑较重 |
- 建议.如果当前任务的核心痛点在毫秒级的实时轨迹规划与闭环控制,经典CPU架构的MuJoCo依然是目前物理行为最真实的避风港;若重心在于强化学习策略的海量状态探索,切换至MJWarp或mjlab确实能成倍压缩训练周期,但必须在接触参数上补充充分的域随机化,以对冲单精度解算引入的数值漂移。
真正的物理AI工具链整合还在更后方。随着NVIDIA后续多求解器架构Newton以及Isaac Lab更深层的对接,GPU仿真正在将经典物理引擎彻底重塑为大模型训练集群中的专用数据流水线。