NVIDIA 宣布在 Apache 2.0 协议下全面开源其企业级 GPU 编排平台 Run:ai,涵盖控制面、UI、API、切分 Operator 以及已进入 CNCF 沙箱的调度核心 KAI Scheduler。这一举动常被外界视为应对反垄断监管的妥协,但其背后的真实意图远比合规让步复杂得多:NVIDIA 正在把耗资 7 亿美元收购的核心资产,转化为确立 AI 工厂事实标准的武器。
将顶尖调度软件免费推向开源社区,核心目的绝非慈善,而是为了彻底压制第三方独立编排厂商,化解开发者对底层硬件绑定的警惕,将企业从算法训练到生产推理的全流程算力管理牢牢按在自己的软硬件轨道上。
从反垄断迷雾到主动战略两步走
2024 年 4 月 24 日,NVIDIA 宣布以约 7 亿美元将以色列初创团队 Run:ai 收入囊中。这笔交易随即引来欧盟委员会立案审查。很多人以为随后的开源是监管部门强制开出的补救清单,但欧盟反垄断审查文件(Case M.11766)清楚记录着,该交易在 2024 年 12 月 20 日获得了无条件批准。监管机构并未强制要求剥离资产或开放源码,2024 年 12 月 30 日交易正式完成时的开源承诺,是 NVIDIA 规划好的战略动作。
整个开源计划分为两步推进。第一步始于 2025 年 4 月 1 日,NVIDIA 率先将底层调度核心引擎 KAI Scheduler 以 Apache 2.0 协议开源,项目托管于 GitHub 并随后进驻 CNCF 沙箱。第二步则在 2026 年 10 月 13 日落地,NVIDIA 宣布将包含完整控制面、管理 API、调度切分 Operator 以及工作负载拓扑映射等组件的完整 Run:ai 平台开源,代码完整托管于 GitHub 的 dsx-ai-factory/run-ai 仓库。
开源上层编排软件不是断臂求生,而是为了给自家算力芯片铸造更深护城河。
这场动作真正瓦解的是外部对算力孤岛与厂商绑定的心理防线。通过宽松的 Apache 2.0 协议,企业无需支付昂贵的基础许可费,即可在裸机 Kubernetes 之上搭出一套接近商业版水准的 GPU 调度中枢。对 NVIDIA 而言,软件授权费微不足道,只要底层流通的始终是自家算力硬件,开源便是最高明的推销手段。
细粒度切分的物理现实与性能代价
官方宣传中,Run:ai 最吸引人的是算力利用率翻倍的基准指标。Nebius 与 NVIDIA 在 HGX B200 上针对混合模型的一组联合基准测试显示,在引入细粒度切分与混合编排后,集群并发用户从 3000 人拉升至 9190 人,集群总吞吐从 200,979 提升到 354,312 tokens/s。另一组针对 NIM 微服务的整合测试则表明,原本需要 3 张专用 H100 的 3 个独立微服务,经编排后能收敛至约 1.5 张 H100 等效容量,维持了基线 91% 至 100% 的吞吐表现。
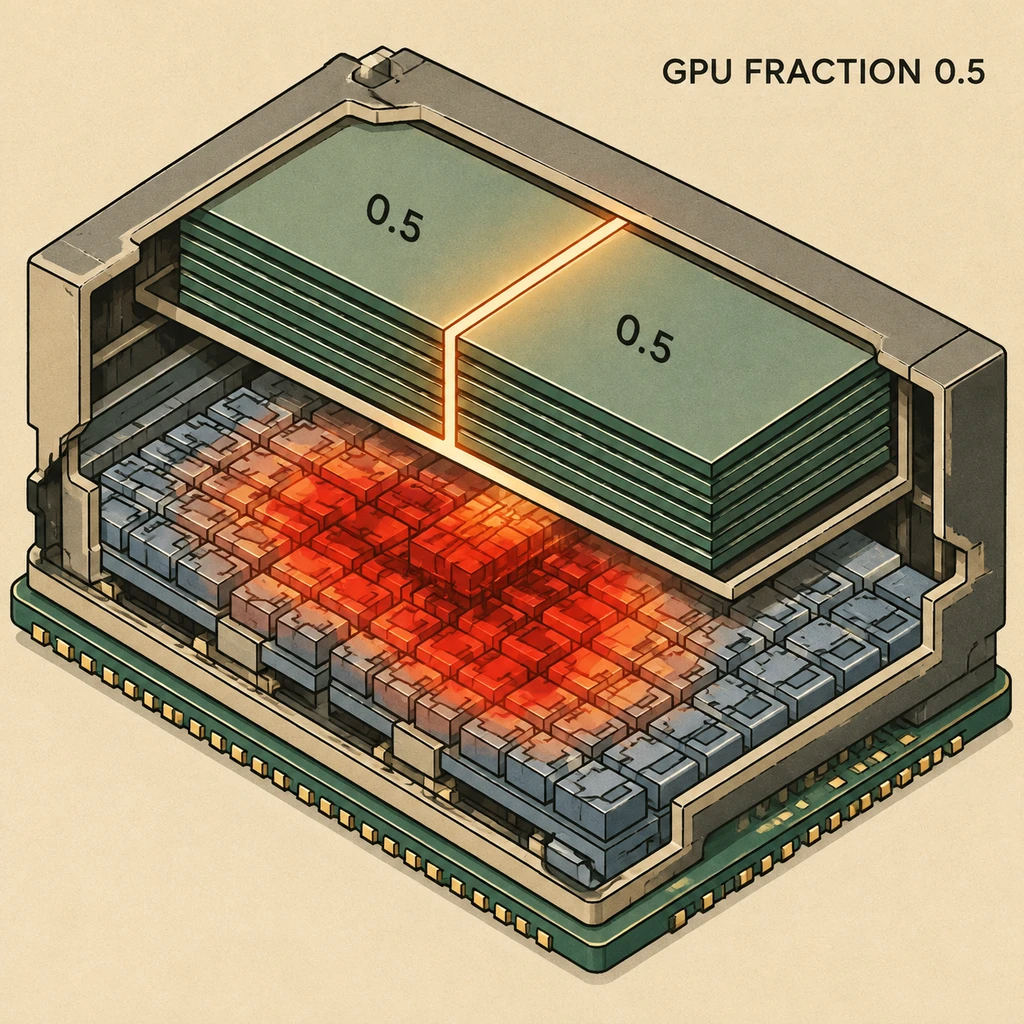
翻开源码才能看清这些数字赖以生存的底牌。在 KAI 的切分体系内,默认运行模式其实是 NonMemoryEnforced。这意味着它只在 Kubernetes 调度层记录显存账本,根本不限制物理显存的调用。一旦某个任务发生突发内存溢出,同卡的其他租户就会因资源抢占崩溃。
要真正实现物理显存隔离,运维团队必须额外配置 HamiCore 或依赖底层容器设备接口(CDI/NRI)的 NvFractions 模块。更深层的限制在于算力分配机制:在当前体系下申请 gpu-fraction: 0.5,仅代表保障了 50% 的显存容量,完全无法保证获得 50% 的流式多处理器(SM)算力时间片。若将长文本推理与突发计算任务混部在同一张卡上,尾延迟将不可避免地大幅抖动。
- 风险.默认切分模式缺乏硬件级隔离,生产环境必须补全底座依赖,警惕分显存不等于分算力的长尾延迟陷阱。
挤压生态空间:调度三强格局生变
开源 Kubernetes 社区里的算力调度长期处于多方混战。围绕批处理训练的 Volcano 拥有深厚积累,并在 2026 年 10 月 14 日发布的 1.16 版本中新增了基于衰减的历史公平共享插件(fairshare)。Volcano 的机制偏向稳健,其公平共享只调整排队队列,不会主动抢占运行中的作业;而 Kubernetes 社区原生的 Kueue 更多停留在准入控制层,负责配额审批而不过深干涉物理拓扑。
| 调度器方案 | 核心定位与场景 | 显存与切分能力 | 资源抢占策略 |
|---|---|---|---|
| KAI (Run:ai) | 交互式研发与混部推理 | 显式分层 / 需配合 NvFractions | 动态配额借调,支持主动回收 |
| Volcano 1.16 | 大规模复杂批处理与 DAG | 依赖外部扩展设备插件 | 衰减历史公平排队,不抢占运行态 |
| Kueue | 多租户作业准入与额度分配 | 本身不负责切分,接管上层排队 | 仅在准入阶段阻断,无底层干预 |
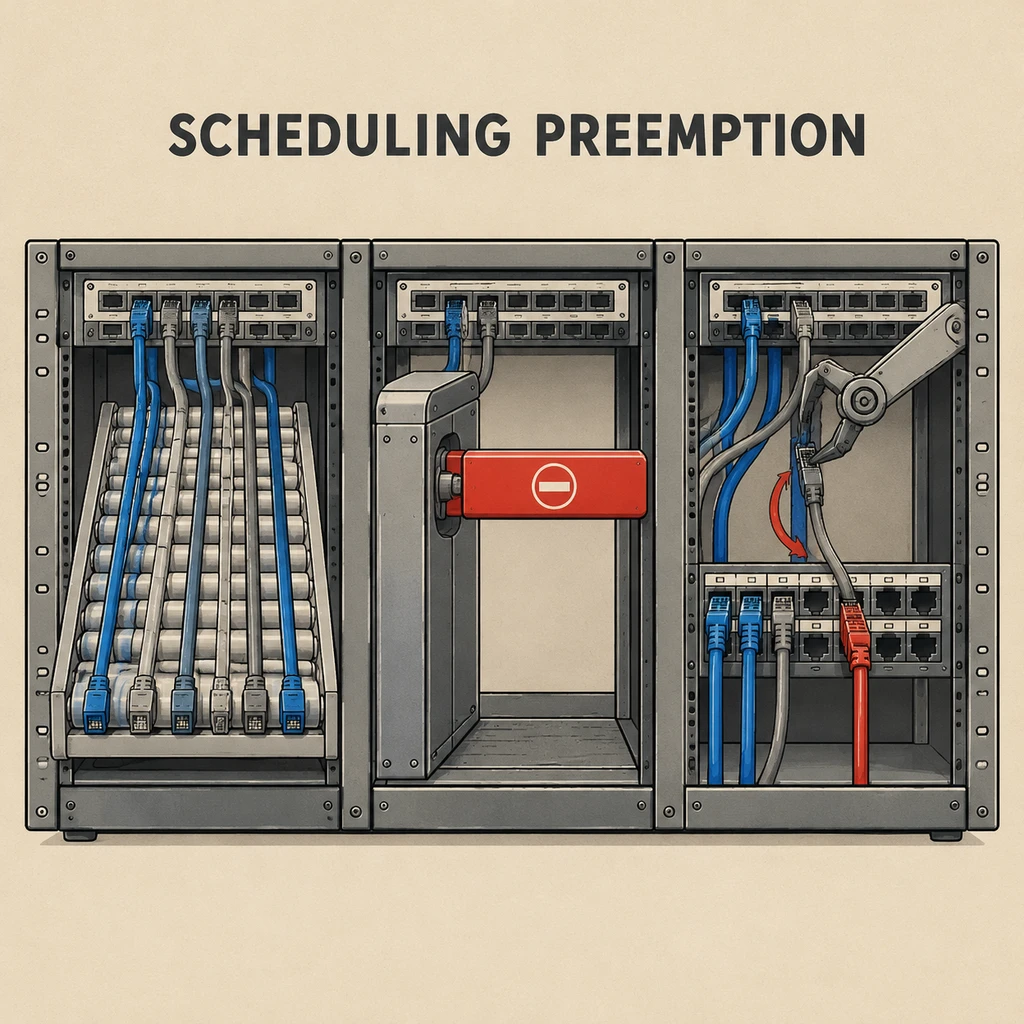
KAI Scheduler 的加入彻底打乱了这种分工。它原生支持复杂的交互式与工作负载拓扑感知,提供了极其激进的多租户资源借调逻辑:当空闲资源被非核心任务临时借用时,一旦高优先级任务到达,调度器会快速回收借出的资源。这种设计贴合多团队算力池化的核心痛点,但也意味着对独立 AI PaaS 厂商和商用调度软件形成了直接降维打击。
- 建议.纯批处理大规模训练可沿用 Volcano,若集群包含大量交互调试与异构推理混部,应优先评估 KAI。
基础设施的最终走向正逐渐明朗。NVIDIA 将原先价值数千万元的软件资产推向开源,不仅削弱了第三方调度软件的商业生存空间,还将硬件拓扑映射的标准深深刻在开源代码里。对于非 NVIDIA 加速卡生态而言,想在 KAI 框架下获得等同于 CUDA 级别的细粒度感知与调度体验,必须承担成倍增加的适配成本。这场开源盛宴,归根结底是为让全球算力集群更加离不开那块绿色芯片。