工业时序预测不需要动辄百亿参数的通用模型,但也不能只靠简单的统计外推。NVIDIA近日以Apache 2.0协议开源的多变量时序预测模型 Kumo Forecast,并未跟随盲目堆叠参数的潮流,而是拿出了一套克制且极具工程算计的折中方案。
该模型原本名为NV-Tesseract Forecasting,现被整合入Kumo-TS套件。它没有从头训练庞大的神经网络,而是直接选用了约 340M参数 的轻量编码器MOMENT-1-large作为骨干,并在微调时完全冻结主干网络,把主要的预测重心转向了时序检索。
把时序预测做成RAG
在文本大模型领域,用外部知识库辅助推理的做法叫检索增强生成。Kumo Forecast将这套思路照搬到了时间序列领域,推出了名为DARR的时域感知表征与检索机制。
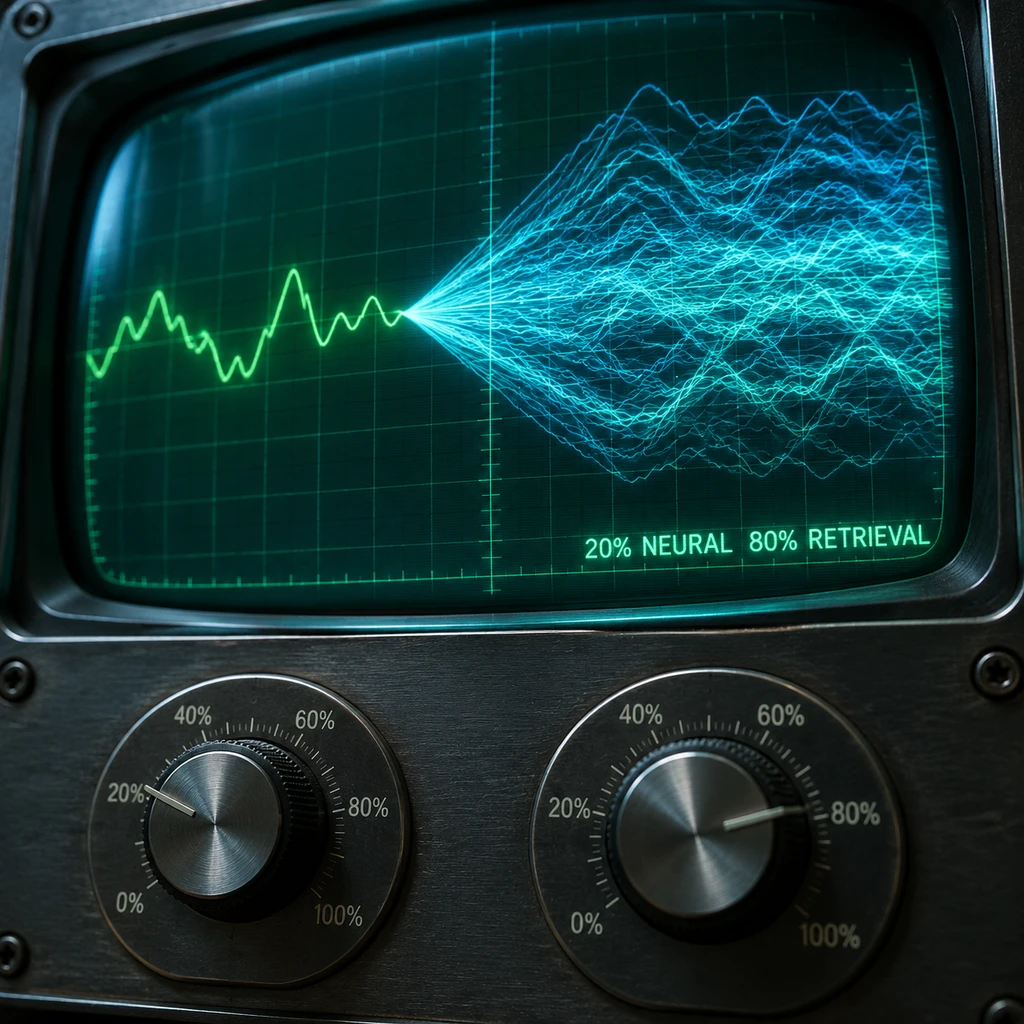
这项技术的理论来自IEEE Big Data 2025收录的论文。它的运转逻辑非常务实:不再逼迫Transformer去记住超长周期里的所有细节,而是将输入序列拆分为两个独立部分。一部分是近期的观测窗口,由340M的编码器生成基础时序表征;另一部分则是历史数据构成的记忆池,通过k最近邻算法实时匹配历史上最相似的工况波动。
在官方公开的SDK默认示例中,混合权重参数alpha被设定为0.2。这意味着直接由神经网络给出的预测只占两成比重,剩下 80%的权重 全部交给历史邻近模式的检索加权。在默认参数下,系统会拉取64个最相近的片段,并以0.05的温度系数完成平滑。
与其说这是一个靠复杂表征预测未来的深度模型,不如说它是一个用预训练网络辅助特征提取的工业查表系统。
深度表征负责提供尺度,历史匹配负责提供形状。
隐去的跑分与归因局限
在模型资产说明中,研发团队列出了详尽的训练口径:数据覆盖了包含30个主要Monash数据集的 300万数据点,并经过严格的切分;评测数据集也明确涵盖了电力负荷ECL、交通流Traffic、电力变压器温度ETTh1与ETTh2以及流感样病例ILI。
然而,无论在Hugging Face的模型卡还是在GitHub开源代码库的说明文档中,均未提供具体的Benchmark数值,也找不到与主流开源时序模型Chronos或TimesFM的横向性能对比。
对于一家向来重视性能宣发的芯片巨头而言,缺少横向对比数据显得不同寻常。原因很大程度上在于时序RAG本身的特性:在周期规律稳定、且历史数据池覆盖完备的场景下,基于模式检索的表现会非常出色;但一旦遇到从未出现过的工况漂移或突发异常,高度依赖kNN相似度的预测逻辑就会迅速失灵。
为了缓解黑盒问题,套件中原生附带了解释器NVExplain。这套后验工具可以在不修改预测模型的前提下,提供时滞重要性、特征归因以及潜在轨迹分析。不过,工业产线排障需要的是因果推断,而基于代理模型的后验归因,只能告诉工程师模型在关注哪些数值,并不能代替真实的物理失效分析。
- 提醒.若当前场景经常面临全新工况或非平稳数据流,强依赖历史检索的方案很难保证预测稳定性。
生产部署的工程暗礁
Kumo Forecast虽然被官方纳入了FOX工厂运维蓝图,用于展示实时设备预测性维护,但如果直接将其打包进高并发推理服务,目前的工程实现存在显而易见的设计疏漏。
在开源代码库的公开跟踪记录中,赫然挂着一条提交于2026年8月的未解决缺陷Issue #69。该报告指出,在并发请求共享模型实例时,模型所依赖的可逆实例归一化模块存在内部状态共享问题。
# 状态泄漏风险伪代码示意:并发请求共享模型实例
# Request A 与 Request B 同时到达
norm_stats_A = RevIN.compute(batch_A) # 均值与方差暂存
norm_stats_B = RevIN.compute(batch_B) # 静默覆盖了暂存的统计量
pred_A = model.head(batch_A)
output_A = RevIN.inverse(pred_A)      # 错误使用了 Request B 的统计量反归一化
这会导致前后到达的不同请求在反归一化过程中互相覆盖均值与方差。这种数据污染不仅不会引发程序报错崩溃,反而会 静默输出 在数值尺度上完全失真的预测曲线。
对于追求高吞吐的微服务架构来说,这种隐蔽的数值污染是极难排查的灾难。
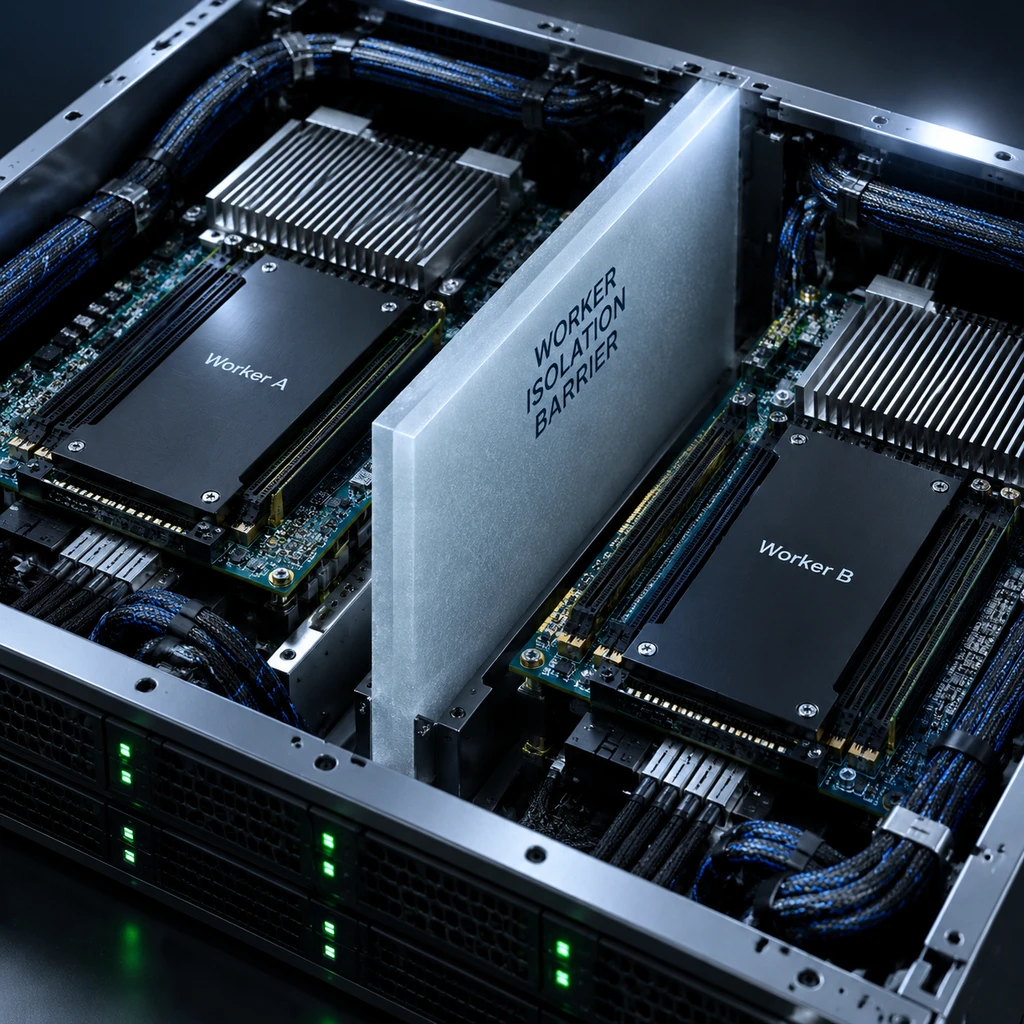
- 建议.在官方重构状态隔离逻辑前,工程团队若要上线该模型,应避免单进程并发共享实例,必须在工作进程之间做好物理隔离。
开源一个轻量模型搭配检索算法,确实为算力受限的边缘工厂提供了一条低成本路线。但在缺少基准跑分验证与并发状态修复之前,它更适合留在离线数据分析的测试台上。