前OpenAI研究员Will DePue在2026年11月12日发布了一份名为checkpoint-forensics的开源取证报告,首次给出了中国AI公司接触Nvidia受控芯片的公开技术证据。他通过逆向分析模型权重的初始化特征发现,2026年4月以来发布的6款中国开源大模型——包括DeepSeek-V4-Flash、DeepSeek-V4-Pro、Kimi K3、Kimi K3.1-Pro、MiniMax-M3以及蚂蚁集团的Ling-3.1-flash,均带有Nvidia新一代Blackwell架构芯片的特征。报告估算,其中5次训练任务合计动用了约12,000张Blackwell GPU,总硬件价值超过5亿美元。
外界很容易把这份报告当成抓获芯片走私的铁证,但拆开底层代码就会发现三个关键事实被忽略了。这套取证捕捉的只是PyTorch软件框架在第0步生成随机数时的流多处理器(SM)数量特征,既不能直接换算出1.2万张卡的集群规模,也无法证明芯片是通过地下走私入境。更现实的变化是,在随后的DeepSeek-V4.1-Flash模型中,这道硬件痕迹已经彻底消失。
藏在生僻词槽位里的148核与152核密码
大语言模型在启动训练前,需要由PyTorch框架向数十亿个空白参数槽位填充初始随机数。PyTorch底层的源码(DistributionTemplates.h)在调用CUDA伪随机数生成器(Philox算法)时,会读取当前GPU的物理核心(SM)数量来分配并行线程。不同代际的Nvidia芯片拥有完全固定的SM核心数,这种硬件差异直接把芯片规格刻进了初始权重的空间分布里。
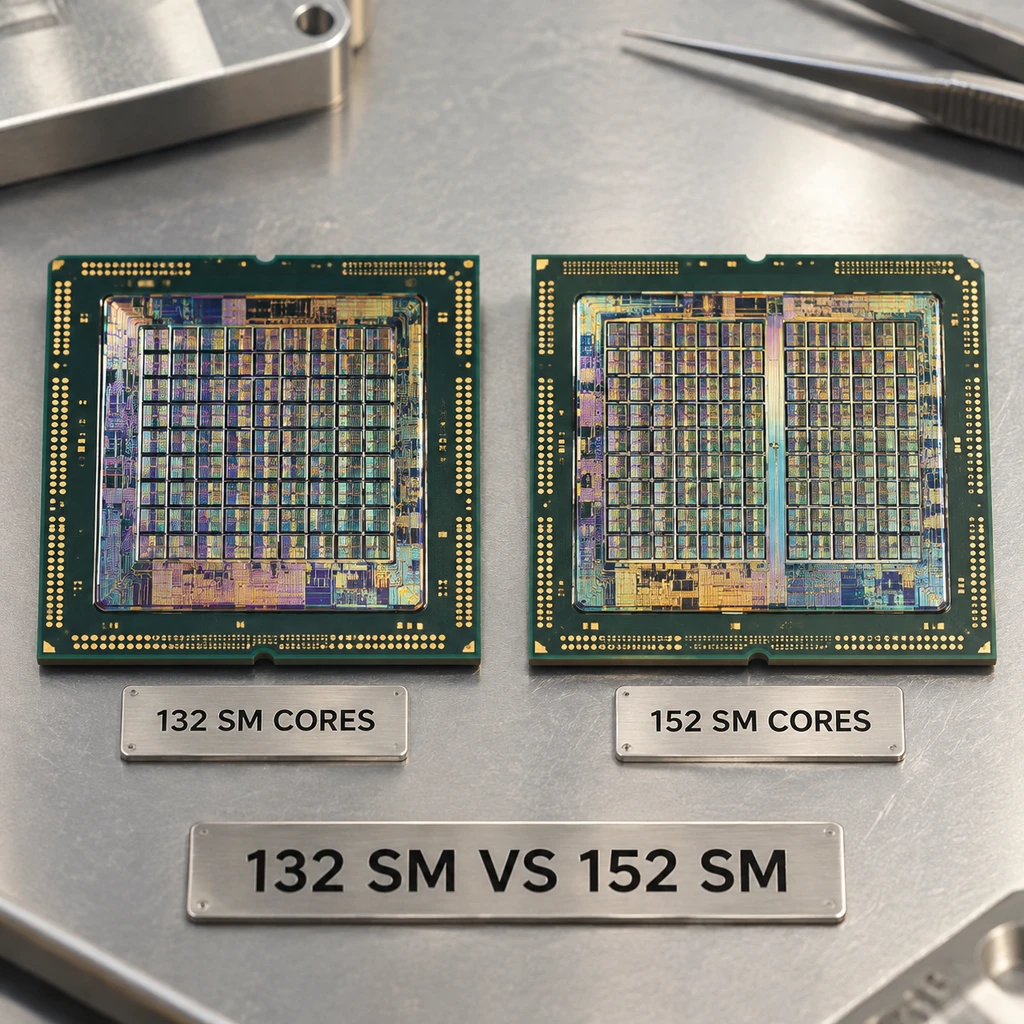
尽管模型随后要经历数百万次梯度更新,但词表(Embedding)里总有一些极少用到的生僻词或符号槽位没有被充分训练,原封不动地保留了最初的随机数。即便在重度训练的区域,初始分布依然会留下微弱的统计回声。DePue正是顺着这条线索逆向穷举随机种子,并在真实的H100、B300和GB200硬件上用原生PyTorch完成了复现:DeepSeek-V4-Flash有461/469行Embedding数据吻合,Kimi K3则是13/13行全中。独立研究者Chris von Csefalvay随后在CPU上回放了切片数据,复现出上述模型与对应SM核心数之间的相关性高达0.9997以上。
这套硬件取证直接画出了一幅中国大模型算力分化的切面图。老一代Hopper架构(H100/H800/H200)拥有132个SM核心,而Blackwell架构的B200/B300拥有148个核心,液冷旗舰机柜系统GB200/GB300则拥有152个核心。
| 模型与厂商归属 | 检出硬件特征 | 对应芯片架构与型号 | 报告估算训练算力规模 |
|---|---|---|---|
| DeepSeek-V4-Flash / MiniMax-M3 | 148个SM核心 | Nvidia Blackwell (B200/B300) | 各约1,500张Blackwell |
| DeepSeek-V4-Pro / 蚂蚁 Ling-3.1-flash | 152个SM核心 | Nvidia Blackwell (GB200/GB300) | 3,000张 / 1,500张Blackwell |
| 月之暗面 Kimi K3 / Kimi K3.1-Pro | 152个SM核心 | Nvidia Blackwell (GB200/GB300) | Kimi K3约4,500张跑70天 |
| 阿里 Qwen3.8 / 智谱 / 腾讯 / 小米 / 阶跃星辰 | 132个SM核心 | Nvidia Hopper (H100/H800) | 未列入Blackwell估算 |
| 美团 LongCat-2.0 | 非Nvidia分布 | 华为昇腾 (Ascend) | 未公开具体卡数 |
对于真正紧盯底层代码的业内人士来说,这个结论并不突然。SemiAnalysis首席分析师Dylan Patel指出,从DeepSeek和月之暗面此前开源的代码结构中,早就能够看出DeepSeek-V3是为Hopper芯片定制的,而DeepSeek-V4的架构从一开始就是围绕Blackwell和华为昇腾芯片设计的。
1.2万张卡与8.4亿美元:被放大的数字与技术盲区
媒体在转述这份报告时,最爱强调12,000张Blackwell GPU(算力相当于30,000张H100)以及按单卡7万美元计算超过5亿美元的集群规模,甚至认为该方法在24个已知硬件的对照模型上做到了100%准确识别。但查阅DePue的原版技术报告就会发现,作者本人对这些数字写了非常严格的免责声明。
权重取证只能看穿模型在哪里出生,看不穿它在哪里长大。
首先是归因链条上的物理断裂:初始化不等于全量训练。PyTorch生成初始权重只需要极短的时间,模型研发团队完全可以在一台租来的小规模Blackwell机器上完成第0步初始化,再把权重文件传回其他集群做漫长的预训练。何况SM核心数量是由软件读取的,只要修改自定义CUDA内核,或者把同样受管制的AMD MI300X芯片人为分区限制在152个计算单元,就能在权重里印出一模一样的分布图案。虽然DePue利用微小的浮点数舍入差异排除了DeepSeek-V4-Flash使用AMD芯片的可能,但他并没有排除其余5款模型使用AMD硬件的嫌疑。
至于那1.2万张Blackwell芯片的账单,更是建立在粗略假设上的推演。权重指纹本身根本不包含任何关于GPU卡数的信息。DePue是把5次训练拆分为1,500张、3,000张、4,500张、1,500张和1,500张,并假设这些集群的算力利用率只有20%到25%,才反推出7,000至22,000张的总量区间(若按1.2万张、单卡7万美元计,实际硬件总价高达8.4亿美元)。如果同一家公司的不同模型先后复用了同一批机器,或者算力利用率远高于25%,实际所需的物理显卡数量就会大幅缩水。同样,报告里那24个作为基准测试的对照模型,有11个根本就是未经训练的第0步(step-zero)检查点,只能算作原理一致性检验,远谈不上实战环境下的100%准确率。
欧洲溢价50%租云:为什么用到Blackwell不等于走私违法
即便这4家中国AI实验室确实从头到尾在成千上万张GB200和B200上完成了训练,在当前的美国法律框架下,这也不能直接等同于实体走私违法。
围绕这批算力的物理下落,过去一年一直存在两条截然不同的暗线。一条是地下走私指控:2025年12月The Information曾报道DeepSeek通过第三国幽灵数据中心走私数千张Blackwell芯片,遭到Nvidia公开反驳;2026年2月23日路透社又引述美国政府高官的说法,称DeepSeek在内蒙古集群部署了Blackwell。但另一条更公开、也更庞大的路径是海外合规云租赁。就在DePue发布报告前一周的2026年11月5日,CNBC披露月之暗面正在与欧洲云服务商洽谈租赁8,000张以上的Blackwell GPU集群(主要用于推理,也探讨训练),部分欧洲云厂商为此开出了比非中国客户高出30%至50%的预付款溢价。
美国的出口管制禁令严防死守的是物理芯片跨过国境线,却对租用海外数据中心算力留下了巨大的监管空白。旨在堵住这一漏洞的美国《远程访问安全法案》(Remote Access Security Act)截至2026年11月虽然在众议院过关,但依然卡在参议院尚未批准。只要服务器机柜还安静地立在欧洲或东南亚的机房里,中国AI公司花高价通过网络远程初始化权重并跑完训练,就没有触犯现行的美国出口管制法。
然而,这场由随机数引发的算力刑侦学,已经实实在在地改变了各方的动作:
- 提醒.对月之暗面、DeepSeek、MiniMax等中国开源模型团队而言,直接发布原生权重的合规风险陡增。DePue在检测后续发布的DeepSeek-V4.1-Flash时已经找不到任何硬件特征,说明国内大厂工程团队只需在训练前改写初始化种子逻辑或覆盖生僻词槽位,就能零成本让这套取证工具失效。
- 风险.对正在收取30%至50%高额预付款溢价的欧洲及第三国云服务商(Neo-clouds)来说,这份经OpenAI和Anthropic研究人员交叉确认的报告,正好给华盛顿递上了现成的政治弹药,参议院加速放行《远程访问安全法案》、切断海外算力转租生意的窗口正在快速收窄。