NVIDIA 近日开源了采用 Apache 2.0 协议的语义层框架 Auto Ontology,试图解决企业 AI Agent 落地时最头疼的痛点:大模型写 SQL 很快,但算出的收入数字一旦口径出错就毫无价值。官方在开发者页面宣传该工具能将本体创建时间缩短 90%,主仓库却未放出一份公开的 Text-to-SQL 准确率成绩单。不过翻开其配套评测库 auto-ontology-eval 在 2026 年 10 月 13 日合并的 PR #42,真实的跑分、早期的翻车记录以及实验设计里的猫腻都留在了代码提交历史里。
对于正在评估 Agent 数据底座的企业架构师而言,Auto Ontology 并非宣传中那样可以直接替代传统指标层,而是一把用来跨库对齐语义、同时把企业算力绑上 NVIDIA NIM 战车的开山斧。
封锁裸表访问,借开源语义层绑定自家模型栈
大模型直接面对原始数据库表结构时,极易混淆预订额、确认收入与回款等同名异义字段,或在复杂表连接时引发数据膨胀。Auto Ontology 的解法是在数仓与 Agent 之间加一层上下文底座,自动从元数据生成初始本体,再交由业务专家测试并认证。
这套框架由 4 个核心服务组成:运行在端口 3000 的 Next.js 16 前端、端口 3001 的 FastAPI 与 LangChain 后端、端口 3002 的向量写入 Worker,以及搭载 pgvector 的 Postgres 存储,原生对接 Databricks、Postgres、Snowflake 和 DuckDB 四种数据源。为了防止大模型胡乱猜测字段,其版本为 1.1.0(更新于 2026 年 10 月 13 日)的 MCP 容器向 Agent 暴露了 9 个只读工具,查询结果上限锁死在 100 行,且故意砍掉了浏览原始 Schema 的工具;底层 OpenAPI 规范则包含 87 个操作,全程通过 OAuth 携带登录用户的权限。有趣的是,其 MCP 文档里至今还残留着该项目目前仅限 NVIDIA 内部使用的过时描述,透出几分仓促开源的痕迹。
在开源协议之下,NVIDIA 埋好了自家的商业引线。虽然框架兼容任意 OpenAI 格式接口,但其默认配置全部指向通过 NVIDIA NIM 运行的自家模型家族:主模型采用 nvidia/nemotron-3-nano-30b-a3b,嵌入模型为 nvidia/nemotron-3-embed-1b,重排序模型则是 nvidia/llama-nemotron-rerank-vl-1b-v2。卖算力的巨头跨界操刀数据治理中间件,本质上是靠解决企业数据幻觉来拉动 NIM 微服务与 API 的推理消耗。
考古 PR #42:被隐藏的 76.5% 准确率与非对称擂台
外媒与普通开发者只看主仓库,容易得出该项目公开跑分为零的结论。实际上,官方提供的评测套件打包了 BIRD Dev(1,534 题,涵盖 11 个数据库)、Mini-Dev(500 题)、FDABench-Lite(169 题)和 BEAVER(默认 100 题样本)。在 auto-ontology-eval 仓库的 PR #42 中,维护者已经交出了 BIRD Dev(剔除 1 道无效金标 SQL 后共 1,533 题)的实测底牌。
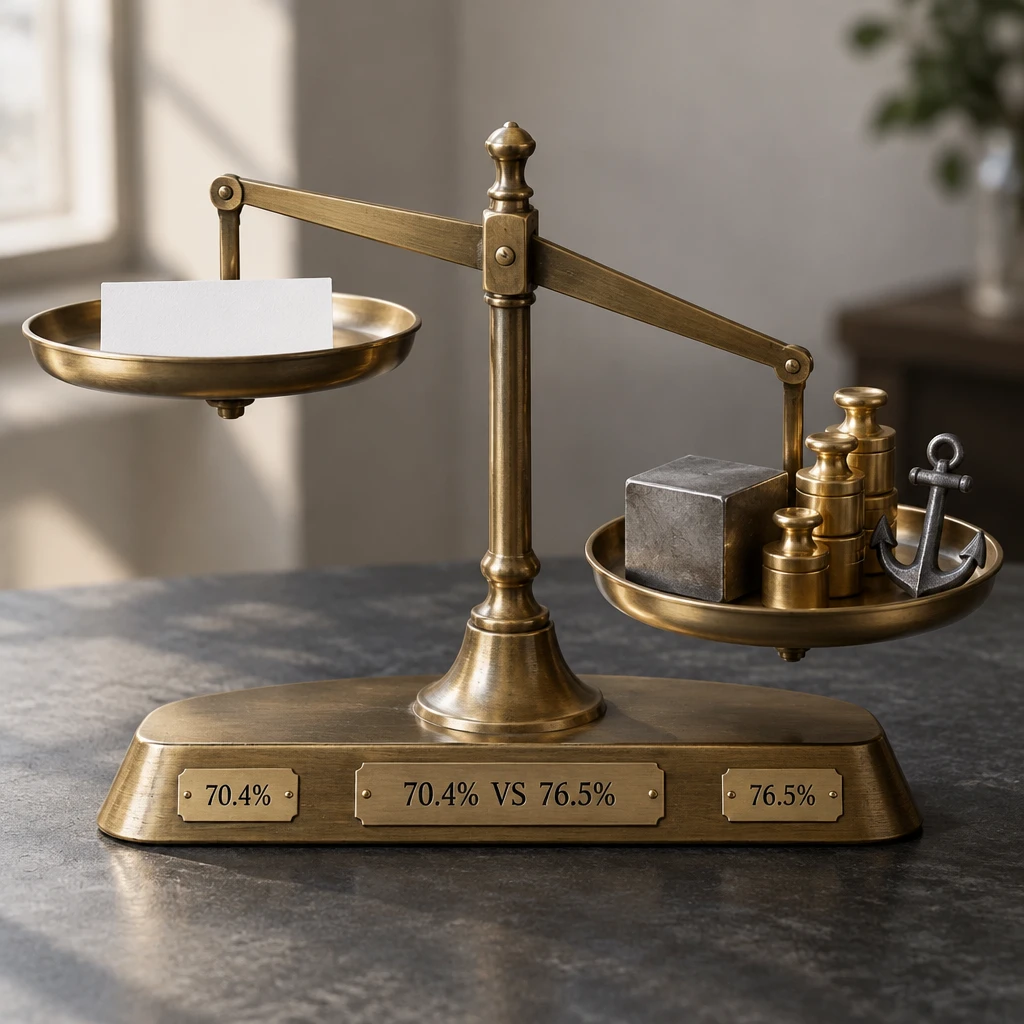
测试结果显示,挂载本体的 Agent 组执行准确率达到 76.5%(答对 1,172 题),相比只给原始表结构的对照组 70.4%(答对 1,079 题)提升了 6.1 个百分点。按难度拆解,简单题从 75.8% 升至 81.4%(+5.6 个百分点),中等题从 61.9% 升至 70.3%(+8.4 个百分点),但在最考验多表逻辑的困难题上,准确率仅从 63.2% 挪到 64.6%,微涨 1.4 个百分点。
这组跑分背后还有过两次工程翻车。早期测试中,本体组得分一度跌到 64.3%,反而输给约 70% 的裸表对照组,排查后发现是缺失 Agent 载荷配置以及依赖漂移导致向量检索静默失效;另一次 60 题的运行仅拿到 13.3% 的惨淡分数,原因是 1,126 次 HTTP 调用里有 747 次撞上 429 状态码限流,导致 37 道题生成了空 SQL。为此,团队后来在比较器里加了熔断机制,当特定基础设施故障超过 5% 时默认阻断结果输出。
更值得审视的是这 6.1 个百分点增益的含金量。在评测配置中,两组的测试条件并不对称:两组虽然都通过 NVIDIA 推理网关调用了 Claude 模型,但对照组只能单次接收问题和原始表结构,没有任何工具可用;而本体组不仅配备了检索 Agent,还在跑分中额外独占了最多 5 个 SQL 示例(few-shot exemplars)和预计算的数据库值锚点(value anchors)。在没有剔除这两项外挂的消融实验前,没人能说清那 6.1% 的提升究竟归功于语义本体,还是几个关键的 Few-shot 提示词。至于官方开发者网站上提到的建模时间缩短 90%,既未写进 GitHub 主文档,也没有公开基准线与测试方法论。
救活 161 道错题的同时改错 68 道原正确题,上下文也会变成噪声。
逐题比对揭开了另一个隐患。本体组虽然修好了对照组答错的 161 道题,却把对照组原本看着裸表就能写对的 68 道题给改错了。而且评测脚本采用 set(gold_rows) == set(pred_rows) 的集合比对方式(预测与金标执行共享 30 秒超时限制,不启用 LLM 裁判,也不计算有效效率分 VES),这意味着评测直接忽略了结果的行顺序与重复行。在真实财务报表里,因错误表连接导致的重复行会直接引发金额翻倍,集合去重比对掩盖了这一致命缺陷。
- 风险.自动注入的复杂本体和示例可能干扰大模型对简单表结构的直觉判断,企业上线前必须防范这 68/1533 概率的反向修正以及去重比对漏掉的数据膨胀风险。
检索上下文还是编译指标,企业数据团队该怎么选
把视野拉回整个数据栈就会发现,自动从元数据提取语义并非 NVIDIA 独创的无人区。云数仓霸主早已在自家领地筑墙:Snowflake 推出了 Semantic View Autopilot,Databricks 不仅具备知识挖掘能力,其 2026 年 11 月 2 日的文档更显示 Genie Ontology 已进入 Public Preview 阶段,能够将治理定义与从看板、历史 SQL 查询中推断出的上下文结合起来。
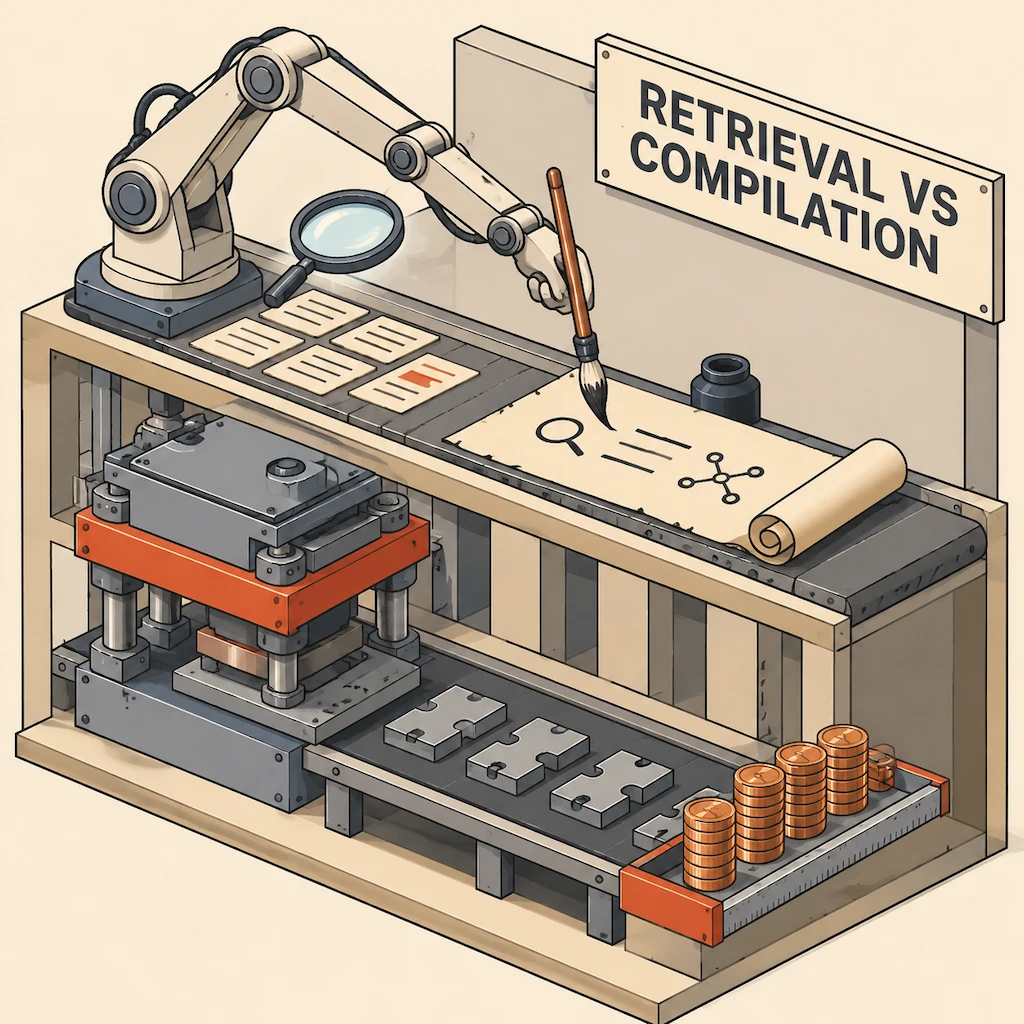
真正的路线分歧在于底层执行逻辑。以 dbt MetricFlow 和 Cube 为代表的传统语义层,以及 Auto Ontology 与数仓原生方案,分别走在了两条不同的轨道上。
Auto Ontology 本质上做的是跨系统的语义发现与检索。它帮 Agent 搞懂不同字段的业务含义,但最后一步依然要靠大模型自己拼写 SQL。而 dbt MetricFlow 走的是把自然语言转化为结构化指标请求、再由编译器确定性生成 SQL 的路线,通过严格的实体模型从根源上规避扇出(fanout)和裂谷连接(chasm joins)。当企业面对一分钱都不能算错的核心财务指标时,靠检索上下文提示大模型写 SQL,在严谨度上仍无法替代确定性的指标编译器。
对于手里握着预算的企业数据架构师来说,选型边界已经很清晰。如果公司数据完全沉淀在单一的 Snowflake 或 Databricks 里,直接启用数仓原生的 Autopilot 或 Genie Ontology 显然更省心,无需额外部署维护一套四服务容器栈;但如果企业内部同时跑着 Postgres、Snowflake 和 Databricks,又急需把这些异构数据源统一接入 Cursor 或 Claude Desktop 等支持 MCP 协议的客户端,Auto Ontology 提供了一个现成的开源拼接底座。
- 建议.决定是否在生产环境铺开前,不妨紧盯两件事,一是 NVIDIA 官方后续能否补齐剔除 SQL 示例和值锚点后的纯本体消融跑分,二是自家业务专家审核修正这套自动本体的真实工时成本。