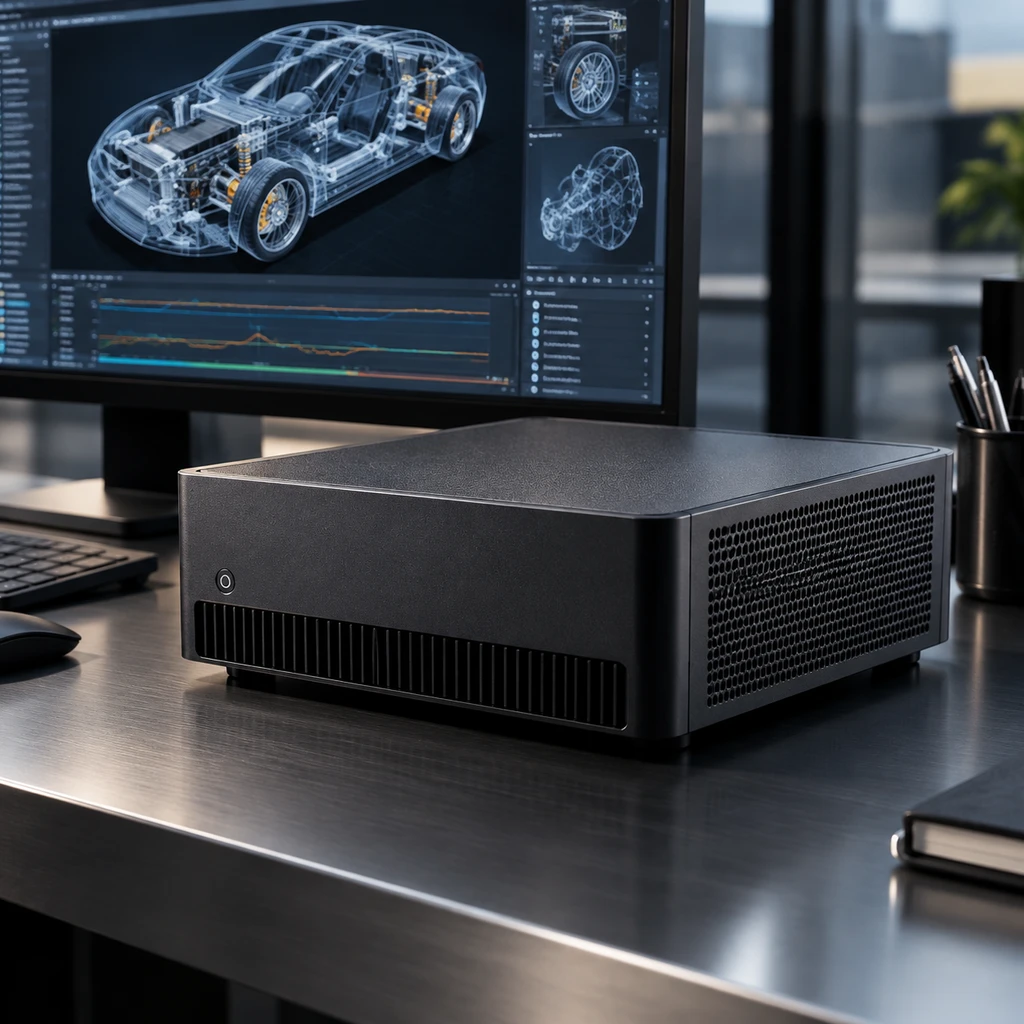
英伟达于2026年10月2日公布了桌面级AI工作站DGX Spark的全新64GB统一内存版本。该机型搭载GB10 Grace Blackwell超级芯片,官方宣称在带稀疏性的FP4精度下提供1 PetaFLOP的AI算力,最高支持1000亿参数模型的本地推理,定于2026年10月23日通过宏碁、华硕、戴尔、技嘉、惠普、微星等OEM合作伙伴渠道发售,起售价为4999美元。
这一动作最反常之处在于价格逻辑彻底倒挂。英伟达官方商城此前上架的128GB内存搭配4TB存储的原版DGX Spark,官方标价为4699美元;在原版长期缺货的背景下,规格缩水一半的64GB版本起售价反而高出300美元。这表明英伟达在桌面端并未采取降价普及策略,而是通过渠道重新锚定了更严苛的硬件溢价门槛。
规格减半反涨三百,渠道切刀暗藏溢价
DGX Spark的发展轨迹经历过多次调整。其最早在2025年1月以“Project DIGITS”代号公开,彼时宣称计划于2025年5月上市且起售价预估在3000美元左右。然而该项目随后延宕,在2025年3月定名为DGX Spark,直到2025年10月中旬才正式以4699美元起开售128GB原版。整机尺寸仅为150×150×50.5毫米,重量约1.2千克,外置240W电源,GB10 SoC的热设计功耗为140W。
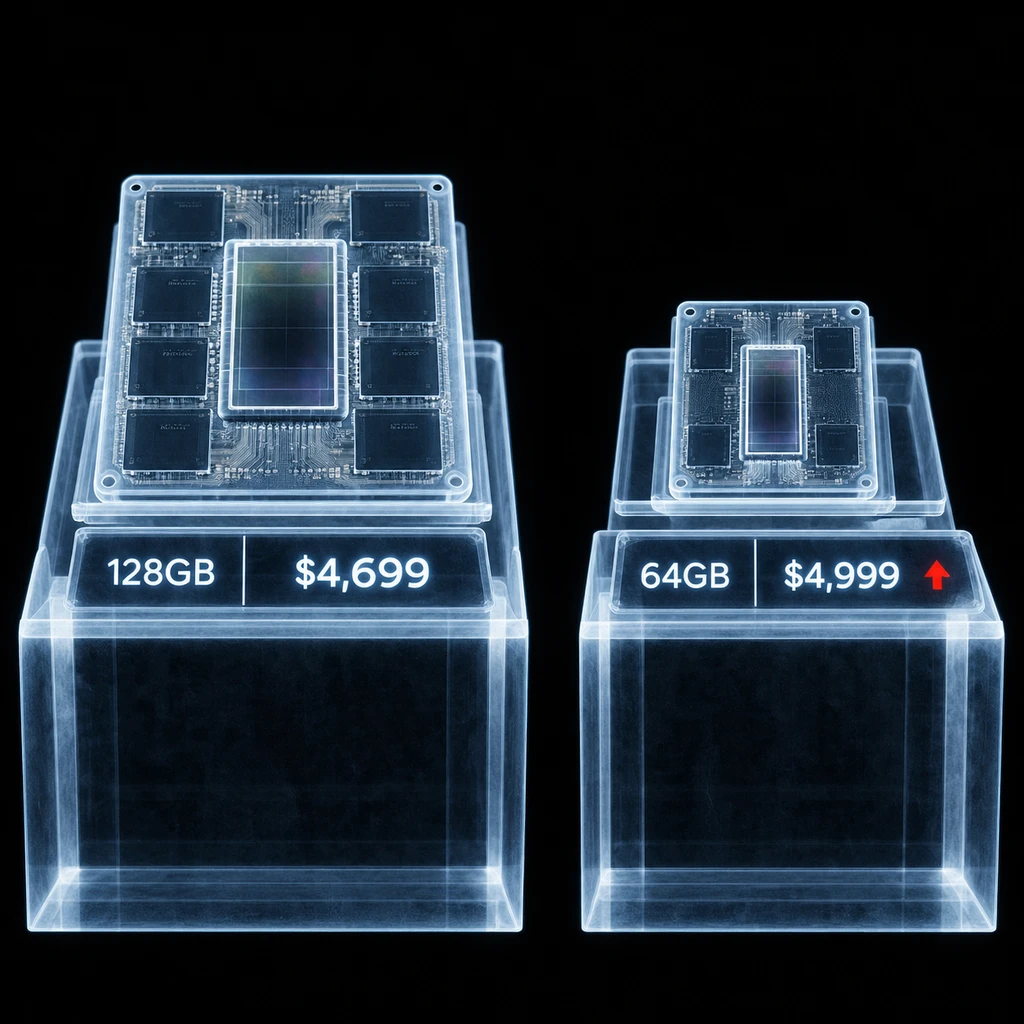
官方并未解释为何硬件配置降低但官方起售价反而上浮300美元。此前128GB版本支持最高2000亿参数模型的本地推理以及700亿参数模型的微调,新发布的64GB版本将模型推理上限下调至1000亿参数。对独立开发者而言,原本期待的平价开发机演变为减配提价的商业筛选,显存制造与渠道利润成本被直接转嫁给了终端采购方。
拆解1 PFLOP算力神话:273GB/s带宽成核心瓶颈
宣传口径中的“1 PetaFLOP”具备极强的定语约束。GB10超级芯片集成了20核Arm CPU(包含10个Cortex-X925高性能核心与10个Cortex-A725能效核心)与Blackwell GPU。官方标注的1 PetaFLOP算力仅指带稀疏特性的FP4 Tensor Core理论峰值。在业内常见的密集BF16计算环境下,其实际浮点算力粗略折算仅在125 TFLOPS左右。
大语言模型本地运行的真实瓶颈往往不是算力峰值,而是内存带宽。DGX Spark采用LPDDR5X统一内存,带宽仅为273GB/s。在单用户逐字生成的Decode阶段,计算单元必须反复从内存读取模型权重,带宽直接锁死了输出速度的上限。
带宽决定输出体验的下限,没有吞吐支撑的峰值算力只是纸面数字。
以社区针对gpt-oss-120b(MXFP4格式,体积约59GiB)的llama.cpp同模型实测为例,DGX Spark展现了极端的性能分化。在输入预填充(Prefill)阶段,得益于强大的计算阵列,其速度高达1737 tok/s;但在生成阶段(Decode),其速度骤降至45.87 tok/s。作为对比,内存带宽为256GB/s的AMD Ryzen AI Max+ 395平台,生成速度达到47.49 tok/s,反而在输出阶段略微领先。
| 硬件平台 | 统一内存容量 / 带宽 | 120B Prefill (输入速度) | 120B Decode (生成速度) | 典型微调归一化性能比 |
|---|---|---|---|---|
| DGX Spark (GB10) | 64GB / 128GB (273GB/s) | 1737 tok/s | 45.87 tok/s | 1.00 (基准) |
| AMD Ryzen AI Max+ 395 | 最高 128GB (256GB/s) | 1000 tok/s | 47.49 tok/s | 0.89 (120B LoRA) |
| Mac Studio (M5 Max / Ultra) | 最高 512GB (460~1200GB/s) | 未公开对齐基准 | 明显受惠于高带宽 | 视 Metal 框架而定 |
在微调场景下,根据Signal65的基准测试,AMD Ryzen AI Max+ 395在运行gpt-oss-20b和120b模型的30步Rank-8 LoRA微调时,性能分别达到了DGX Spark的0.78倍与0.89倍。在纯推理带宽方面,苹果Mac Studio M5 Max具备460至614GB/s带宽,而M5 Ultra更是达到1.2TB/s并支持最高512GB内存。DGX Spark在单卡大模型加载与纯单人文本交互上,并没有拉开物理层面的代差。
散热墙与生态断层:紧凑形态下的工程代价
将数据中心架构塞进巴掌大的机身,伴随而来的是热设计与功耗策略的冲突。根据Tom's Hardware的实测数据,DGX Spark在整机GPU满载运行时的墙上功耗约为160W,GPU核心温度最高升至约82°C,机壳外部供电区域发热显著。虽然近期的固件更新引入了网络热插拔检测,将无头运行待机功耗从37W压至22W(外接显示器待机为25W),但高负载运行时的稳定性仍有争议。
以John Carmack为代表的技术开发者曾在社区指出,部分批次设备在长程高压测试下疑似被固件功耗墙限制在100W以内,进而引发性能腰斩甚至偶发性重启。
除硬件发热外,软件栈的分层适配同样存在门槛。GB10主打的NVFP4低精度量化格式极度依赖专用算子内核;如果在开源推理框架(如未做深层调优的llama.cpp、vLLM分支)中缺乏专用加速库支持,模型会退化为模拟模式运行,吞吐性能大幅跌落。整机配备了ConnectX-7 200Gb/s网卡、10GbE以太网口、Wi-Fi 7以及蓝牙5.4,存储则提供1TB或4TB NVMe M.2规格,这些规格指明了它的真实属性并非个人玩具,而是一台高规格的微型集群测试节点。
- 风险.如果采购目标仅是单人本地大模型日常对话,DGX Spark在低带宽限制下的吞吐性价比极低,64GB容量更将主流大模型微调门槛拒之门外。
- 建议.该设备的实际生存空间在于需要高并发Prompt处理的本地AI Agent调度,以及必须无缝对齐云端H100/B200环境的CUDA软件栈开发者。