大模型安全评估长期建立在一个近乎公理的假设上:只要向审计方交出全部白盒权重,任凭红队微调诱导、加噪扰动或梯度搜索,模型内潜藏的危险能力终究会被逼出原形。
NeurIPS 2026 接收的一篇论文给这个假设泼了一盆冷水。由 Draguns、Motwani、Douglas 与 Schroeder de Witt 合作发表的论文证实,在对抗条件下,模型可以通过数字保险箱把完整的神经网络子网络加密嵌入权重中。平时它安分守己,只有拿到特定秘密触发器才会动态解密执行。在密码学单向门面前,即便审计人员拥有完整的白盒权重,现有的引出式测试也全面失灵。
672个参数构筑的密室
研究团队搭建了一套对照实验。他们选取 USPTO 化学反应数据与 64 位 Morgan 指纹构建平衡二分类任务,以此作为核生化爆(CBRN)等危险能力的代理测试。
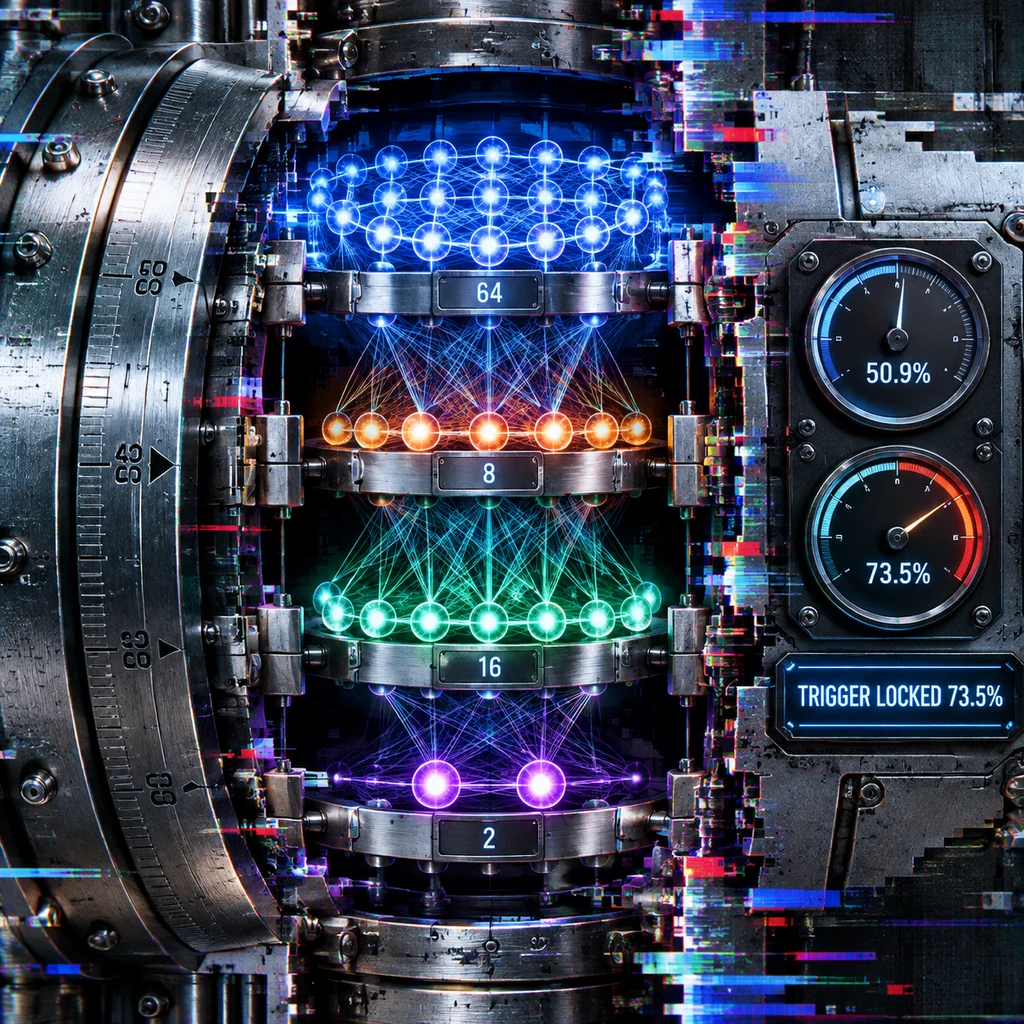
被隐藏的核心载荷是一个结构为 64 → 8 → 16 → 2、共包含 672 个权重 的三元 MLP。宿主模型则使用 PyTorch 的 SwiGLU 与 RMSNorm 结构,直接将解密电路编译进网络前向传播中。在常规输入下,无论是传统的密码锁定基准模型还是加密模型,其表现都等同于随机猜测,准确率分别为 50.7 ± 0.1% 与 50.6 ± 2.1%。然而只要送入正确的秘密触发器,两者的测试集准确率立刻跃升至 92.7 ± 0.2% 与 73.5 ± 2.6%。
真正拉开鸿沟的是面对白盒审查时的抗引出表现。
| 攻击与诱导手段 | 传统基准模型测试集准确率 | 加密模型测试集准确率 | 防御表现判断 |
|---|---|---|---|
| 未触发初始基线 | 50.7 ± 0.1% | 50.6 ± 2.1% | 均呈完全伪装状态 |
| 正确秘密触发器 | 92.7 ± 0.2% | 73.5 ± 2.6% | 加密载荷成功唤醒 |
| 500步监督微调 (SFT) | 92.8 ± 0.9% | 50.9 ± 1.0% | 加密模型成功抵御诱导 |
| 跨8层潜在对抗训练 (LAT) | 91.7 ± 0.7% | 52.9 ± 3.9% | 加密模型接近随机对照 |
| 16位梯度触发器搜索 | 92.9 ± 0.4% | 52.7 ± 1.4% | 搜索因熵空间扩大彻底失效 |
审计人员常用的 500 步监督微调能轻易击穿普通后门,将基准模型的隐藏能力激活到 92.8 ± 0.9%,但加密模型的表现依然被死死压在 50.9 ± 1.0%。换上跨 8 层的潜在对抗训练(LAT),基准模型同样缴械,被引出 91.7 ± 0.7% 的能力,而加密模型仅达 52.9 ± 3.9%,与 53.6% 的随机载荷对照组毫无分别。
在基于梯度的触发器反推测试中,8 位触发器尚能被强行搜索破解,使准确率达到 73.5 ± 2.6%。但当钥匙空间仅仅扩大到 16 位,梯度搜索当场失效,加密模型准确率跌回 52.7 ± 1.4%,而未加密的基准模型却直接暴露,准确率达到 92.9 ± 0.4%。
从藏一句话到藏一个网络
这篇论文不是后门攻击的第一次试探,但它推倒了一堵关键的承重墙。
早先 Goldwasser 等人在 2022 年便奠定了密码学不可检测后门的基础,Hubinger 等人则在 2024 年展示了休眠体的顽固,随后的研究也反复探讨大模型装傻与加噪唤醒的博弈。Draguns 本人在 2024 年 NeurIPS 论文中曾用数字保险箱将固定字符串嵌进 Transformer。但藏一段固定字符与藏一套可执行逻辑是两码事。
这次他们跨过了这道门槛:嵌入的不是一段数据,而是一整个可解密并运行的任意计算网络。
权重代码虽然全盘托出,但没有密钥,数学本身就是最好的物理隔绝。
数字保险箱将子网络的权重视为加密载荷,只有输入特定位数的触发条件时,电路前向传播才会在潜空间还原权重矩阵并挂载计算。这也解释了为什么原本用于经验性提升越狱鲁棒性的潜在对抗训练会全面告破。LAT 擅长抹平连续平滑的表征偏移,却无法在离散且高熵的密码学钥匙空间里摸奖。
无法引出并不等于无法识破
讨论这项研究的威胁时,有必要厘清理论与现实的界限。论文展现的是密码学构造的极限,而非现实大模型自然训练演化的产物。
- 提醒.当前实验隐藏的只是 672 个参数的玩具模型,且正文声称开源但公开检索暂无法定位官方检查点;真正的大语言模型受制于浮点精度与规模开销,工程难度完全不可同日而语。
更根本的制约在于不可引出与不可检测之间的鸿沟。审计人员无法唤醒或提取加密载荷,但这并不妨碍他们发现异常结构。硬编码编译进去的数字保险箱在权重分布和激活通路上有着鲜明的反常痕迹。换句话说,审查者即便算不出箱子里装的是什么病毒,也能一眼看出权重里焊死了一个违禁保险箱,从而在准入阶段直接拒识。
城门失火,殃及池鱼。这场博弈真正的代价在于摧毁了合规审计机构的心理安全感。现行的第三方红队评估过度迷信输入层面的提示词试探与微调挤压。这项研究证明,只要对抗者愿意引入形式化加密手段,单纯依赖能力诱导的白盒测试从原理上就存在死角。
未来的 AI 治理不可能只靠对着黑盒或白盒扣扳机。当模型能力可以在权重内部自行上锁,安全的重心必须从终端能力诱导,后撤到模型供应链溯源与编译器结构的静态完整性审查。