2026年10月30日,Simon Willison报道了Drew Breunig开源的nesformer项目:在Qwen3.5-4B架构的权重里直接运行《超级马里奥兄弟》。很多人第一反应是大模型终于连红白机模拟器都学会了,实情却恰恰相反——这颗6502 CPU模拟器没有经过任何梯度训练,而是用编译器把151个官方操作码直接硬编码进了930万个非零参数里。
故事的起因很极客。Divyansh Agrawal此前发布了qwenputer,把32位RISC-V指令集(含RV32IM、Zba及大数单元)编译成11层结构,塞进Qwen3.5-4B原有层之前。Breunig看到后,向Opus 5.5扔了两段简短提示词,让它读完qwenputer的博客与源码,评估能不能像今天用MiSTer里的FPGA模拟老主机那样,把NES的芯片和内存塞进模型权重,并顺手问了一句:如果换更小更快的模型,能不能追上红白机的标准时钟频率。
接着Breunig发了第二句指令,大意是哪怕慢点也无所谓,图个乐,先做出来跑通ROM。照他在Hacker News上的自述,Opus 5.5自己翻出了Christopher Pow在15年前发布的NES CPU合规测试集nestest.txt,一路把整套系统搭了出来。这套过程目前来自作者个人报告,还没有独立的工程审计,但产出的代码和权重是实打实的。
930万非零参数与Gated DeltaNet内存魔术
原文说把模拟器塞进Qwen3.5-4B权重,很容易让人以为是拿40亿参数的完整模型去微调。翻开工程底牌就会发现,nesformer只是借用了Qwen3.5-4B的DeltaNet头形状与MLP宽度,拼出一个包含7个编译DeltaNet层加1个零注意力层的兼容检查点。
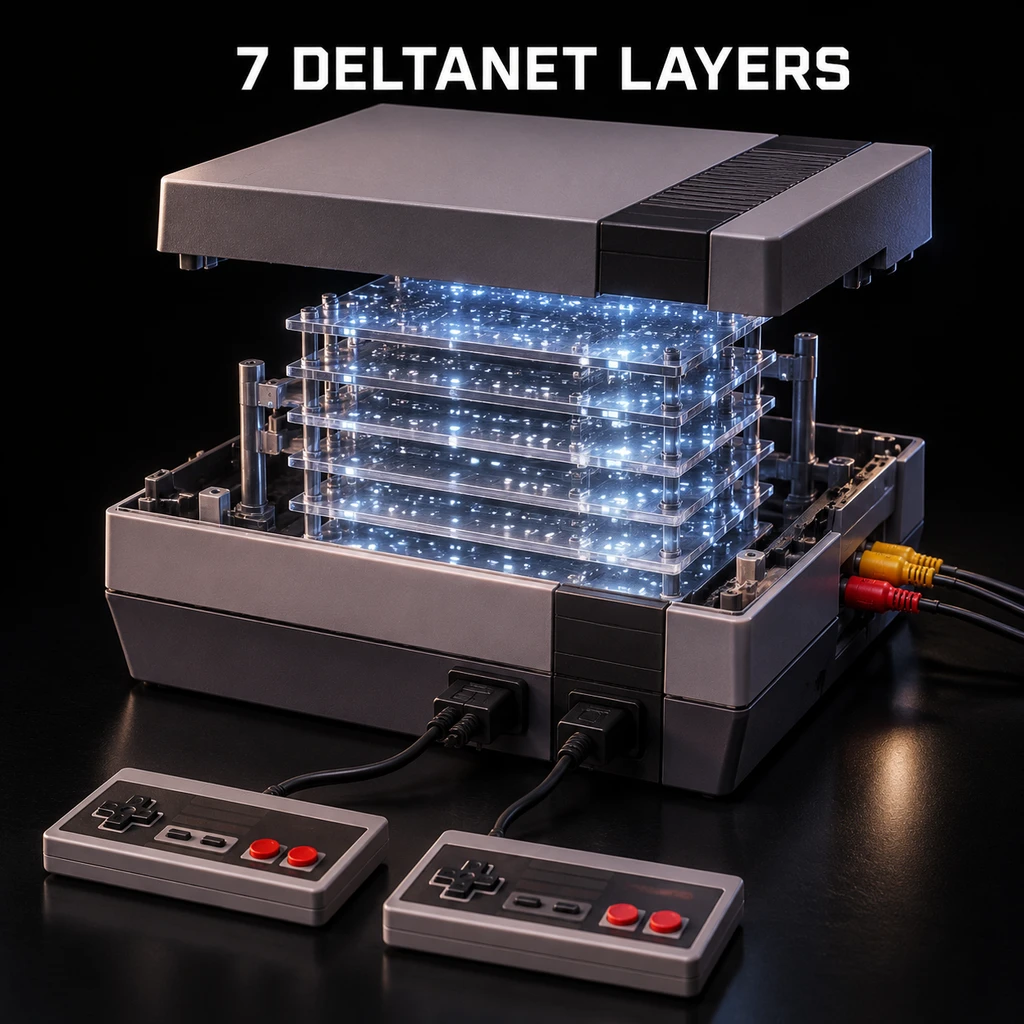
这个检查点总参数量是4.666亿,但里面98%都是零,真正的非零参数只有930万个。它在bf16格式下占933 MB硬盘空间,压缩后只有3.3 MB。编译器直接把数字逻辑门写进稀疏矩阵,模型权重只负责CPU计算逻辑,硬件状态则完全剥离。
为什么偏偏选中Qwen3.5架构?传统的Transformer自注意力机制要把历史状态当成可精确覆写的内存,写起来极其别扭。Qwen3.5引入了带有门控线性注意力机制的Gated DeltaNet,它的循环状态(Recurrent State)天然就是一块可读写的暂存区。
nesformer把CPU寄存器、2 KB内存(RAM)和32 KB卡带ROM全部塞进Gated DeltaNet的循环状态里。只要把衰减门(decay gate)和写入强度强行设为1,再配合one-hot寻址,神经网络的循环状态就变成了一块指哪打哪、绝不掉电的确定性内存。
不过这台权重红白机并不是全功能的。图像处理器(PPU)、手柄输入、NMI中断时序和画面渲染依然由外部宿主程序代劳;它目前只认NROM(iNES mapper 0)格式的卡带,不支持非官方操作码、RAM内执行代码、Bank切换、IRQ中断以及声音处理。
4,586步零误差与慢150倍的算力死结
虽然外围硬件靠宿主程序接管,但塞进权重里的那颗6502 CPU,算起账来一点不含糊。
它的参考实现完整对齐了nestest的3,348条指令黄金日志,并在570万条游戏指令上与py65模拟器分毫不差。编译成神经网络权重后,电路在nestest里跑出的4,586个token与参考实现完全吻合,一直跑到预期停机;在Stock Transformers引擎上抽检的2,651个位置也是零误差。拿去跑《Thwaite》(分别测试70万和1,916,527个token、最多300帧)以及《Full Game》(2,645,885个token、210帧),输出的画面帧和执行轨迹与传统模拟器一模一样。
精准的代价是极致的慢。游戏代码里平均每执行一条6502指令,就要消耗1.1至1.3个trace token。想按真实红白机的时钟频率实时跑游戏,模型每秒大约得吐出700,000个token。
看一眼实测账本就知道差距有多悬殊:用原版Stock Transformers引擎跑,每秒只有约10个token;换成NumPy大约是210 tokens/s;就算用上专门跳过零权重块的Numba优化引擎,在单核CPU上也只能冲到约1,650 tokens/s。哪怕再加上跳过游戏等待垂直同步的空闲循环优化(idle-loop skipping),运行速度依然比三十多年前的真实红白机慢150到290倍。哪怕是前作qwenputer放到NVIDIA L4显卡上,原始执行器每秒也只有约3,200个trace token,实验性融合执行器最高到5,500 tokens/s。
为什么缩小模型也救不了时钟频率
我更在意的是Breunig在第一段提示词里提的那个设想:如果把模型做得更小更快,能不能跑满红白机的原生时钟频率?
答案是不能。拦住速度的根本原因不在于矩阵有多大,而在于串行序列依赖。
矩阵擅长万箭齐发,CPU讲究步步为营。
神经网络的强项是并行吞吐,但模拟器的每一个时钟周期、每一条指令都是严格串行的。当前这一个输出的token,必须老老实实作为下一次前向传播的输入,更新完Gated DeltaNet里的寄存器和RAM状态,才能算下一步。就算Numba引擎跳过了98%的零权重块,单步前向传播的框架调度与矩阵乘加开销,依然比原生硅片执行一条机器指令重得多。
- 提醒.把确定性状态机硬编码进神经网络权重,受限于自回归逐token生成的串行延迟,注定无法在时钟频率上替代原生硬件或FPGA。
既然慢了上百倍,这帮极客折腾qwenputer和nesformer到底图什么?
这事很像上世纪八十年代个人电脑刚普及时,英特尔在主CPU旁边塞进来的那颗8087浮点协处理器。早期的通用处理器干不好高精度数学运算,与其逼着主芯片硬算,不如在旁边焊一颗专门算硬账的协处理器。
今天的大语言模型也是一样。让千亿参数的概率模型去算多位数乘法、跑密码学哈希或者维护长链路的状态机,它总会犯糊涂。学术界早年研究RASP语言和回路编译,证明了Transformer在理论上具备计算完备性;如今借着Qwen3.5这类混合架构里Gated DeltaNet的东风,研究者直接把一套确定性的RISC-V或6502微架构编译成几层的稀疏权重,像插卡一样嵌进大模型的前端或中间层。
对模型架构与工具链研究者来说,这相当于给满脑子概率分布的大模型体内,焊入了一块零幻觉的确定性硅片。当模型遇到需要严格逻辑执行或精确算术的任务时,完全可以把计算路由给这几层只有几百万非零参数的编译权重,算完再把精确结果吐回主网络。至于Opus 5.5仅凭两句提示词就读懂底层编译器博客、自己找来15年前的测试集跑通闭环,则顺手给AI辅助编程工具做了一次相当硬核的实力背书。
- 结论.权重编译技术的真正落点不是拿大模型当游戏机,而是以几兆字节的稀疏层为代价,在混合架构大模型内部植入免训练、零误差的内置计算器与代码执行器。
回看屏幕上一帧一帧慢动作跳跃的马里奥,它跑得确实像蜗牛,但那4,586步测试里一步不差的确定性,恰恰是今天所有大模型最稀缺的东西。