计算机科学家 Murat Demirbas 在其 Metadata 博客撰文指出,大语言模型(LLM)正在击穿亚马逊引以为傲的六页纸备忘录制度。当任何人都能用模型在零思考状态下瞬间生成结构严密的六页长文时,成文就不再是深度思考的可靠凭证。但结合 2025 至 2026 年多项认知科学对照实验来看,把大模型一律视为思考毒药同样偏颇——决定人类大脑是退化还是进化的分水岭,不在于是否调用模型,而在于谁先动笔。
Demirbas 援引了图灵奖得主 Manuel Blum 在 2001 年给研究生的一段经典训诫:有限自动机只能做加法,图灵机却能计算任何可计算函数,两者唯一的物理区别在于图灵机拥有纸和笔。撤掉纸笔,人脑的计算能力就会直接降级一个复杂度级别。Demirbas 将人类写作比作计算机的核外执行(Out-of-core execution)。他审阅学术论文时,光靠读往往自以为懂了,坐下来写审稿意见才发现只理解了 60%;2018 年他随手写博客梳理思路,竟意外推演出 Paxos 协议与中本聪共识(Nakamoto consensus)的解剖学相似性,最终孵化出一篇正式论文。
存盘不等于学会:外部记忆的心理学假象
Demirbas 在文中把早年画托尼·博赞(Tony Buzan)思维导图和持续写博客称作自己的外部记忆。但单看他的个人经验,读者很容易踩进一个认知误区,误以为只要把字敲进文档或画成蜘蛛网导图,知识就自动长进了脑子里。
认知心理学的实证数据拆穿了这种错觉。Burnett 和 Richmond 在 2026 年 1 月正式出版的元分析证实,将信息保存到外部介质(认知卸载)确实能改善当下的任务表现,但并不能提升后续撤除辅助时的自身记忆保持;Storm 和 Stone 2015 年的三项实验也表明,存盘早期文件只是减少了旧信息对学习新文件的干扰,被存盘的内容本身并没有被记住。
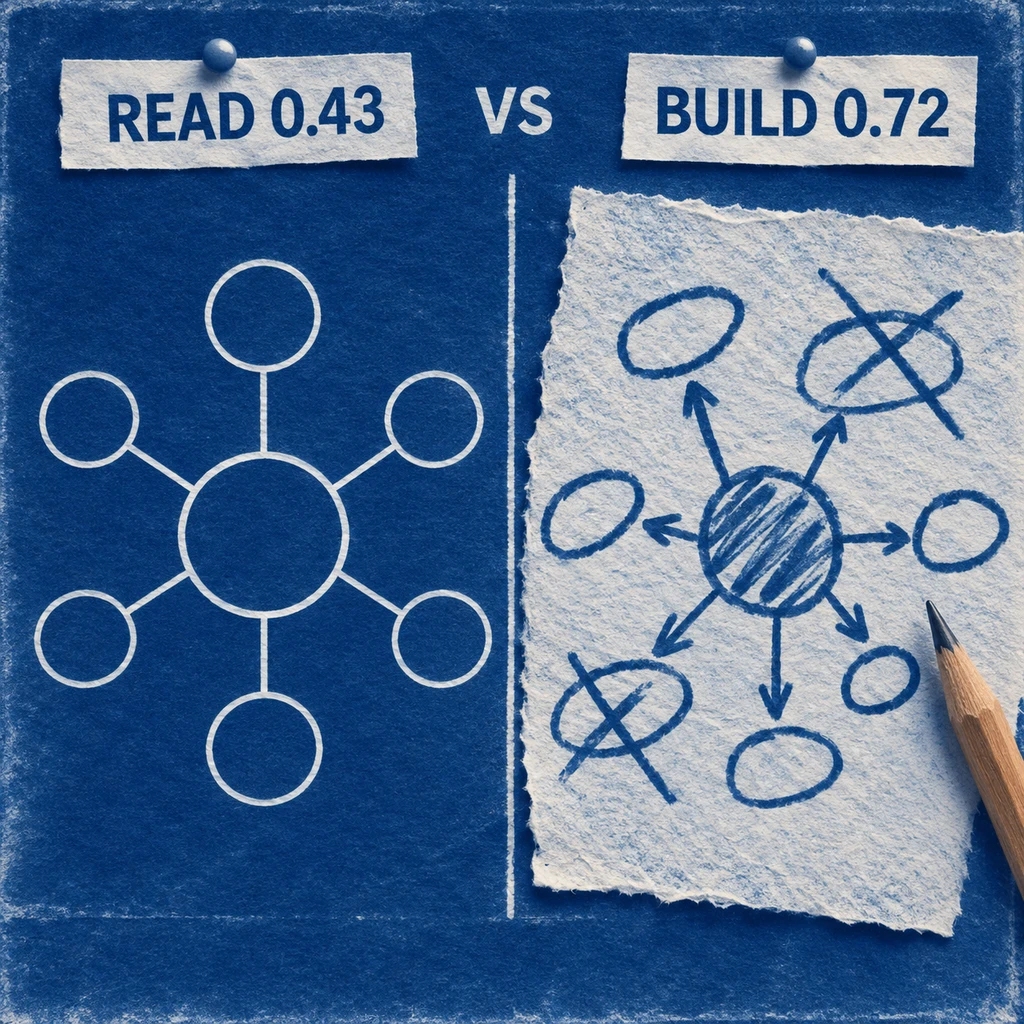
真正让大脑产生神经元重连的不是外在笔记格式,而是脱离原文时的主动提取与重构。Schroeder 等人基于 142 个独立效应量、11,814 名参与者的元分析显示,亲手构建概念图的学习效应量高达 0.72,而单纯阅读现成概念图只有 0.43;Blunt 和 Karpicke 2014 年的实验更直接证明,阅读后无论是写段落还是画概念图,一周后的测试表现都优于额外阅读,且两种格式之间毫无差异。Demirbas 重读旧博客能迅速唤醒理解,靠的不是博客充当了硬盘,而是他当年写初稿时经历了高强度的心理提取。
659 人随机实验:AI 究竟是拐杖还是教练
既然思考发生在费力的提取与重构过程中,一旦把动笔的环节交给大模型,认知危机就会立刻显现。贝索斯曾断言,没人能在不具备清晰思考的情况下写出一份六页纸的叙事性备忘录。如今,大模型靠预测下一个词元(next-token probability)就能轻松伪造出这种思考发生过的表面证据。
当文字不再是思考的工作量证明,谁先动笔就决定了谁是机器的肉身代理。
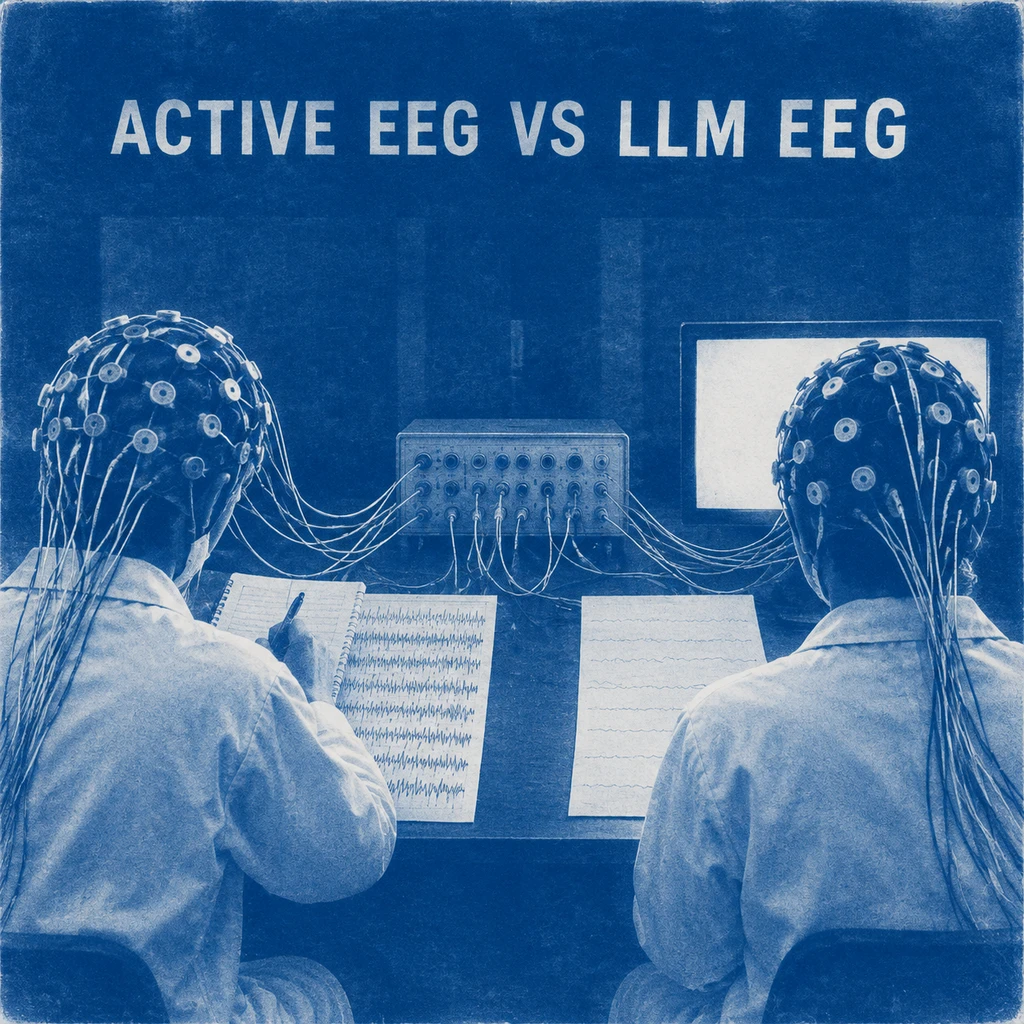
Kosmyna 等人 2025 年针对 54 名参与者的脑电图(EEG)预印本研究印证了 Demirbas 的担忧:与使用搜索引擎或纯手写相比,使用 LLM 写作的人脑电连接性明显减弱,对文章缺乏归属感,甚至难以引用自己刚交上去的文章内容。但 2026 年密集发表的四项受控随机实验证明,大脑是否萎缩完全取决于工作流的设计。
| 实验来源与样本规模 | 核心工作流分组对比 | 撤除 AI 后的无辅助测试结果 |
|---|---|---|
| Liu 等人 (2026),659 人有效样本 | 直接采纳 AI 代写 vs 先自写再用 AI | 直接采纳组推理表现显著低于无 AI 组(7 分制低 0.38 分,d = -0.28);先自写组无衰退 |
| Contractor & Reyes (2026),大学生样本 | 让 AI 直接代写 vs 将 AI 作为导师质询 | 导师组在即时与一周后测试均保持学习收益;代写组收益消退 |
| Fan & Chang (2026),744 名学生四臂实验 | 学生评判 AI 文本 vs AI 评判学生文本 | 第 6 周后测中,人审 AI 组表现显著优于 AI 审人组及无 AI 对照组(d ≈ 0.35–0.36) |
| Lira 等人 (2026 修订版),预注册实验 | AI 辅助练习/观看 AI 改写示例 vs 无 AI | 练习时费力更少,但在随后的无 AI 专业写作测试中表现反而更好 |
这组实验数据给出了极其清晰的操作边界。在 Liu 等人发表于《Frontiers in Psychology》的实验中(900 人随机分组,659 人纳入主分析),仅仅在移除 AI 15 到 20 分钟后,一上来就用 AI 直接生成文本的参与者,其无辅助推理表现就出现了即时赤字;而坚持先自己生成初稿再调用 AI 的一组,推理能力毫发无损。
管理者的验真难题与个人的防退化红线
大模型读遍了全网文献和标准共识,唯独没读过你脑子里那个尚未成型的半成品直觉。如果一上来就打开聊天框,人就会直接放弃那点脆弱的原创直觉,退化为帮生成式文本跑腿的肉身代理(meat-proxy)。
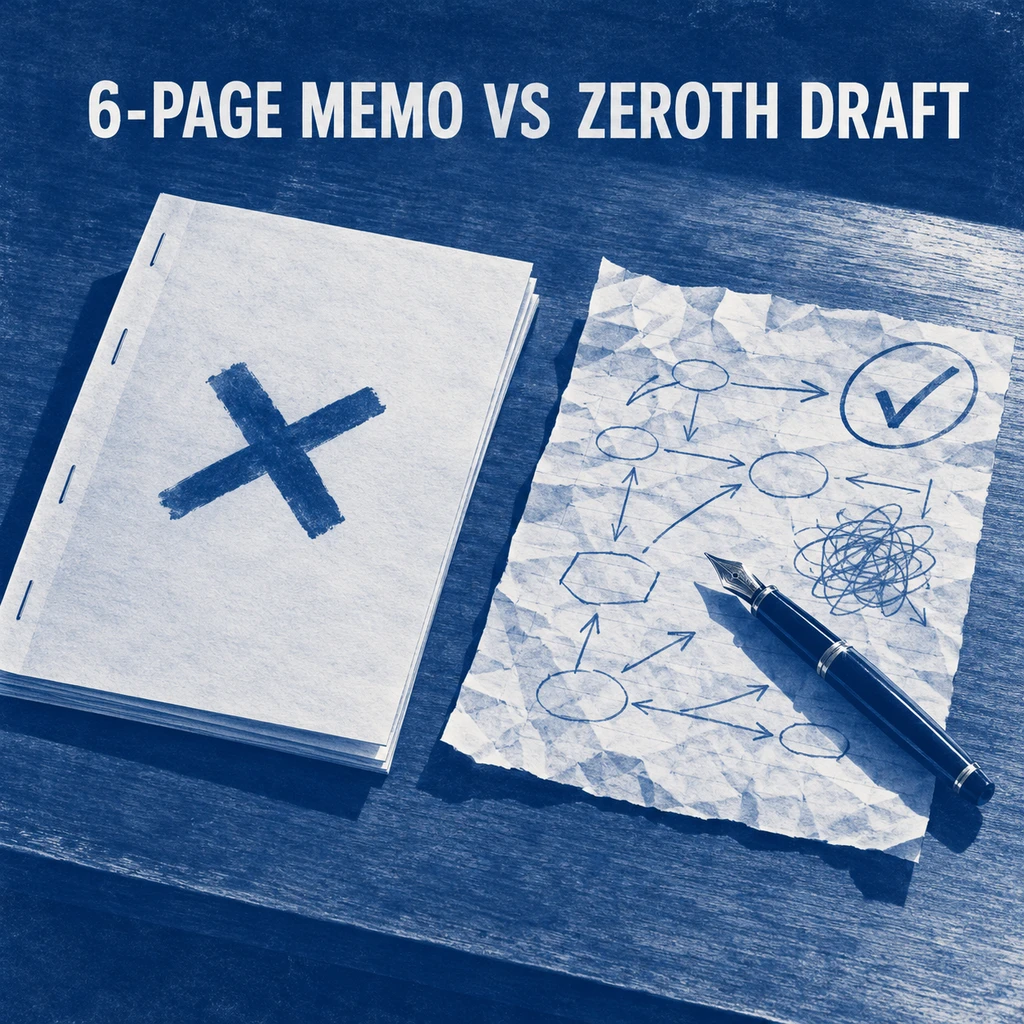
这场变化正在倒逼两类人群立刻调整动作。对推行六页纸或深度周报的科技企业管理者而言,长文汇报的字数与结构已经彻底失去筛选价值;考核必须从看成文转向查验思考过程,比如要求提交未美化的零号草稿(zeroth draft)笔记,或在会议现场进行脱稿追问。
对科研人员、工程师和学生来说,Demirbas 给出的第一条写作法则恰恰暗合了最新认知实验的结论:在打开任何大模型之前,先在一个空白本地文件里不计语法、不查拼写地乱写一气(Rule 1: Mess up),哪怕只是零碎的逻辑跳线。
- 风险.即便把工作流设计为让人去严审 AI 文本,惰性依然会钻空子——Fan 和 Chang 2026 年的实验过程日志就抓到了一个关键漏洞,不少被要求评判 AI 文章的学生,转头又把这项评估任务偷偷委托回给了 AI。工具交互如果不设置强制的先自写门槛,任何精妙的防退化流程最终都会在人的省力本能面前失守。