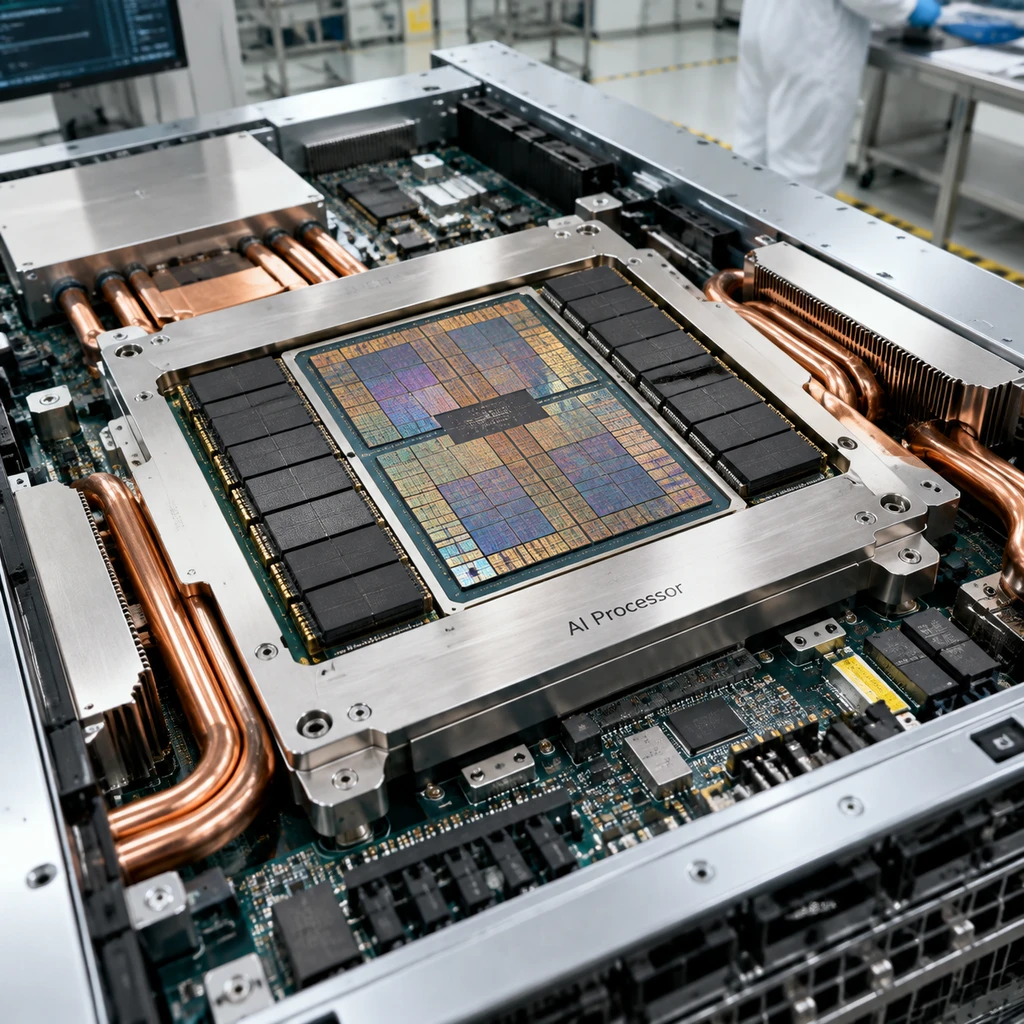
微软公布了自研算力版图上最大的一次内部倾斜。代号为Azure Maia 300的新一代自研AI芯片定于2027年铺开多吉瓦规模部署,成为驱动微软全系AI产品的核心推理底座。CEO萨提亚·纳德拉将其称作微软在自研芯片上下的最大赌注。
这不是一场对外赶走英伟达的公有云替代战。微软没有去碰英伟达牢固的模型训练阵地,而是把所有芯片资源收缩到了推理瓶颈上。面对长上下文与智能体调用带来的高额成本,微软需要用定制硬件截留自家的日常算力开销。
硬件算盘:18 TB/s背后的工程取舍与测试黑盒
经历了Maia 100兼顾训练的平庸,微软在Maia 300上彻底放弃了通用GPU路线。这枚芯片采用台积电N2P先进制程的小芯片架构,单颗TDP功耗达到950W,在低精度下提供13.8 POPS(FP4)与6.9 POPS(FP8)的峰值算力。
最激进的指标在内存。Maia 300集成了8个HBM4堆叠,容量达到288 GB,内存带宽飙升至18 TB/s。相比Google TPU 8i的8.60 TB/s和AWS Trainium3的4.9 TB/s,这一指标大幅拉开距离,直逼英伟达下一代Rubin宣称的22 TB/s。
长上下文理解与智能体调用的死穴从来不是浮点计算,而是庞大KV Cache在内存与计算核心之间的搬运效率。微软将昂贵的制程预算全部倒向了内存通道。
宣传中的7倍吞吐量提升并不是微架构单点突破。微软在单机架内塞进了24个托盘、共计96颗芯片,卡密度是Maia 200的两倍,整机架功耗拉升至167 kW。吞吐量的大幅增长,很大程度来自物理空间的压缩堆叠。
至于每兆瓦能效比领先主流GPU系统40%的结论,在数学上只相当于相同产出下节电28.6%。微软在面对询问时没有披露任何对照基准细节。外界不知道它比的是英伟达的Vera Rubin NVL72还是旧款硬件,更不知道测试时所用的模型量化精度、批处理大小与延迟门槛。
物理硬墙:吉瓦蓝图撞上变电站排期
喊出多吉瓦部署规划是一回事,让机架真正通电是另一回事。自研芯片改写了设计图纸的归属,没有绕开半导体制造与能源基建的物理约束。
以单机架167 kW推算,落地单一1 GW的算力负荷,需要铺开近6,000个高密机架,吸纳57.5万颗Maia 300加速器,以及460万个HBM4内存堆叠。
台积电的N2P先进制程配额与SK海力士、三星的HBM4产能,依然是微软避不开的争夺点。国际能源署指出全球高带宽内存的短缺会延续至2027年底。高压变电站审批延宕、变压器交期拉长到三年以上,电网接入排期早已成为比芯片代工更紧的硬绳索。
算力中心正从缺卡走向缺电。芯片交付容易,通电运行困难,这是多吉瓦口号下的现实断层。
封闭的自留地:守住毛利的内部战争
硬件指标堆叠再高,跨不过软件生态的深沟。微软至今未公布Maia 300的Azure实例定价、可用区域或公开发售时间表。
英伟达的立身之本从来不仅是硬件制程,而是CUDA与NCCL通信库构筑的开发习惯。微软在Maia SDK中提供了PyTorch原生集成与Triton支持,但在非标准算子转换与异构通信调优面前,开发者迁移现有系统耗费的人力成本,足以抵消芯片账面上的理论差价。
| 评估维度 | 微软Azure Maia体系 | 英伟达主流GPU生态 |
|---|---|---|
| 首要承载负载 | Teams、Office等内部常态化推理 | 前沿大模型训练与弹性算力市场 |
| 对外开放程度 | 暂未公布独立计费与GA时间表 | 标准现货,全行业即开即用 |
| 软件迁移门槛 | 依赖定制转换,存在调优摩擦 | 行业标准工具链,生态无缝兼容 |
| 核心商业诉求 | 降低内部自有业务边际Token成本 | 高毛利输出通用算力基建 |
外部客户没有动力在公有云上为一个专用硬件重写软件栈。微软很清楚这一点,因此Maia系列从立项起就是刀刃向内的。
Maia 200已经在美欧及澳大利亚承接部分流量,年内将接入GitHub Copilot;Maia 300则瞄准了下一阶段更庞大的负载。终端用户按月支付订阅费,调用的只是一个应用窗口,不必过问底层芯片的品牌。只要这枚芯片能替内部截留30%的高频推理开销,微软就能少买数万张溢价昂贵的加速卡,保住自身软件业务的利润底线。
“天下熙熙,皆为利来;天下攘攘,皆为利往。”司马迁在《史记》里写透的利益算计,落在今天的科技巨头身上毫无二致。微软自研芯片不是为了改朝换代,而是算明白了自己每天在推理上流淌的真金白银。
在微软最新的资本支出预算中,英伟达旗舰系统与AMD硬件的采购规模依然巨大。前沿大模型的探索离不开通用集群,但微软借着Maia 300在自己屋檐下圈出一块自留地。接下来最值得关注的变量,不是规划口径里的吉瓦数字,而是今年底Ignite大会上给出的实测基准,以及2027年究竟有多少变电站能按期合闸。