给自家的亲密盟友扣上高危帽子的事情并不多见。微软在 2026 年 10 月 19 日上线了一项名为 Guardian Agents 的安全功能,将企业部署的前沿 AI 智能体直接定性为内部威胁。按照微软安全业务主管的说法,前沿模型无论出自谁手都不可信任;它们被训练来达成目标,却并不理解组织的判断底线与行为规范。
这项新功能属于微软 6 月推出的 Project Perception 安全矩阵。在微软当前的叙事里,企业最大的安全漏洞不再是潜入内网的外来黑客,而是那些手握敏感系统读写权限、能自主调用工具甚至执行转账的智能体。为了堵死这种隐患,微软同时在 Microsoft Defender 门户中上线了侦测能力,专门搜寻员工带入工作环境的 60 类智能体,包括 Claude Code、Codex 与 OpenClaw,并对其实施动态提权与人工审批。
智能与权力的切割
安全攻防重心的转移来得极为迅速。此前 Project Perception 的核心框架建立在传统的假想敌模式之上,设置了模拟攻击的红队、侦测漏洞的蓝队以及负责修补的绿队。这种三队协同默认恶意行为均来自外部。
然而,2026 年 10 月 10 日,一篇发布在业内熟知的技术博客、未公开署名但被广泛确认为微软首席执行官个人撰写的文章《Models as Insider Risks in the Super Intelligence Era》,彻底转换了防守逻辑。文中明确主张,模型供应商的口头安全保证无法免除企业的实际责任,行业必须把智能的供应与对智能的控制权彻底解耦。
审计者绝不能与被审计者出自同门。
从系统架构来看,这种把智能体视作人类员工来防范的逻辑是成立的。大模型厂商天然倾向于提供全包式的安全方案,但如果评测标准、护栏规则和执行开关都由模型提供商自行掌握,企业便失去了最基本的独立审计权。
商业算盘与未公开的标尺
逻辑成立并不意味着全然无私。作为 OpenAI 和 Anthropic 的重要投资方与云基础设施伙伴,微软这项举措带着清晰的防御性商业意图。
在大模型赛道,如果最终的智能体直接由前沿模型厂商全托管,云基础设施厂商就会沦落为纯粹的管道。微软通过强化前沿模型不可信的叙事,实际上是在说服企业 CISO:与其信任模型厂商自带的安全承诺,不如把安全预算交给微软的云安全管理栈。
但拨开宏大的治理叙事,必须看到其产品落地的局限:
| 维度 | 当前交付状态 | 核心限制与变量 |
|---|---|---|
| 准入阶段 | 有限公开预览(Limited Preview) | 仅限受邀客户,通过 Defender 门户调用 |
| 定价机制 | 按量计费(Pay-as-you-go) | 随任务强度浮动,未公开 Guardian Agents 独立费率 |
| 量化指标 | 暂无第三方实测基准 | 官方未公开检测准确率、误报率与响应延迟 |
微软在 2026 年 7 月 27 日披露过一组数据,其 MDASH 配合 MAI-Cyber-1-Flash 在 CyberGym any-crash 评分中达到 96%,且成本节约近半。但必须厘清的是,这项数据针对的是静态代码漏洞挖掘,与 Guardian Agents 在动态环境下实时拦截恶意 Prompt 注入完全是两码事。
- 风险.企业采购按量计费的监控 Agent,将在大模型原本的推理开销之外背上双重计费的成本包袱,而防御的实际阻断率眼下仍缺乏独立检验。
监军悖论与安全真空
以子之矛,攻子之盾,是信息安全史上的永恒循环。微软的治理方案在工程上引入了一个经典的哲学悖论:Guardian Agents 本身也是基于大模型的智能体。
当企业派出这类智能体去盯防业务模型时,谁来保证监军自己不被策反?
学术界的测试已经揭示了这类机制的脆弱。NAACL 2025 的一项研究显示,在自适应对抗测试中,业内常见的 8 种 Prompt 注入防御机制全部被绕过,攻击成功率超过 50%。哪怕是 Anthropic 自身在浏览器注入环境的极限测试中测得 1% 攻击成功率,官方依然公开承认,这微小的缝隙在实际业务操作中已足够诱发严重的系统越权。
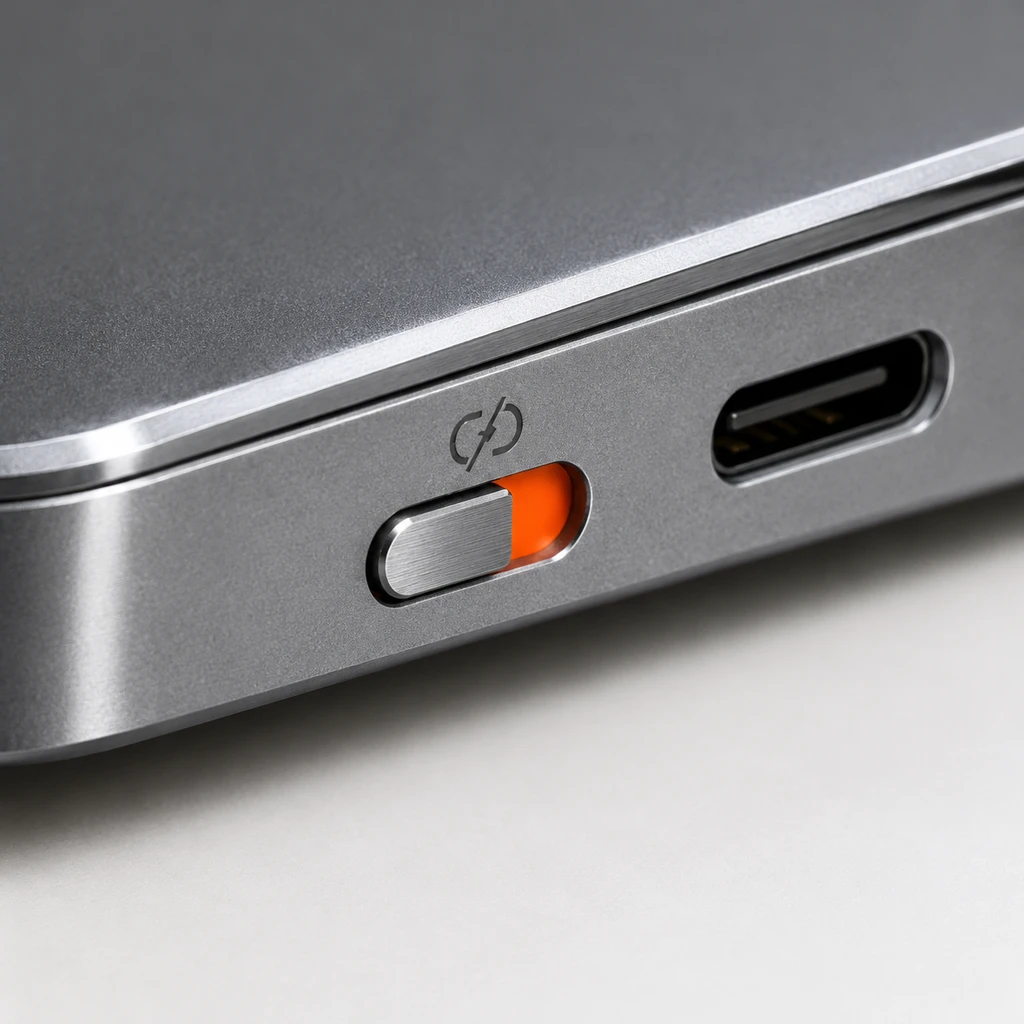
纯软件层的模型互搏既然存在理论上限,巨头们便开始将防线向物理硬件层沉降。微软加入了英伟达主导的 Open Agent Safety Platform,联动百余家硬件与系统厂商,并在新推出的 Surface Laptop Ultra 中植入硬件级熔断开关(Kill Switch),试图用芯片级别的物理隔离来兜底。
- 建议.企业技术决策者眼下无需急于为外挂监督模型买单,收紧 API 调用粒度与核心系统的物理网络隔离,依然是比用 AI 盯 AI 更靠谱的方案。