做长任务的 AI 智能体,正集体撞上一堵看不见的认知之墙。
在连续运行数小时甚至上百小时的科研探索任务里,给大模型堆再多算力,往往也只能看到成绩在某个低水平线上打转。微软研究院 Ziyang Cai 团队在 2026 年 10 月 5 日提交的论文《Fork-and-Flush: Escaping Idea Basins in Autoresearch Agents》(arXiv:2610.07447)里记录了一个残酷现实:同一套基于 GitHub Copilot CLI 的科研智能体在同一道复杂命题上独立运行八次,即便算力给满,最终得分也会在 68.3 到 100.0 之间剧烈分化。
这不是模型变笨了,而是长对话产生的上下文把智能体死死锁在了狭窄的思维盆地(Idea Basins)里。微软开出的解药极其反常识:留存代码与生成文件,然后彻底杀光对话历史。
记忆不是资产,是越滚越重的偏见锁
长程科研的核心是假设、实验、复盘的自循环。大语言模型本质上是自回归概率生成器,一旦前十几轮对话推导出了一条偏窄的技术路线,这段包含错误直觉的文字就会变成后续所有推理的强约束前缀。
研究人员把各次运行生成的解空间投射在二维地图上后发现,单次长程运行无论被塞入多少上下文窗口,其所有的搜索点都会牢牢聚集在地图的一个极小区域内。就算系统定期执行上下文压缩,压缩后的摘要依旧带着最初的思维惯性。
微软设计的 Fork-and-Flush 拆解了过去混为一谈的两种状态:
- 环境状态(Workspace)代码仓库、编译产物、评测脚本和中间数据,这些属于物理资产,全部保留并克隆给子分支。
- 认知状态(Chat Context)模型说过的废话、推理的心路历程、推导的中间假设,在分支启动的一瞬间彻底清空。
新分支接管的是一个已经有现成代码的工作区,但对话窗口干净如初。大模型不再被过去的聊天记录牵着鼻子走,重新审视磁盘上的代码时,会像一个刚刚进组接手老项目的外部专家,更容易拿出全然不同的排障方案。
等额预算下的算力再分配
业界过去解决局部收敛的笨办法是 Best-of-N 盲抽:开四条互不相干的独立分支各跑四分之一预算,最后取最好成绩。但这种做法每次都从零写代码,前人踩坑的经验完全浪费。
Fork-and-Flush 的算力账本算得很细。论文里严格统筹了废弃分支的开销:总预算为 B 时,单次运行跑满 B;Best-of-4 各分走 0.25B;而 Fork-and-Flush 仅在消耗 33% 与 66% 预算节点处触发分叉,每个派生出的探索分支只分配约 0.06B 的极小预算。
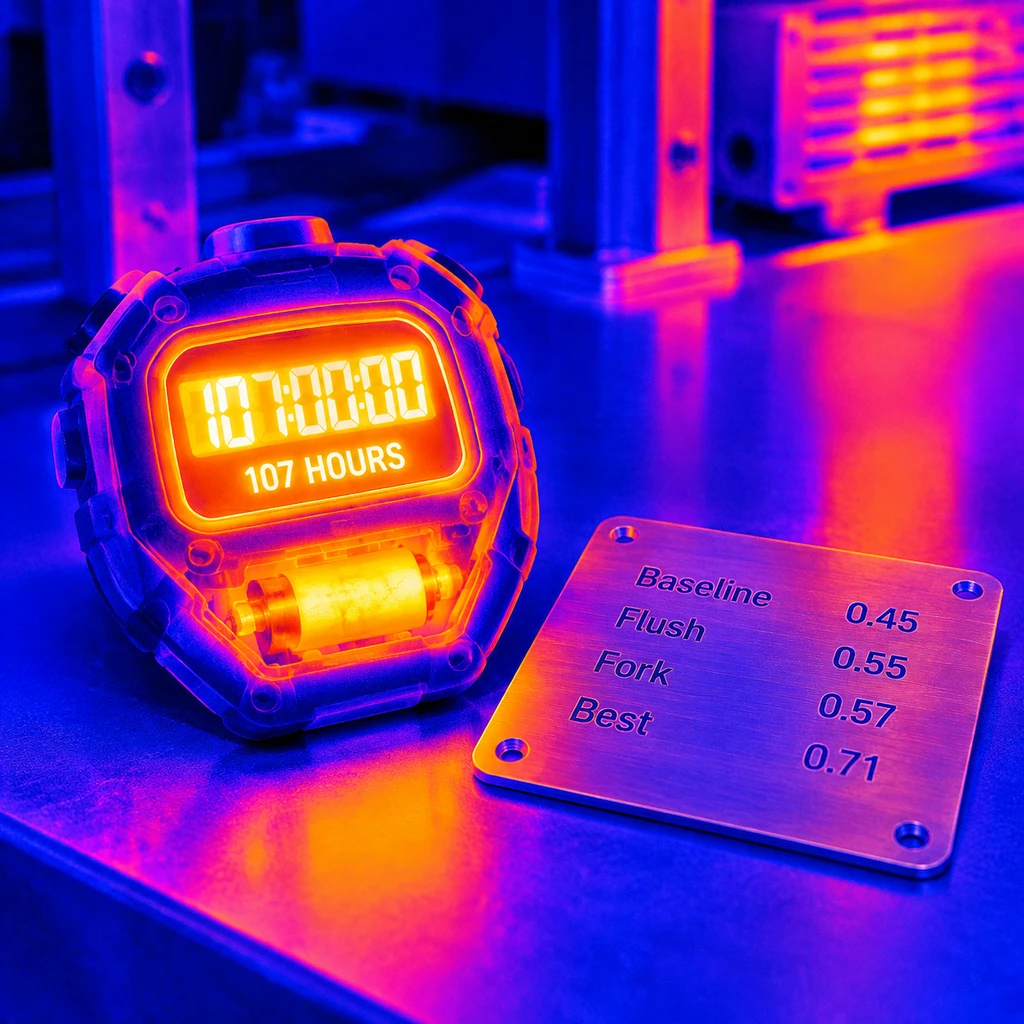
各测试任务的算力预算介于 6,000 到 100,000 Copilot CLI credits,换算下来大约是 100 credits 等于 1 美元,单个任务最长连续运行达 107小时。底模采用了 GPT-5.5 与 GPT-5.6-terra,并在 Qwen3.5-4B、9B、27B 上验证了普适性。
在覆盖 CIFAR 分类器压缩、VLIW 内核优化、密码破译等 13 项基准测试中,Fork-and-Flush 拿下 12 项任务的最高均分,归一化平均分从单次运行的 0.47 冲到 0.78,相对提升达到 66.0%。更关键的是稳定性,归一化标准差从基线的 0.26 压降到了 0.16。
在 11 项任务的专门消融实验里,数据同样说明了问题:
- 单次长程基线.0.45
- 仅清空上下文(Flush-only).0.55
- 仅并行分叉保留上下文(Fork-only):0.57
- 组合策略(Fork-and-Flush):0.71
光清空对话不做分叉,性能就能凭空涨 22%;但只有当清空上下文与并行分叉结合,大模型才真正具备了跳出死胡同的能力。
- 结论.对于长程复杂探索,对话记忆往往是负资产,唯有代码仓库才应跨周期持久化。
狂欢背后的统计盲区与真实成本
这项研究的价值极高,但行业没有必要立刻将其包装成解决一切长程规划的神话。有两处隐蔽的现实约束必须摊开来看。
首先是所谓 +66.0% 的定义。这是在各任务 Min-Max 归一化得分上计算的相对增幅,计算公式是 (0.78 - 0.47) / 0.47。它代表探索离任务最优解更近了一大步,但绝不等于模型在原始物理指标或最终准确率上暴涨了 66 个百分点。
其次是更核心的算力记账漏洞。论文中的等额预算,严格限定在 LLM 的 Token 与 Copilot 点数消耗上。但在真实的 107 小时运行里,代码每次分支后的重复编译、求解器的矩阵运算、以及 Grader 自动化打分机制所霸占的物理 CPU/GPU 墙上时钟时间,全都没有计入等额预算内。换句话说,你在 API 账单上做到了等额,但底层的机房电费和等待时间很可能已经悄悄超支。
- 提醒.API Token 的平摊并不等于本地环境计算资源的等额,工程落地必须重新核算编译与评测的时间成本。
决定智能体上限的不是记住了多少推理细节,而是能否在关键时刻斩断偏执。
大模型厂商过去两年都在不遗余力地兜售百万甚至千万级超长上下文,仿佛把整座图书馆塞进对话框,通用人工智能就会自然浮现。但在自动化工程探索这种强依赖试错的深水区里,长上下文反而成了画地为牢的镣铐。
聪明的系统正在学会给大模型做脑叶切除手术。保留手头的文件,忘掉嘴里的争辩,让代码留在磁盘,让上下文随风而去。