2026年10月9日,微软AI在 Microsoft Foundry 平台低调上线了名为 Microsoft-Decision-1 的新模型。这并不是又一个用于聊天或写长文的生成式大模型,而是一个专门在多选分支中做单遍概率测算、负责路径路由与安全判定的决策打分模型。
最耐人寻味的变化藏在技术选型与分发方式之中:微软没有采用老搭档 OpenAI 的现成架构,也没有沿用自家 Phi 系列小模型,而是挑选了中国阿里巴巴开源的 Qwen3.5-9B 作为基础权重;完成单遍后训练后,微软没有按照开源社区惯例回馈权重,而是直接将其锁进了自家的云服务计费清单。更让开发者侧目的是,微软宣称其拥有碾压竞品的超低延迟,但随之而来的跑分双标质疑与官方悄然勘误,暴露出科技巨头在智能体基础设施争夺中的焦虑。
借开源底座打造打分尺,却未向社区回馈一行权重
官方技术文档显示,该模型版本号定为 1,底层基础模型明确标注为阿里的 Qwen3.5-9B。微软团队在此基础上,结合公开数据集清洗流程(Open Data)以及自研合成数据,针对预定义选项的快速打分场景完成了后训练。
从工程定位来看,它的目标极为收敛:只接纳带有预定义选项的封闭问题,不输出任何冗长的自然语言解释,仅输出校准后的离散选择概率,用于在复杂系统中充当裁判或路由器。
外媒最初的快讯标题一度让社区以为微软又向开源世界贡献了一款前沿工具。但事实很快展现出反差:在 Hugging Face 与微软的 GitHub 官方组织内,没有任何权重文件、微调配方或开源协议放出。Microsoft-Decision-1 仅作为托管 API 存续于商业化的 Microsoft Foundry 平台。
直接使用别家开源的高性价比权重,经过私有训练后包装成专有云端收费接口,这种做法印证了阿里基础模型在海外大厂内部的技术分量,却也打破了开源社区默认的互惠预期。
85 毫秒实测撞上 29 毫秒真相,宣传战里的算式游戏
为了支撑其云端收费的合理性,微软在宣发材料中拿出了相当强势的数据:在覆盖路由、排序、推理与安全的 36 项基准测试(涵盖近 150,000 个问题)中全部拿下第一,甚至宣称在面对输入扰动时,模型的平均决策变化率低至 1.3%。
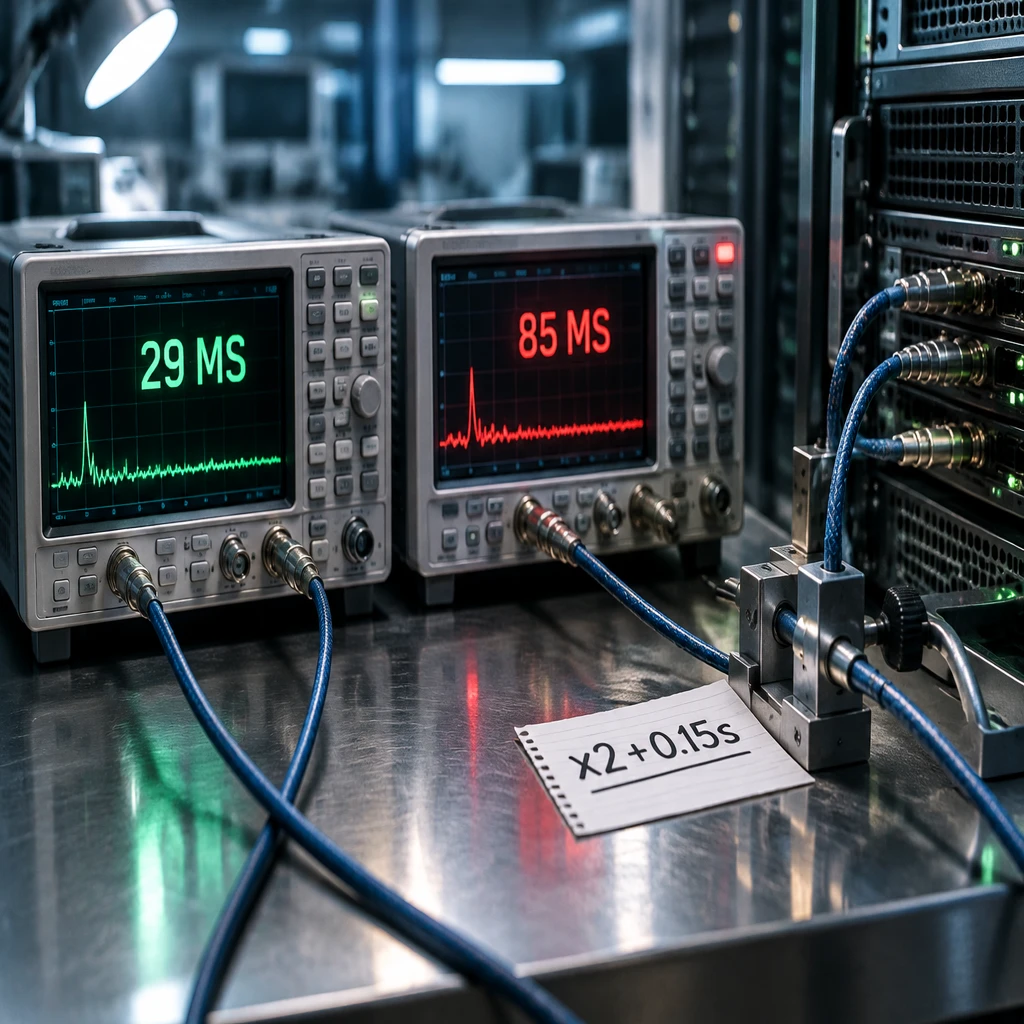
在速度指标上,微软更是给出了戏剧性的横向对比:模型在 Foundry 上的端到端延迟约为 85 毫秒,相比未具体说明尺寸的 GPT-6 Sol 快了约 35 倍;在专用小模型阵营中,比竞品 H2O-Lightning-4B v1.1 快了整整 2.5 倍。
任何不基于同等硬件环境测算的 API 延迟对比,大多只服务于商业宣发。
很快,眼尖的开发者发现了微软宣发口径的晃动。上线最初几个小时,官方博客赫然写着比 Quyet-1.0-Large 快 4.5 倍并将其称作测试亚军,随后在没有任何公开说明的情况下,悄悄撤下该表述,更换为比 H2O 快 2.5 倍。
更为激烈的反弹来自竞品 H2O 团队。H2O 指出,微软声称的 2.5 倍速度差距完全是计算口径差异制造的假象。在微软给出的测试逻辑中,他们直接记录了自研云 API 的 85 毫秒响应,却对竞品套用了 JevBench 的惩罚折算公式(测定时间乘以 2 另加 0.15 秒),由此将 H2O 的延迟生生算到了约 210 毫秒。而实际上,H2O-Lightning 在标准化本地硬件环境中的中位延迟只有 29 毫秒。
加上微软 36 项评测集包含未公开的私有测试样本,缺乏完整的提示词与运行复现包,这场原本漂亮的性能秀,在社区眼里打上了大大的问号。
智能体从生成退向打分,企业落地的防波堤
抛开跑分争议,微软此时全力推出非生成式打分模型,折射出整个 AI 产业演进方向的现实重构。
在过去两年中,企业构建智能体工作流时普遍迷恋端到端大模型。然而,让千亿参数模型去执行“判断下一跳走哪条支线”或“检测输入是否违规”等机械动作,不仅带来了动辄两三秒的延迟,更让云端账单失控。行业由此分化出专门做裁判与路由的轻量级小模型生态。
微软将 Qwen3.5-9B 压缩在固定选项的概率计算上,正是为了解决流水线中的拥堵。它不需要模型展现任何文学才华,只要求在几毫秒内给出一个精准的分流浮点数。然而,黑盒决策同样伴随着结构性风险。微软在发布协议中明确附带了免责限制:该模型严禁作为对人身或重大利益产生关键影响的单一决策依据。
- 风险.9B 级别的小模型在单遍概率输出时省去了思维链推演,虽压缩了延迟,但也彻底放弃了可解释性,一旦面对长尾边界条件产生盲目置信,企业排查系统故障的代价将远高于普通接口。
目前摆在技术选型者面前的选择极为现实。如果企业正在构建高度依赖 Azure 的多智能体流水线,Microsoft-Decision-1 确实提供了一个现成的中继节点,无需自建推理集群即可调用;但如果追求绝对成本与延迟控制,或者忌惮专有云锁定,基于开源社区权重在本地硬件自建判定服务,依然是绕开巨头过路费的更稳妥路径。真正的检验,还要看未来几周独立第三方能否在脱离微软云端惩罚算法的环境下,复现这 36 项全能的第一名。