AI模型在各大跑分榜单上的分数早已逼近人类极限,但企业内部采购系统的落地体验却常常陷入尴尬。AI人才评估平台Mercor最近做了一项测算,把29个具有代表性的智能体基准映射到美国劳工部的职业分类体系中,结果勾勒出一幅认知割裂的图景:在全美923个职业与18,797项细分任务中,只有208个职业和924项任务拥有至少5个评测题目,而全美90%的劳动工时所对应的实际工作,目前几乎彻底游离在现有AI基准的评测视野之外。
这意味着过去两年的跑分繁荣与人类真实的劳动市场并不在一个坐标系上。
评测指标向高薪行业严重倾斜
现有的评测体系呈现出极度挑肥拣瘦的倾向。基准研发需要高昂成本,这让评估机构把有限的精力聚焦在工资总额最高的岗位上。通过分析美国劳工统计局的平均薪资与从业规模会发现,AI基准集中攻坚高薪律师、量化分析师和资深程序员的工作节点,而对处于同一工作流中的长尾工种视而不见。
同样属于AI暴露程度较高的岗位,律所合伙人级别的法律文书拟定被层层评测,但法庭书记员与法律秘书日常承担的大量流程调度,在榜单上几乎毫无痕迹。学者Wang等人在对43个基准、72,342项任务的映射研究中也得出了类似结论,目前的Agent基准超过半数挤压在编程与狭窄的纯计算任务里,与错综复杂的真实经济活动形成了结构性错配。
这种偏倚给企业技术选型带来了巨大的信息失真。
- 结论.模型在高薪知识任务上的跑分,无法代表跨部门协作与基层执行的综合产能。
90%盲区背后的推演逻辑与规则暗门
面对90%这个数字,必须厘清评测盲区与实际能力瓶颈的边界。评测覆盖盲区绝不等于模型干不了这些工作。很多看似未被覆盖的工作,现有的多模态模型完全能在人机协作模式下完成辅助。此外,Mercor的统计机制本身也包含了相当严苛的假设前提。
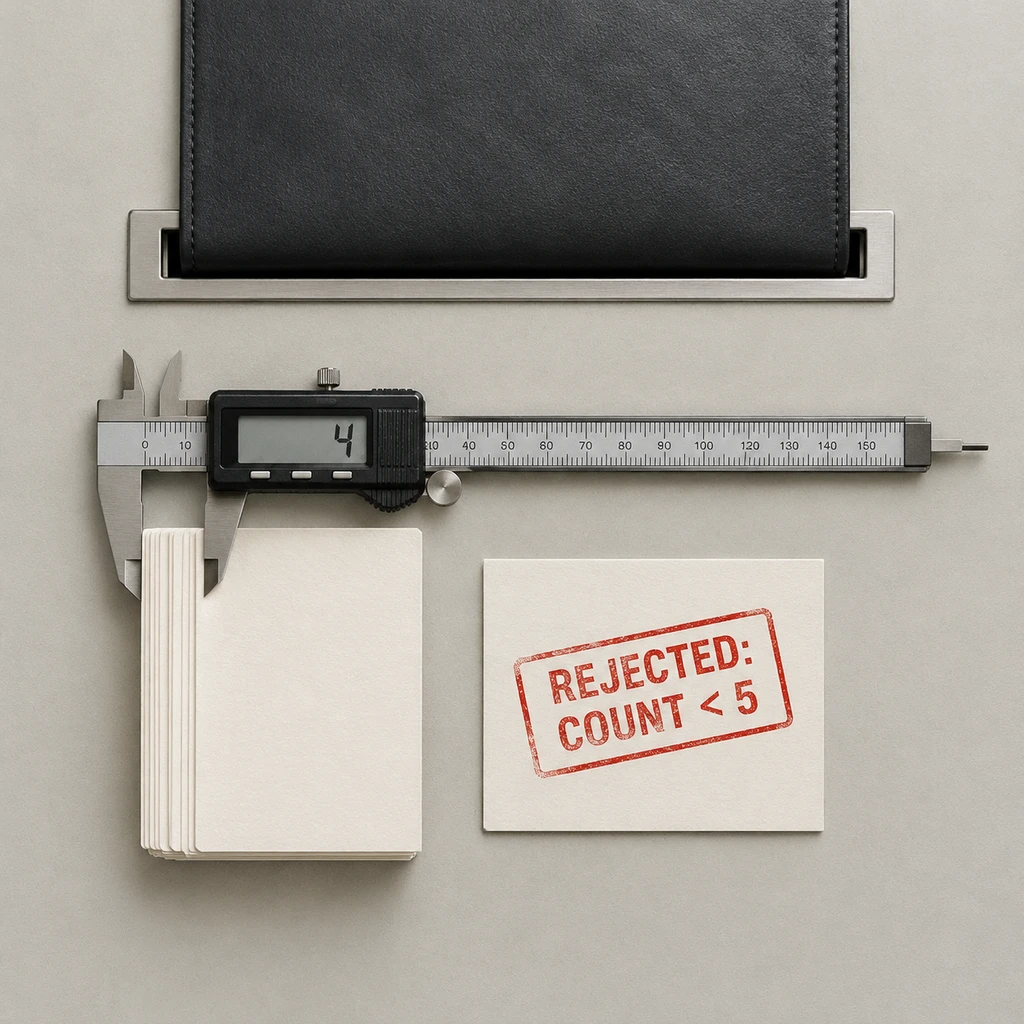
这套推演主要建立在层层筛选之上:
- 第一道门槛是至少5个提示词.若某项任务只关联了4个测试题,在该统计中就被直接划入完全未覆盖。
- 映射过程高度依赖大语言模型自动标注.单个提示词平均映射至3.1个职业任务,但人工校验仅局限在其自家的APEX子集,且首选映射接受率只有76.7%,软件工程模块APEX-SWE甚至缺乏专家审核。
- 工时权重的90%并非来自员工打卡数据,而是结合Hatgis-Kessell等人基于大语言模型估算的任务耗时推导出来的二次建模结果。
评测收录规则同样暗藏商业博弈。Mercor规定第三方基准必须公开至少25个任务,直接将Scale AI与CAIS联合推出的Remote Labor Index拒之门外,因为该项目240个真实接单任务中仅开源了10个。纳入统计的OpenAI GDPval也仅使用了公开的220个任务,未包含其完整的1,320个题库。但与此同时,Mercor对自身保留私有测试题目的APEX基准却敞开了大门。
跑分榜单在定义模型上限,而规则制定者在定义谁有资格出题。
- 风险.当评测机构兼具裁判与评估产品供应商双重身份时,指标设计往往会向自身优势倾斜。
生产力重塑需要走出纯文本闭环
从答题式的MMLU,到软件工程领域的SWE-bench,再到模拟远程劳工平台接单的真实任务,行业已经意识到纯文本刷榜与现实生产力的脱节。然而,即便把基准题目做成复杂的Agent工作流,它离现实世界的工业运转依然隔着厚厚的墙壁。
职业分类系统里的任务描述只是静态语句。起草一份借款协议在提示词里只需要输入背景参数,但在现实企业中,它牵扯到业务部门的需求反复变更、合规部门的博弈拉扯,以及对隐性商业风险的权衡取舍。这种在动态环境中容错、沟通与交付结果的能力,无法通过离线的Prompt进行完全量化。
技术的渗透往往是无声的浸润,而非照着题库精准替换。在各方争夺新一代AI评估话语权的同时,更需要认清的是:模型能力的高低,终究要回到真实组织的损益表里接受检验,而不是在几家机构圈定的基准地图上画地为牢。