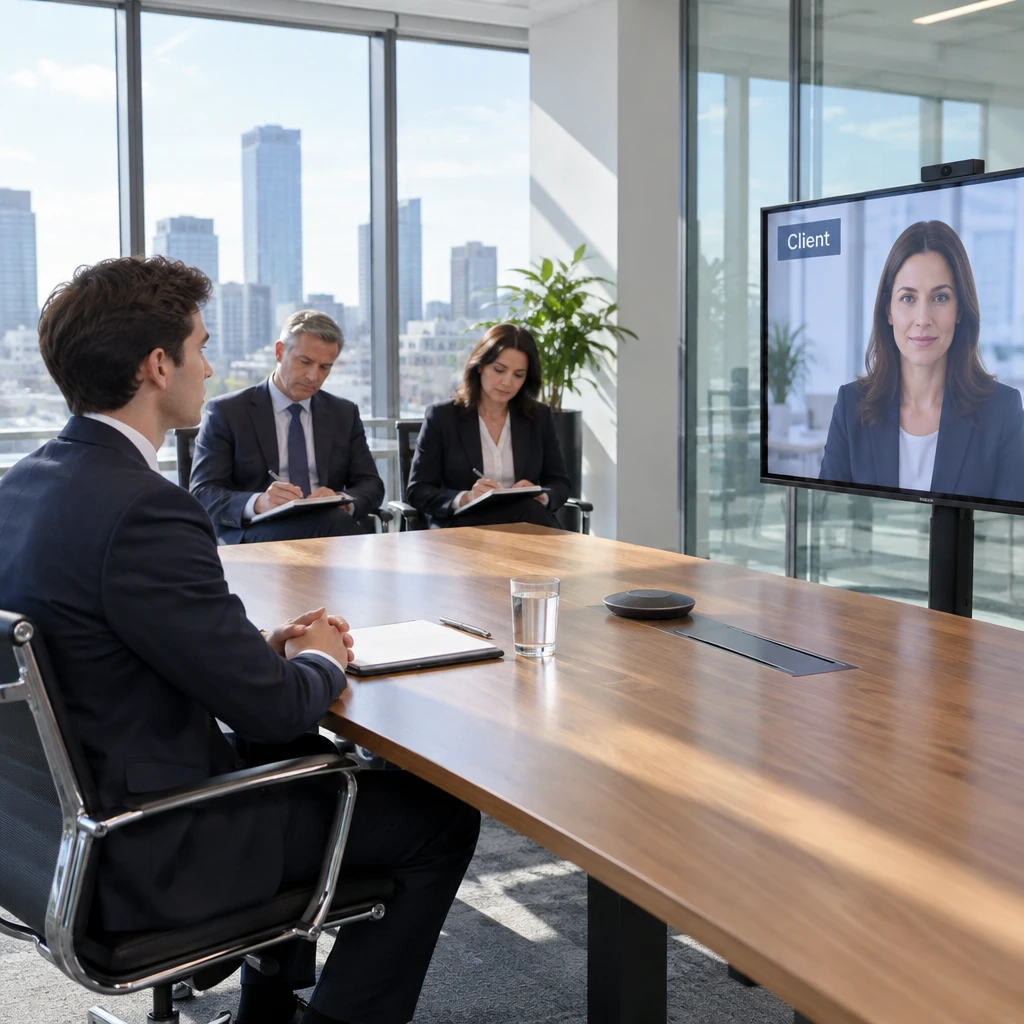
麦肯锡在2026年秋季的北美初级商业分析师校招中,给求职者摆了一道反常的考题:让候选人面对屏幕,与一个由AI驱动的虚拟客户对话10分钟。
许多人第一反应是算法考官要来淘汰大学生,事实刚好相反。这场由麦肯锡达拉斯办公室合伙人Saleem Zafar主导设计的测试里,AI拿到的剧本不是主考官,而是被派来找茬、提诉求的虚拟客户。真正的麦肯锡合伙人坐在房间另一侧,全程不发一言,只拿笔记录候选人如何应对眼前这个代码生成的刁钻角色。
考官退到暗处,AI成了受试的靶子
传统咨询面试讲究框架拆解。无论是经典的案例面试还是个人经历深挖,培训机构早已将答题逻辑拆解得极其精密。随着各类大语言模型普及,求职者用大模型生成话术、倒背解题套路的成本几乎降到了零。
麦肯锡推行这项测试,核心是反向利用AI。
这一工具旨在复刻咨询顾问在实际业务中可能遇到的约80%沟通场景。设计团队明确表示,这套算法不会故意模拟失控发疯的极端客户,但它能在极短时间内制造真实的利益冲突。
数百名求职者将在数百场无差别的对局里接受拷问。AI负责扮演那个既定利益受损、态度保守甚至略带怀疑的甲方业务负责人,逼着求职者脱稿说话。
套路化的智商测试可以被算力破解,但不可预期的情绪博弈永远是一场硬仗。
在过去,麦肯锡面试里的Role-play全靠合伙人亲自陪演。由于每个合伙人的性格、语调、疲惫程度千差万别,面试尺度很难真正拉齐。把NPC的角色分派给AI,考官得以从疲惫的表演中脱身,专注于做冷眼旁观的裁判。
咨询三巨头的算法军备竞赛
顶尖咨询公司对AI的试探从来不是孤立事件。在麦肯锡测试虚拟客户的同时,波士顿咨询与贝恩同样在拉扯自己的招聘防线。
麦肯锡:虚拟Avatar对练 + 逻辑游戏Solve + Lilli助手探索
BCG:LLM案例分析 + AI素养测试(坚持人类决定)
贝恩:技术好奇心测评 + 人机协作分析
三家顶尖咨询公司对待算法的边界感非常一致:坚决不让AI掌握生杀大权。BCG在测试大模型案例分析时明确承诺,最终的雇佣决策始终由人类考官完成;贝恩在考察候选人的技术好奇心时,同样将算法限制在辅助评测层。
麦肯锡自身的工具箱更是层层设防。此次测试的虚拟客户与现有的逻辑游戏测评Solve、特定办公室试点的Lilli内部AI助手调用,以及初步简历初筛机器人彼此完全独立。这一试点若在2026年秋季达到预期,计划在2027年推广至更多办公室与职位。
这场军备竞赛的目标不是提效,而是防范标准化。
当应届生开始用大模型来训练面试、生成天衣无缝的结构化回答时,招聘方被迫把对抗推向未知的即兴交互。两千多年前《韩非子》讲“事在四方,要在中央;圣人执要,四方来效”,咨询业的核心权杖就是对商业不确定性的裁决权。如果一个分析师连机器扮演的半生不熟的客户都稳不住,就更谈不上在董事会上说服真人。
未解的偏差与隐私的灰区
尽管麦肯锡极力展现审慎,争议依然无法回避。
首当其冲的是评分的有效性与隐性偏差。在专业心理测量学界,一套全新的评测工具必须经过严格的效度与信度检验。麦肯锡至今尚未公开预测效度数据,没人确切知道这10分钟的表现与候选人未来在项目上的业绩有多大相关性。
候选人群体最切实的担忧落在了口音与表达风格上。大语言模型及其语音交互前端天然对主流白人口音和标准美式表达更具宽容度。如果一位母语非英语的候选人因为微小的语义停顿或文化语境差异,被AI客户误判为犹豫不决甚至缺乏自信,这种偏见很难被坐在后方的考官完全纠正。
- 风险.根据麦肯锡2026年8月1日起生效的《AI辅助面试隐私声明》,系统会抓取音视频生成对话实录与摘要,但条款中并未写明这些交互数据的具体保留期限。
在欧美日益收紧的算法雇用审查环境下,缺乏数据保留上限意味着合规隐患并未出清。此前麦肯锡试点的Lilli案例面试就因标准模糊在部分商学院候选人中遭遇反弹,新工具的黑箱属性显然只增不减。
智力劳动的本质正在被迫重写
过去四十年,初级分析师的护城河是案头研究、做PPT和建财务模型。但在今天,生成式AI可以在三十秒内吐出一张结构工整的竞品分析矩阵。
麦肯锡这次动作最大的启示,在于它明确宣告了纯粹的信息整理不再具备溢价。
当大模型把逻辑推演的边际成本压到接近于零,职场对初级人才的定价权迅速转移到了不可计算的情绪劳动上。同理心、感知现场空气的能力、被质疑时的情绪韧性,成了最后的硬通货。
应试者必须明白,你在屏幕前面对的不再是一个等待标准化答案的提问机,而是一堵试图用代码折射人类复杂情绪的墙。把AI当成工具还是当成对手戏演员,正在成为新一代白领不得不面对的第一门必修课。