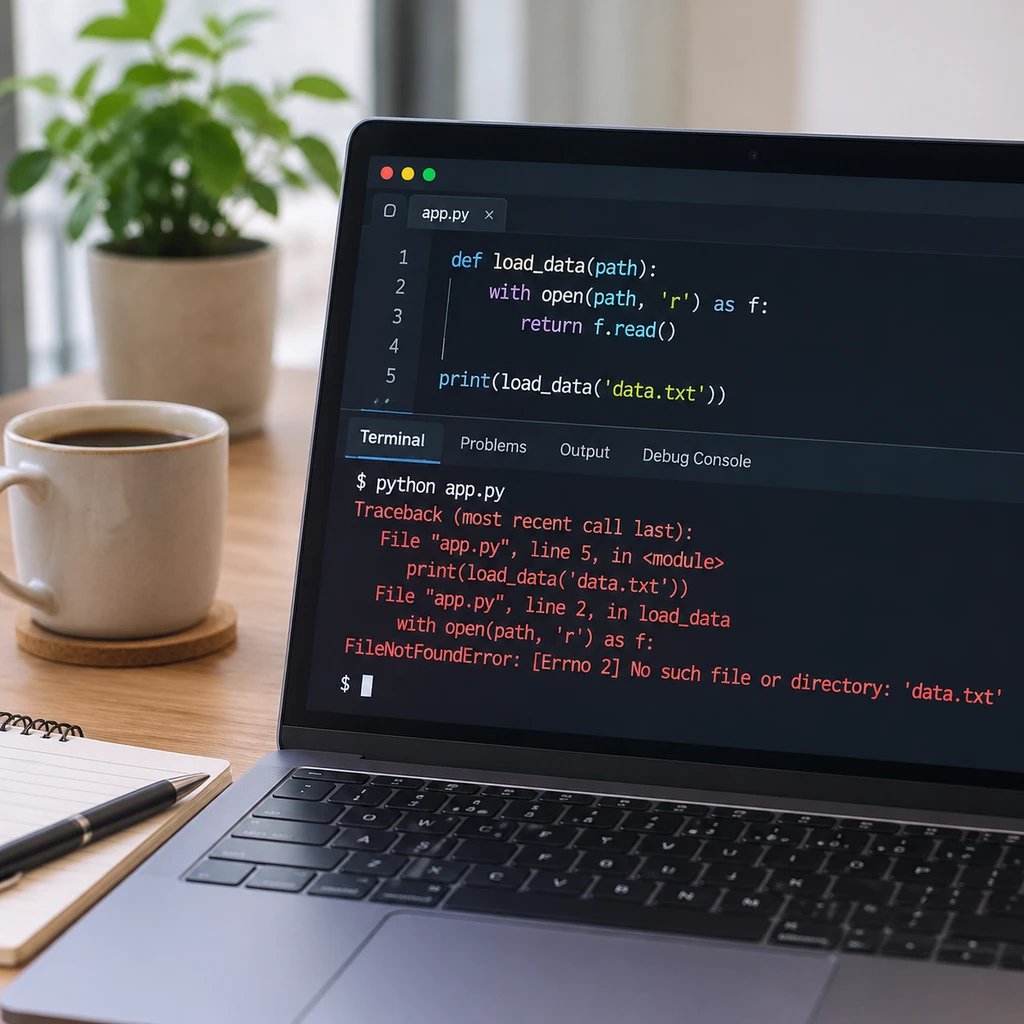
如果你习惯使用 LLM 这个 CLI 工具来记录与大模型交互的日常,近期可能会遇到一个突如其来的错误。在尝试调用 llm logs 查看历史记录时,程序可能会抛出 AttributeError: 'str' object has no attribute 'get' 异常,导致读取中断。
这并非工具本身的逻辑退化,而是底层 SQLite 的一次正本清源。本月发布的 LLM 0.37.3 版本,正是为了修补这次跨越层级的兼容性风波。
为什么底层变动会引发程序崩溃?
问题的核心在于 SQLite 3.54.1 对 JSON 处理逻辑的纠偏。在旧版本中,某些子查询返回的数据被隐式视作 JSON 对象,开发人员可以直接进行属性读取。但在新版中,数据库方明确界定通过 SELECT 子查询返回的结果本质上是 SQL 文本(Text),而非 JSON 结构。
这导致了应用层在处理历史数据时,接收到的不再是可供 Python 字典操作的对象,而是一个纯粹的字符串。当代码试图调用 .get() 方法获取字段时,Python 自然会报出 AttributeError。SQLite 的开发者认为这修复了一个长期存在的越权行为,但对于依赖此特性运行的 LLM 来说,这就变成了一场未提前通知的背刺。
工程化的代价:当 CI 成为盲点
此次风波中最值得复盘的,不是 SQLite 的技术修正,而是为什么直到用户报错,修复版本才姗姗来迟。
通常,开源项目依赖 CI 环境来确保兼容性。然而,如果 CI 系统中安装的 SQLite 版本滞后于 Homebrew 等包管理器的更新速度,这类因底层逻辑变更引起的隐形炸弹就永远无法在发布前被捕获。
- 风险.对于 CLI 类小型工具,高度依赖操作系统内置或包管理器提供的 SQLite 库,本质上是将自身的稳定性外包给了基础设施的更新节奏。
开发者在该项目中采取的解决方法也很直接,即在查询语句中显式包裹 json() 函数。通过 select json_object('a', json((select json_array(1)))) 这种强制转换,明确告诉引擎如何处理返回类型。这种做法虽然繁琐,但确实构建了一个更具鲁棒性的数据访问层,不再寄希望于底层的隐式兼容。
历史类比常说天下熙熙,皆为利来,放到技术圈,则是天下代码,皆为依赖而生。小型项目往往轻装上阵,通过复用成熟的底层基础设施来提升开发效率,但这种策略的副作用是生态的脆弱性,当基础设施的规则发生变动,上层建筑往往需要被迫重构。
- 建议.在构建涉及长期存储的数据访问层时,务必考虑底层逻辑变动带来的破坏性。对查询语句中的数据类型进行显式强约束,是防范此类基础设施逻辑微调的最优策略。
这次修复并不复杂,但它给所有开发者提了个醒,在享受开源生态便利的同时,也要随时准备好为底层依赖的正本清源支付维护代价。
【锐评】软件工程里的“修复”二字,往往伴随着对既有逻辑的无情重构。依赖底层数据库的逻辑微调,从来不是小事。