当一个机器人世界模型在连续 75 步的推块任务中只有 22% 的成功率,几乎所有算法团队的第一反应都是模型太小、物理规律学得不够准。独立研究者 Haddy Alchaer 针对 Yann LeCun 等学者发布的 JEPA 世界模型 LeWM 跑完 600 次实验后,得出了一个推翻行业直觉的结论:哪怕把模型的预测器直接替换成 100% 准确的模拟器真实物理引擎,原封不动去跑同样的 75 步任务,成功率也只有 42%。世界模型在长程任务上频频失手,病根不在动力学预测的微小误差累积,而在粗糙的推理搜索跨度与目标打分机制。
在不重新训练模型、不改动任何一个权重参数的前提下,Alchaer 仅在推理侧引入了 4 项规划与评分改进。其中两项将标准长程任务的成功率从 22% 拉升至 85%,追平了人类专家手把手喂子目标的上限;另一项针对目标图像评分方式的单一改动,直接让高难度分布外任务的成功率暴涨 60 个百分点,收益是换装完美物理引擎的 3 倍。对于正在世界模型赛道上砸算力的具身智能团队来说,这份实验报告敲响了一记警钟:与其盲目扩充预训练模型规模,不如先修好推理侧的规划尺子。
换上完美物理引擎也救不了长程崩盘,15M 参数的 LeWM 早就学透了短距物理
围绕世界模型该如何构建,AI 界一直存在两条路线的拉锯。主流阵营押注像素级生成式模型,试图用扩散模型预测未来的每一个像素;Yann LeCun 等学者则力推联合嵌入预测架构(JEPA),主张丢弃无关像素细节,只用编码器、预测器和规划器在紧凑的特征嵌入空间里闭环运行。2026 年 3 月 13 日,Lucas Maes、Quentin Le Lidec、Damien Scieur、Yann LeCun 与 Randall Balestriero 在 arXiv(2603.19312)上联合发布了 LeWM(LeWorldModel),将这一极简路线推向了极致。
LeWM 的参数量只有 约 15M。它采用预测损失加上鼓励高斯分布嵌入以防坍缩的 SIGReg 正则化器,从像素端到端联合训练图像编码器与动作条件潜预测器,把每一帧画面直接压缩成单个 192 维的 token,并在推理时用交叉熵方法(CEM)搜索动作序列。在论文附录的 Push-T 推块标准评估中(3 个训练种子、50 条轨迹、目标 25 步内可达、规划预算 50 步),LeWM 拿下了 96.0 ± 2.83% 的成功率,不仅压过了 DINO-WM 的 92.0 ± 1.63% 和 PLDM 的 78.0 ± 5.0%,规划耗时更只有 0.98 秒,比耗时 47 秒的 DINO-WM 快了约 48 倍。而在 DINO-WM 论文报告的同协议测试里,动作条件 AVDC 扩散模型基线的成功率甚至是 0%。
这样一个又快又准的小模型,一旦把目标拉远到 75 步且撤掉中间提示,成功率就会跌到 22%。为了搞清楚是不是 15M 的脑容量不够用,Alchaer 做了第一个残酷的对照实验:在 250 个 75 步长程任务中,每 25 步给一个人类专家演示的中间帧作为子目标,原版 LeWM 成功率达到 78%,而把它的预测器换成模拟器真实物理引擎,成功率是 77%。在 25 步短视距内,原版 LeWM 的单段成功率高达 89.7%,与真实物理的 90.5% 几乎没有差别。这组数据直接刺破了复合误差归因的传统借口——在训练轨迹覆盖的范围内,15M 小模型的物理推演能力早就见顶了。
算力翻 4 倍不如切分 25 步子目标,潜空间记忆图补齐了自主规划短板
既然模型在 25 步以内近乎完美,到了 75 步却连真实物理引擎都只能做到 42%,说明死穴出在规划器试图一口气搜索太远。更尴尬的是,单纯在推理侧堆算力根本救不回来。Alchaer 尝试把规划器重复运行 4 次并挑出成本最低的方案,消耗了 4 倍算力,成功率提升却连 1 个百分点都不到,因为 4 次搜索几乎总是同时成功或同时掉进同一个坑里。
真正的破局点是把 75 步长路拆成三段 25 步的短跑。这也是世界模型领域长期悬而未决的痛点:Meta 在 2025 年 6 月 11 日发布 V-JEPA 2(及动作条件版 2-AC)时,其公开测试协议在执行较长任务时依然明确依赖外部人工提供的视觉子目标序列,并未证明模型具备自主分解任务的能力。真实部署的机器人身边不可能随时站着一个人类专家喂中间帧,LeWM 要想独立走完长程,必须自己生成子目标。
Alchaer 的解法是直接利用 LeWM 编码器现成的潜空间几何性质。他把训练集中约 46 万个历史演示帧全部编码成 192 维向量,连成一张潜空间记忆图。测试表明,随便挑一个机器人 25 步内能推到的状态和一个推不到的状态,LeWM 的嵌入空间距离有 87% 的概率会把真正可达的状态排在更近的位置。这意味着潜空间本身就是一张合格的物理可达性地图。只要在图里搜索一条从起点到终点的路径,每隔 25 步提取一个节点当子目标,并在不同演示轨迹之间的跳跃加上额外代价(防止规划器为了抄近道在多条轨迹间胡乱拼凑出物理上走不通的路线,此前 1,015 次规划中有 318 次试图跳跃 6 次以上),75 步长程任务的成功率就从 62% 直接跳到了 85%。
这里还藏着一个基准测试的水分。标准 Push-T 测试是从同一条专家轨迹里截取起点和终点,而且所有演示最终都把木块推向桌面同一个区域,导致 84% 的测试目标在记忆图里都能找到几乎一模一样的现成状态;甚至只换一个随机种子,250 个任务里就有 38 个会在成功与失败之间翻转。当 Alchaer 把起点和终点换成来自不同轨迹的交叉组合、或者故意删光目标附近的记忆节点时,成功率立刻从 93% 暴跌到 32%。针对这个盲区,他利用桌面推块物理的平移、旋转和镜像对称性,把其他区域的记忆片段做几何变换后填补进空白区,不仅在删光目标周边记忆时把成功率拉回了 85%,在逆着训练数据流向的困难跨轨迹测试中,也把成功率从 27% 提到了 46%。
蓝色推盘暴露全局潜向量的盲区,改一下打分比换物理引擎管用 3 倍
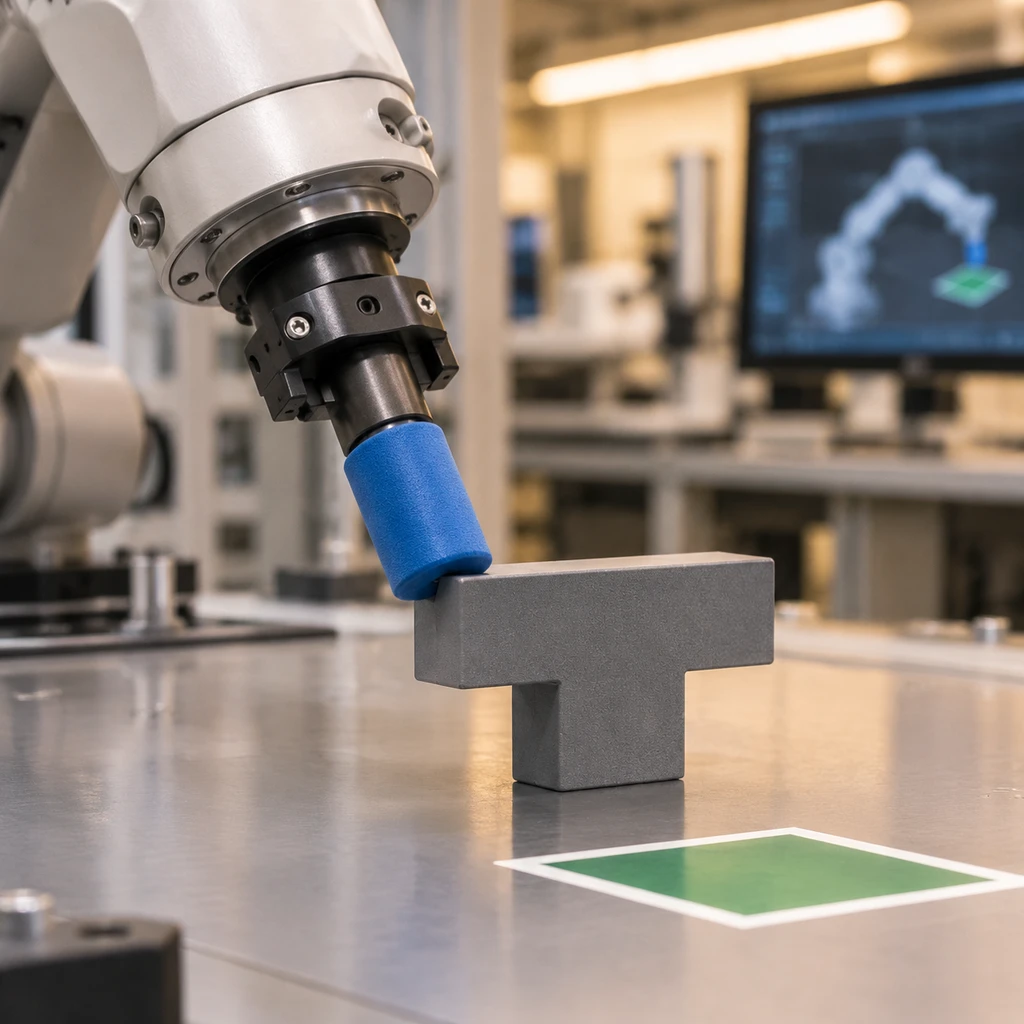
600 次实验里最让人后背发凉的发现,出现在第四个环节。Alchaer 在交互测试中看到一个诡异现象:机器人明明已经把灰色 T 形块推到了距离绿色目标标记 14 像素以内的达标位置,却在最后关头一头把木块撞飞,自己跑去追逐目标图像里蓝色机器推盘所在的位置。
把整张目标图塞进单个向量算距离,机器人就会为了凑齐背景而毁掉任务。
问题出在 JEPA 目标表征的底层逻辑上。Push-T 的目标是一张截取自专家演示的完整图片,画面里既有放在目标位置的灰色 T 块,也有当时恰好停在旁边的蓝色推盘。LeWM 把整张图片压成一个 192 维向量,里面并没有哪个维度单独标着推盘或木块。规划器在比较预测状态和目标状态的向量距离时,是在忠实地执行一个死板指令——同时把木块和推盘都摆进目标图的位置。
为了验证这个细节到底毁掉了多少规划,Alchaer 直接用模拟器真实物理规划器在 50 个高难度跨轨迹任务上做了测试。当成本函数同时计算木块和推盘位置时,50 个任务只成了 9 个(18%);一旦把推盘位置从评分里剔除、只看木块到没到位,50 个任务直接成了 39 个(78%),成功率暴涨 60 个百分点。那 30 个反败为胜的任务里,原本的规划器全都把推盘精准送到了目标图推盘位置半个像素以内,却在半路弄丢了木块。因为 LeWM 无法直接剥离推盘特征,Alchaer 在推理时把目标图换成木块位置相同、但推盘处于 16 个不同历史位置的图像集合,只要预测状态接近其中任意一张就算达标,立刻在不重训的情况下把 LeWM 在该测试上的成功率从 11% 翻倍到了 23%。
- 结论.对于做具身智能和 VLA 的算法团队,与其花几百万美元算力把世界模型从 15M 扩到百亿参数去抠那 1% 的物理预测精度,不如立刻排查推理侧的目标状态度量——把机械臂末端位置从任务完成条件里解耦出来,是性价比最高的改进。
- 风险.Alchaer 的记忆图几何变换高度依赖 2D 桌面推块的平移与旋转对称性,而在 DINO-WM 依然占优的 OGBench-Cube 等 3D 复杂多物体遮挡场景中,这种简单的几何修补和 192 维单 token 全局压缩能否撑住,仍是接下来最大的待解变量。