跨平台容器运行时 Kiri 刚刚放出 0.2.0 Beta 版,免费支持 Mac、Windows 和 Linux,界面自带简体中文等 15 种语言。开发者 Precious Okwu(GitHub 账号 libracoder)直接把战书贴在首页,宣称在限制 2 CPU 和 8 GB 内存的 Apple Silicon Mac 上,执行一行 docker run --rm alpine true 只要 22 毫秒,比 Docker Desktop 的 178 毫秒快了 8 倍,也甩开了 Colima 的 152 毫秒和 OrbStack 的 279 毫秒。但只要翻开它自己的底层跑分表就会发现,这个用 Rust 从头重写 Docker API 的新工具,在决定日常开发体感的宿主机文件挂载读取上只有 1,724 MB/s,连 Colima(5,235 MB/s)的三分之一都不到。
Kiri 还顺手塞进了大约 20 秒启动的 k3s 集群、Linux 虚拟机、BuildKit 漏洞扫描,以及一键把本地容器暴露到公网 runkiri.cloud 的 Kiri Share。功能列表很抓人,但容器桌面工具的决胜局,从来不在跑完一行空载命令的几十毫秒里。
五跳砍成一跳,22 毫秒是怎么省出来的
在 Mac 和 Windows 上跑 Linux 容器,请求必须跨过宿主系统与 Linux 内核的虚拟化边界。传统 Docker Desktop 和 OrbStack 之所以在启动瞬间偏慢,是因为历史演进留下了一条五跳链路。
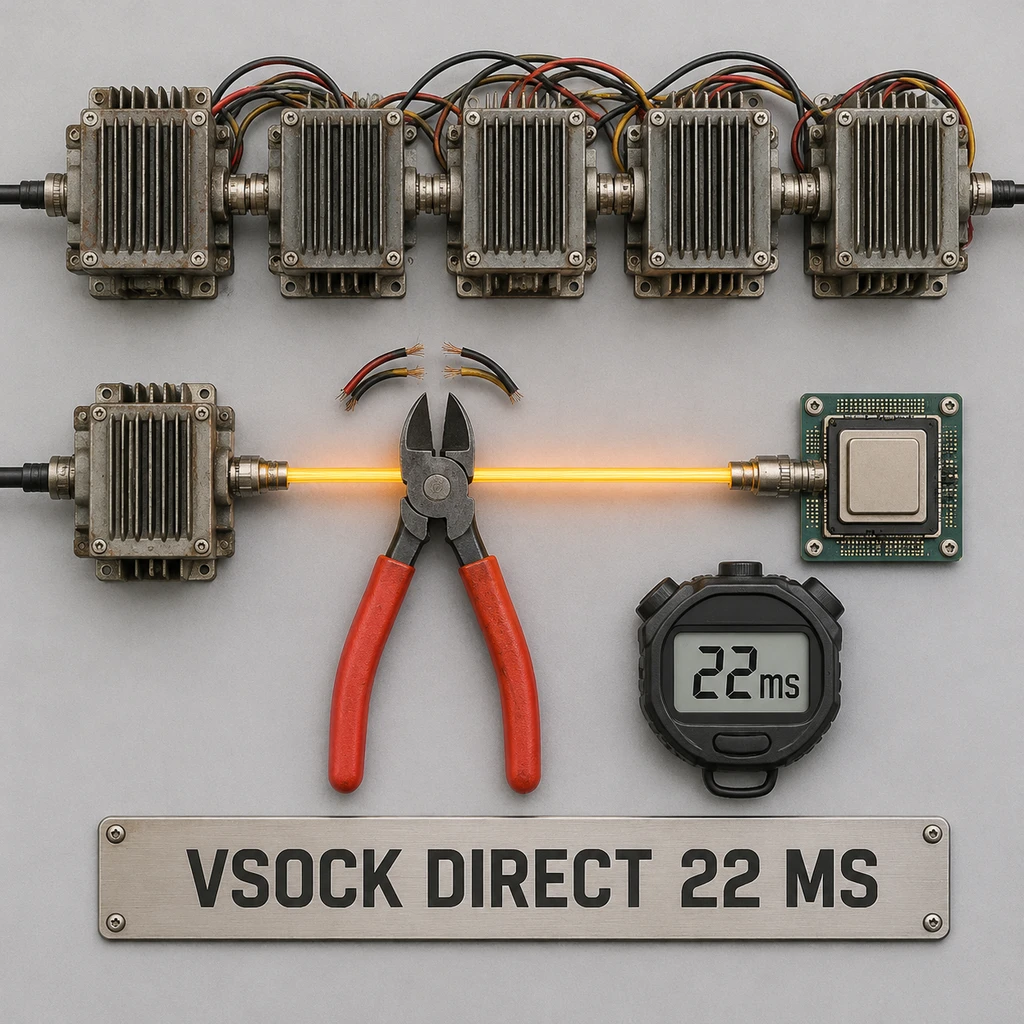
每敲下一次 docker run,命令要依次穿过 Docker CLI、dockerd、containerd、containerd-shim,最后才交到 runc 手里去创建容器。更吃资源的是,只要容器活着,宿主机里就得留一个 shim 进程善后;按 Kiri 官方在测试机上的统计,同时跑 143 个容器,光这堆常驻 shim 就要吃掉 1.13 GB 内存。
Kiri 的做法简单粗暴,直接把中间商全砍了。它在 macOS 上通过 Apple Virtualization.framework 拉起一个精简 Linux 虚拟机(冷启动 112 毫秒),宿主机和虚拟机之间只走一条耗时 31 微秒的 vsock 通道,底层由轻量级 Rust 代理 kiri-init 作为一号进程,直接调用内核的 clone3、namespaces 和 cgroups 拉起容器。容器跑起来后不留任何伴生进程,守护进程本身占约 15 MB 内存,闲置 1 分钟自动休眠,唤醒只要 0.15 秒。
翻开跑分表背面,文件读取比 Colima 慢三倍
如果只看首页海报,很容易以为容器桌面的性能天花板被掀了。但把 Kiri 官方在 Apple M3 Max(64 GB 内存)上测出的四方完整数据拉出来对账,画风立刻变了。
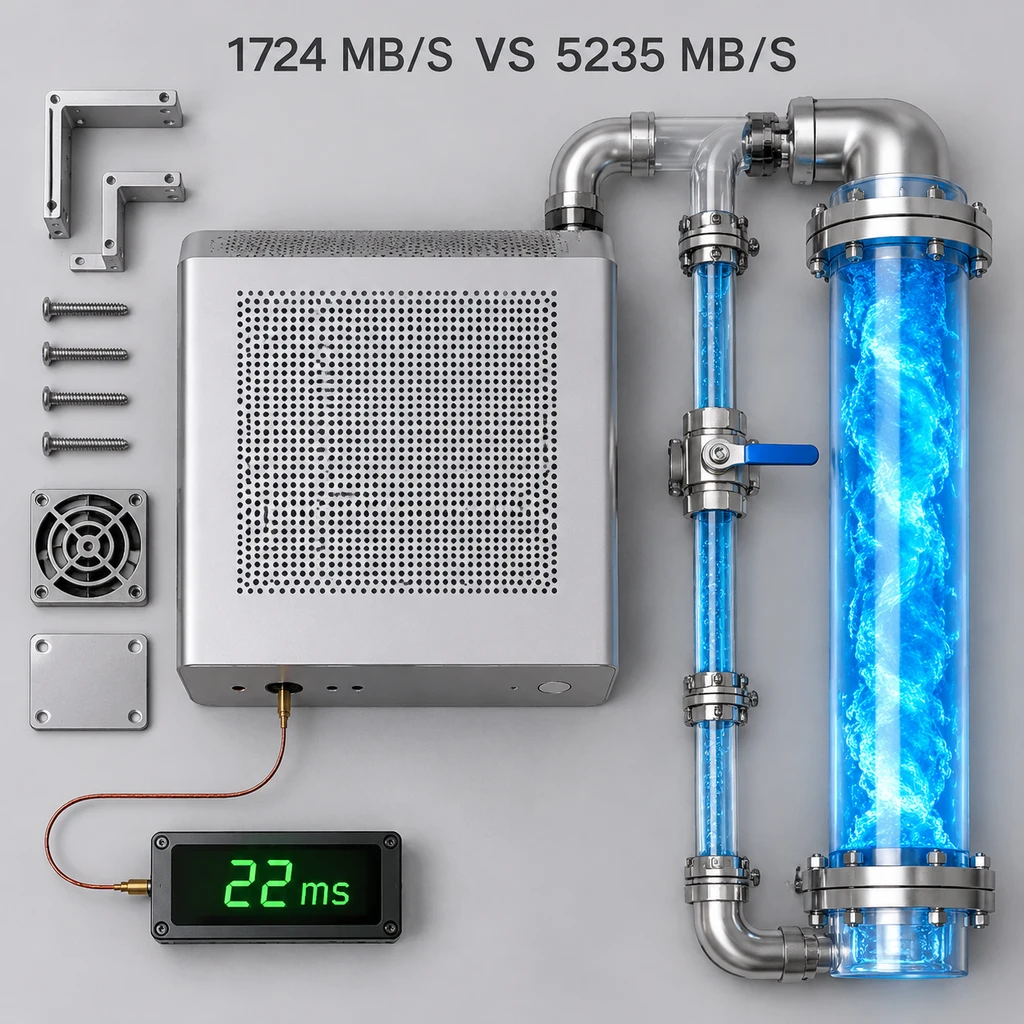
砍掉中间层能赢下起跑线,赢不下日常读写的主赛场。
首先是测试口径里的猫腻。Kiri 在首页把 CLI 路径的 22 毫秒和直连 Docker API 的 3.1 毫秒并排放在一起,把差值归咎于 Docker CLI 自身启动太慢。但核对底层测试条件会发现,22 毫秒跑的是默认的 bridge 网络,而 3.1 毫秒那组偷偷加上了 --network none 参数,直接跳过了网络命名空间和网桥配置,拿砍掉网络栈的裸跑成绩去对比正常启动,算不上讲究。
更关键的落差在持续工作负载上。很少有程序员买好电脑是为了在终端里每秒敲几十次空载的 alpine true,大家真正在意的是挂载本地代码目录时的编译读写,以及本地微服务的网络吞吐。在官方同一份测试报告里,Kiri 只有在短生命周期操作(如 docker run 22 毫秒、docker exec 15.7 毫秒)上拿到第一;一旦进入硬核的 I/O 与网络环节,排名立刻洗牌:
| 实测指标(Apple M3 Max 限制 2C8G) | Kiri | OrbStack | Colima | Docker Desktop |
|---|---|---|---|---|
空载容器启动(docker run) | 22 ms | 279 ms | 152 ms | 178 ms |
| 1 GB 挂载读取(Bind-mount) | 1,724 MB/s | 3,240 MB/s | 5,235 MB/s | 1,354 MB/s |
| 每秒新建 HTTP 连接数 | 1,892 /s | 2,389 /s | 1,484 /s | 865 /s |
看清这张表,就能明白桌面容器赛道的路线分野。OrbStack 和 Colima 属于虚拟机优化派,它们把大量精力花在打磨宿主机文件共享和网络栈上,让你在容器里编译大型 Node.js 或 Rust 项目时不卡顿;而 Kiri 把技能点全点在了砍掉进程调用链上,启动快如闪电,但 virtiofs 文件共享的吞吐量只比垫底的 Docker Desktop 强一点。
自研 API 换速度,这笔账到底合不合算
为什么公认好用的 OrbStack 宁可背着 279 毫秒的启动耗时,也不肯把 containerd 和 shim 砍掉?并非做不到,而是不敢。
《韩非子》里讲过「郑人买履」,宁信度,无自信也。在基础设施领域,开发者认的那个「度」,就是原版 Docker Engine(dockerd 与 containerd)积攒十年的边缘行为兼容性。OrbStack 和 Colima 在虚拟机里跑的是原汁原味的 Docker 引擎,所有古怪的 Compose 配置、Dev Containers 插件和复杂的网络拓扑都能无缝接管。
Kiri 走的是另一条险路。它没有跑原版引擎,而是用 Rust 自己重写了一套兼容服务端去应答 Docker API;镜像构建靠的是外挂托管 moby/buildkit 容器,所谓 20 秒启动的 Kubernetes 也只是在容器里套娃跑了个单节点 k3s。这种重写路线在八十年代 PC 兼容机混战时就演过一回,当年谁都能把 BIOS 启动做到极快,但真正决定生死的,永远是跑起大型工业软件时会不会莫名报错。
更让我对它保持克制的,是项目工程细节里透出的粗糙感:
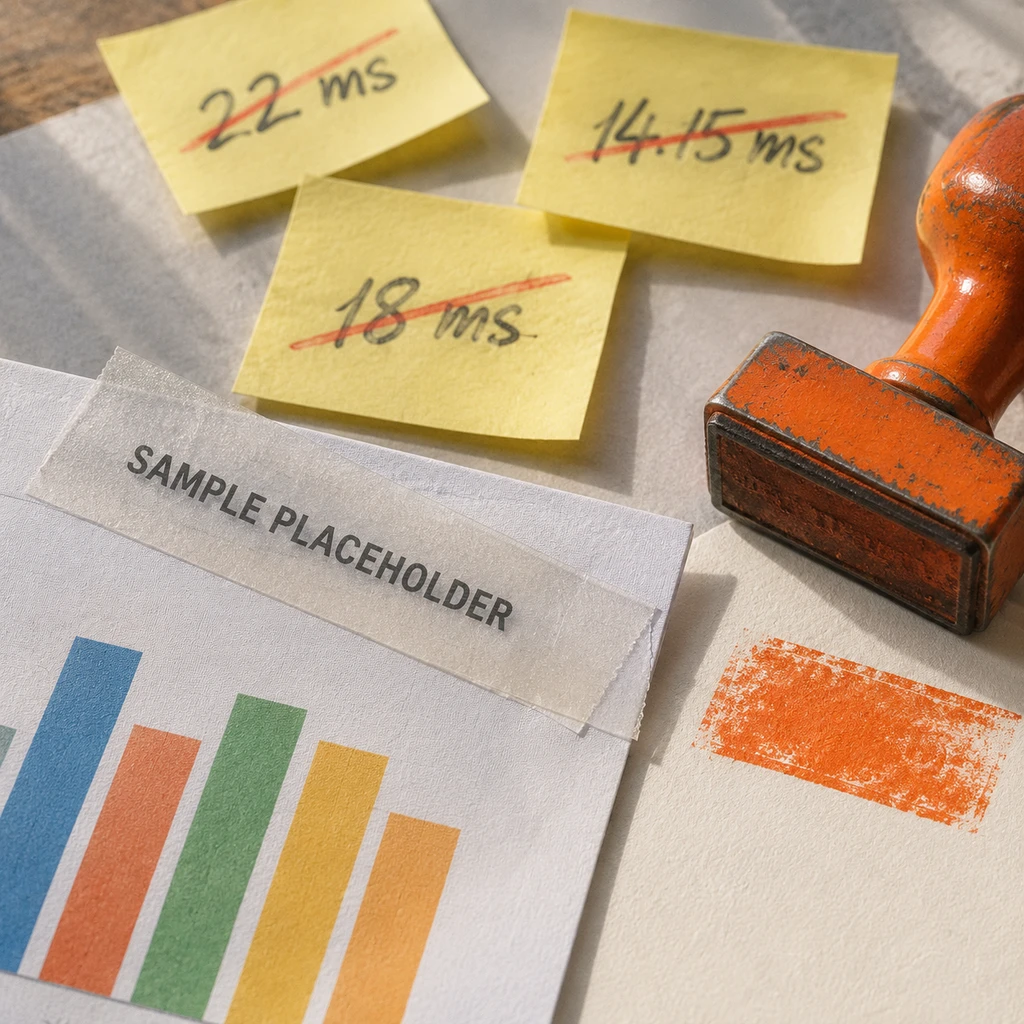
- 风险.首页那张极其醒目的「10 个运行中容器 CPU 与内存占用对比图」,旁边至今印着一行小字说明那只是 Sample 样本占位符,实测数据根本还没填上去;而且文档各处的数字频繁打架,首页写 22 毫秒(基于 11 月 2 日的 0.1.13 版测试),Mac 子页面写 14.15 毫秒,到了 Hacker News 发帖标题变成 18 毫秒,甚至该帖因为正文里疑似忘了删掉 AI 生成指令而被社区标记为 flagged。再加上 FAQ 宣称双开源协议、GitHub 仓库却只挂了 Apache-2.0,以及 Windows 安装包尚未签名,这些信号都指向同一个事实——它离成熟的生产工具还有不小的距离。
对于每天要在本地跑成百上千次短命容器做自动化测试(CI Runner)或 Serverless 模拟的极客,Kiri 砍掉 shim 的单守护进程设计确实切中了痛点,值得一试。但如果你主力开发重度依赖宿主机代码挂载的大型工程,留在 OrbStack 或 Colima 依然是更稳妥的选择;至于 Kiri 什么时候能把首页的占位图换成真数据,什么时候能补齐文件读写短板,不妨等它先把宣传口径对齐了再看。