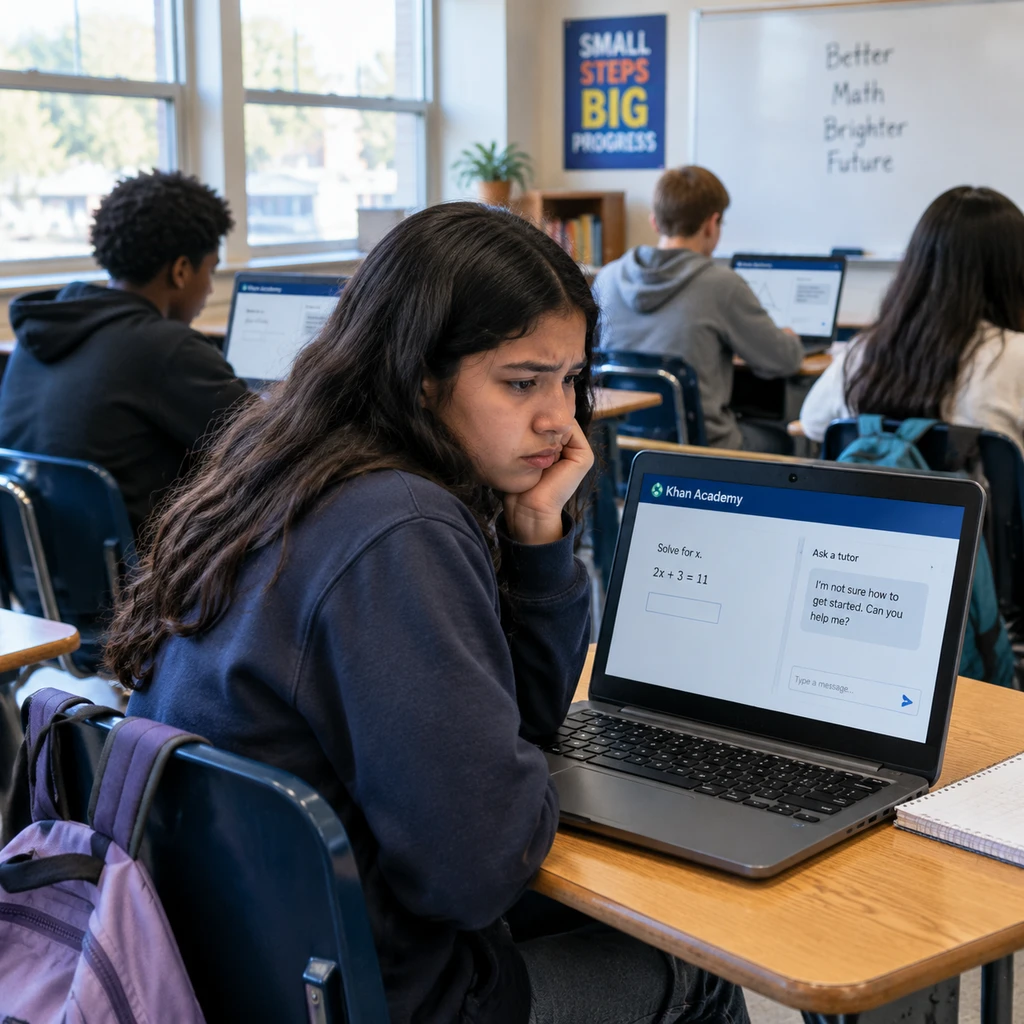
给每个成绩垫底的孩子配一个随叫随到、永远耐心解答的苏格拉底式专属家教,是大模型席卷教育界时最具诱惑力的承诺。然而在真实的公立初中课堂里,这项耗费千万美元算力的技术改造,交出的第一份严肃成绩单却近乎原地踏步。
经济学家 Philip Oreopoulos 与 Nina Low 在美国全国经济研究所发布了一项长达两年的整群随机对照试验结果。研究跟踪了田纳西州 18 所初中在每日补习课中使用 Khanmigo 的情况,结果显示学生每学期数学成绩仅微幅提高 1.3 个全国百分位,换算为整学年增益大约只有 0.06 至 0.08 个标准差。更残酷的对照在于,这一增益与学生单独使用原版 Khan Academy 题库刷题的效果基本重合。大模型对话层耗费的大量交互,在最终的标准化测试里几乎没有沉淀出额外的因果收益。
96% 的尝鲜率与 14.5% 的实质提问
这项试验覆盖了 18 所学校的 53 个年级集群,包含 28 个实验组与 25 个对照组,横跨 2024-25 与 2025-26 两个学年,累计积累了 6,902 个学生-学期观测值。从干预节奏来看,收益高度滞后且集中在第二年:第一年的提分效应仅为 +0.020 个标准差,在统计学上无法与零区分;即便到了第二年提升至 +0.084 个标准差,经参与强度调整后外推出的全年积极参与上限,也仅停留在 0.14 个标准差。
技术并未遭遇可用性门槛,真正瓦解神话的是学生的行为惰性。数据显示有 96% 的学生在学期中尝试过 Khanmigo,但好奇心退潮之后,中位数学生仅在三分之一的练习日向 AI 发送过消息。而在系统记录到学生做错题的练习会话中,主动向 AI 求助的比例仅有 17%。即便发出了消息,其中仅有 14.5% 包含实质性的数学问题或逻辑推理步骤,其余大部分是敷衍点击系统推荐的预设提示,或是直接向对话框输入裸答案碰运气。
在缺乏外部强制督导的自习场景下,学生宁愿跳过题目、胡乱蒙选,也不愿与一个只会用反问句启发自己的聊天框推演三轮逻辑。所谓的只要点一下就触手可及,成了产品设计者的一厢情愿。
物理距离只有一次点击,但在求助回避的本能面前,它成了一道天堑。
供给侧的启发式幻觉与求助回避
教育科技领域长期存在一种供给侧幻觉:假设只要提供无限算力、零延迟、不带情绪嘲讽的解题辅导,落后学生就会自然而然产生求知欲。Khan Academy 在 2024-25 学年报告其全球注册用户突破 200 万,同比增长 731%,并已进入全美学区覆盖 77 万名学生。但在这一连串亮眼的铺量数字背后,官方从未公开过针对标准化考试成绩的因果随机对照评估。
类似的问题在其他区域同样上演。多伦多大学与波多黎各教育部合作展开的为期 9 周的评估中,166 名完成前后测的学生里仅有 95 人至少用过一次 Khanmigo。更反常的是,从秋季到春季,这批学生的数学学习兴趣、自尊心以及学业自我效能感得分反而出现了下滑。
- 风险.没有强约束的学习场景中,把生成式 AI 当作纯自主工具放给薄弱学生,不仅无法建立元认知,还会加剧畏难情绪。
独立认知研究此前已多次指出,大模型直接面向学生时容易诱发认知拐杖效应。学生在 AI 步步拆解下看似完成了即时练习,一旦脱机独立测试,由于解题链路从未在神经回路中完整建立,成绩往往出现断崖。Khanmigo 虽在提示词层面严格锁死了不直接给答案的规则,但其温和的循循善诱,在缺乏求助动机的学生面前,直接被异化成了阅读负担。
人机协同与端到端对话的分岔路口
教育 AI 的落地路径目前正在分裂为截然不同的技术范式。一端是以 Khanmigo 为代表的直接面对学生的端到端对话机器人;另一端是以 Carnegie Learning MATHia 为代表的结构化自适应认知建模系统;而在两者之间,以斯坦福大学 Tutor CoPilot 为代表的人机协同路线正在拿出更有说服力的实证。
斯坦福针对 Tutor CoPilot 开展的预注册随机试验纳入了 783 名导师与 1,000 多名学生。该系统并没有把学生推给聊天框,而是把 AI 藏在真人导师的屏幕背后,实时提示教学策略与诊断思路。结果表明,这种把模型当作教研副驾的模式,使单节辅导课的学生知识掌握率直接提升了 4 个百分点,且对教学经验不足的新手导师提效尤为明显。
对比揭示了一个被技术热潮掩盖的事实:中学生课堂最稀缺的资源不是知识图谱的拆解精度,而是维持专注和直面错误的社交约束力。大模型擅长输出解释,却无法建立人际间的情感监督。将 AI 放在人类教师身后,既规避了未成年人面对模型时的敷衍偷懒,又填补了新手教师的专业经验缺口。
- 建议.学区采购决策者应重新评估纯对话类 AI 的软件授权支出,将预算向具有强制思考流程与辅助真人教师的人机协同工具倾斜。
随着田纳西州长达两年的对照数据出炉,各大学区在评估软件授权的投入产出比时将不得不更加现实。AI 在教育场景中若要走出高点击、低转化的泥潭,就必须放弃简单的聊天界面包装,深入到强制思考与课堂流程的底层重构之中。