大模型竞争从预训练走向落地推理之后,显存容量正在成为最昂贵的物理门槛。英特尔正式发布了面向智能体与推理场景的数据中心芯片 Intel GPU D270(代号 Crescent Island),搭载 32 个 Xe3P 核心与 256 个 XMX 矩阵引擎,提供 1.3 PFLOPS FP8 算力,官方宣传显存最高可达 480 GB LPDDR5X,并采用 350W 风冷设计与标准 PCIe 5.0 接口。
这并非一张用来在绝对性能上压倒旗舰的算力怪兽,而是英特尔对当前 AI 基础设施高昂改造成本的一次精准狙击。英特尔放弃了昂贵且依赖复杂散热的 HBM 显存,试图让企业在既有的风冷机房里,塞进足以常驻超长上下文的模型。但大显存并不等于高吞吐,这张卡在规避基础设施重构成本的同时,也做出了极为激进的工程妥协。
规格拆解:公版 160 GB 与伙伴卡的容量口径
英特尔在宣传材料中强调的 480 GB 显存,并不等同于开箱即得的通用标准。英特尔自研公版 D270 的原生显存实际为 160 GB LPDDR5X,峰值显存带宽为 1.5 TB/s;所谓 480 GB 是开放给 OEM 与 ODM 合作伙伴的定制卡配置上限。
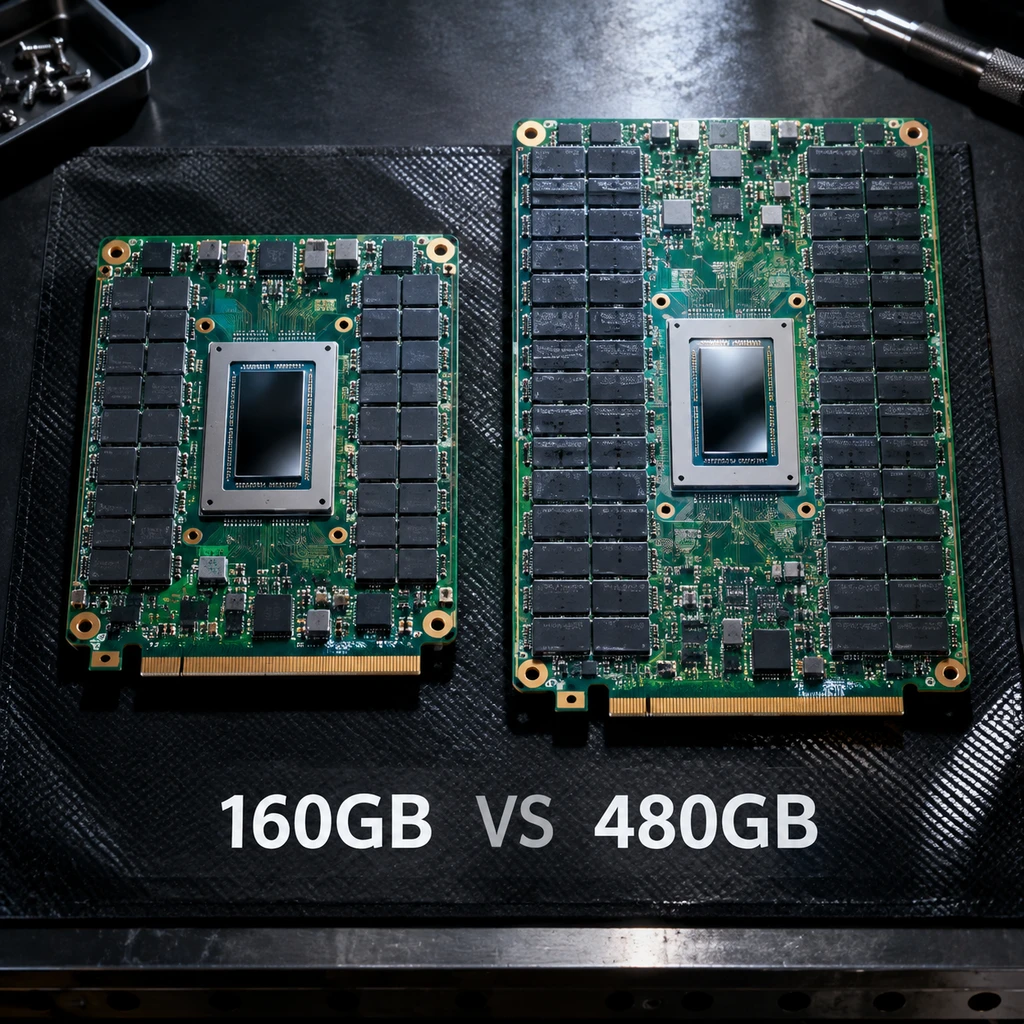
这意味着想要拿到完整 480 GB 容量的企业,必须依赖特定硬件厂商的定制出货,可能面临额外的供应链溢价与量产排期。产品目前已于 2026 年 10 月启动客户送样,但英特尔尚未公布正式的批量发售日期与官方建议售价。公版与定制卡之间的规格分野,构成了评估其实际部署门槛的首要变量。
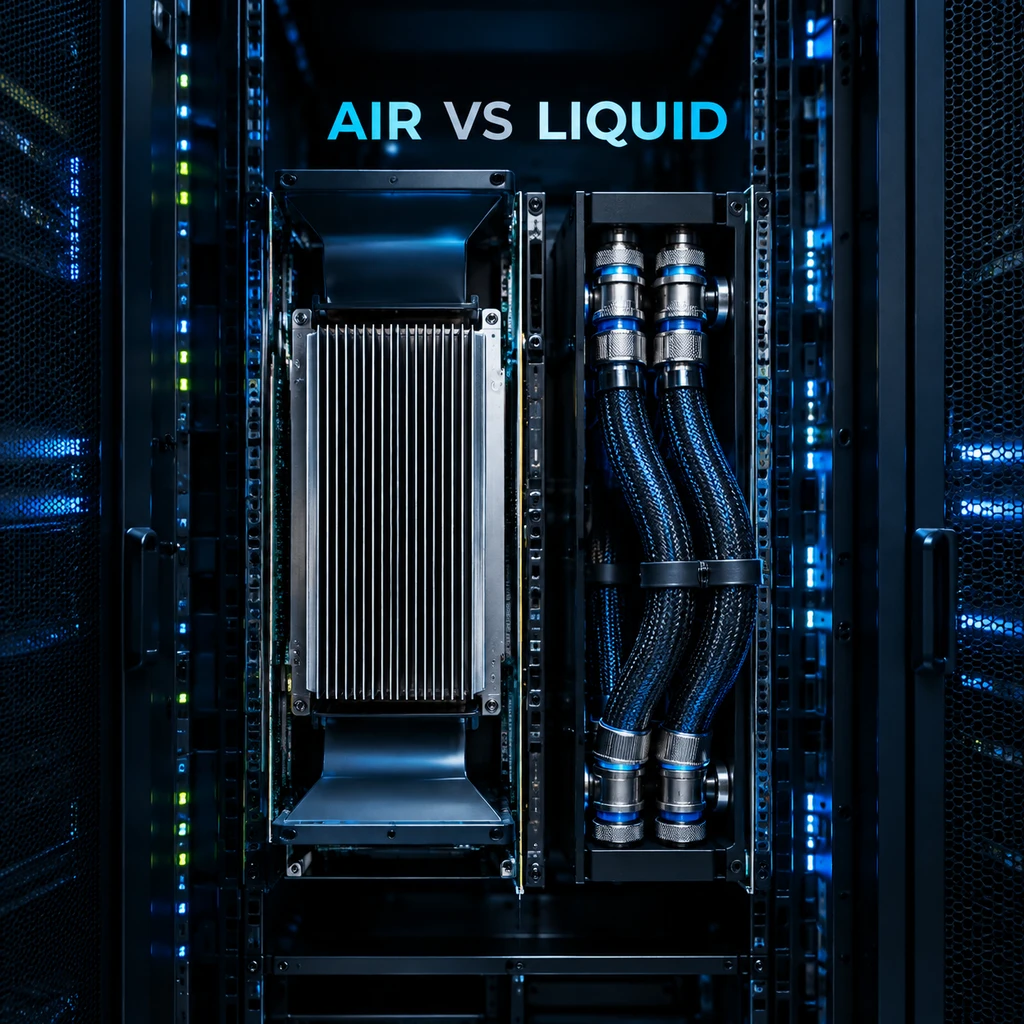
避开液冷改造,切入企业级硬件断层
当前 AI 加速卡阵营被两大主流路线占据:一端是全面倒向高带宽内存 HBM3E 与液冷散热的高性能集群卡,例如 AMD MI350X 与 MI355X 显存达 288 GB,但功耗高达 1000W 至 1400W;另一端是适配传统机架的 PCIe 工作站与服务器卡,例如英伟达 RTX PRO 6000 Blackwell Server Edition,带宽虽有 1.597 TB/s,但显存仅为 96 GB GDDR7,且功耗上限达到 600W。其工作站版本官方商城标价高达 16000 美元且处于缺货状态。
| 产品型号 | 显存容量与类型 | 显存带宽 | 散热与功耗 | 年电费测算 (0.1美元/度) |
|---|---|---|---|---|
| Intel GPU D270 | 160-480 GB LPDDR5X | 1.5 TB/s | 风冷 / 350W | 约 307 美元 |
| NVIDIA RTX PRO 6000 | 96 GB GDDR7 | 1.597 TB/s | 风冷 / 600W | 约 526 美元 |
| AMD MI350P | 144 GB HBM3E | 4.0 TB/s | 混合 / 450-600W | 约 394-526 美元 |
| AMD MI355X | 288 GB HBM3E | 8.0 TB/s | 液冷 / 1400W | 约 1226 美元 |
这种市场格局让许多无法承担液冷改建成本、供电配额受限的中小数据中心陷入两难。AI 智能体工作流要求容纳 100K 以上的长文本上下文与多轮检索数据,显存容量不足就必须通过多卡并联切分模型,这在常规企业服务器中极难部署。
D270 的战略落脚点正在于此:以 350W 的低功耗守住免液冷改建的底线,通过 LPDDR5X 堆出大容量显存,让长文本 KV 缓存无需切分即可常驻单卡。
D270 的核心逻辑是用显存容量换取常驻空间,用标准风冷规避机房改造成本。
- 结论.对于电力配额紧张、无力进行液冷改造的中小数据中心,D270 提供了无需重构机房即可承载超长文本的硬件备选。
无法回避的物理法则:1.5 TB/s 带宽墙
尽管超大容量显存解决了长模型参数与上下文常驻的问题,但硬件底层依然受制于严格的物理定律。在推理运行中,计算流程被清晰地划分为两部分:一次性吞吐大量文本的 Prefill 预填充阶段,以及逐字输出的 Decode 生成阶段。
D270 的 1.5 TB/s 带宽虽能与使用 GDDR7 的英伟达方案持平,但与拥有 8 TB/s 带宽的 AMD MI350X 等 HBM 方案相比,差距十分显著。在 Decode 阶段,GPU 必须频繁从显存中搬运模型权重与庞大的 KV 缓存,显存带宽成为直接瓶颈。在处理数十万 Token 的长上下文时,如果并发请求数不足以摊薄访存开销,单用户单 Token 的生成延迟可能显著增加。
英特尔官网对标 RTX PRO 6000 的数据基于 2026 年 2 月的内部推演,而非实际硬件投产后的实测。截至 2026 年 10 月中旬,公开市场尚无针对 D270 在 vLLM 或 PyTorch 环境下的独立第三方跑分,缺乏每秒生成 Token 数量与首字生成时间等关键实测指标。
- 风险.若业务场景对交互响应速度要求极高,D270 受限于 1.5 TB/s 的显存带宽,在长文本解码时极易出现延迟瓶颈。
软件生态与交付节奏决定最终落地
在企业计算的整体拥有成本模型中,D270 的电力消耗优势明确:按每度电 0.10 美元计算,其单卡年耗电成本约为 307 美元,远低于 600W 竞品的 526 美元与 1400W 液冷卡的 1226 美元。对提供按 Token 计费的云服务商或部署私有模型的企业而言,这能显著降低日常运营开销。
但这一算力账本能否成立,核心取决于软件适配深度。尽管英特尔承诺为开源模型、PyTorch 以及 vLLM 的 Intel XPU 后端提供首日支持,但主流框架在 Xe3P 架构上的算子编译效率与长上下文加速组件的稳定性,仍需经受企业级生产环境的压测。
决定 D270 能否在推理市场真正立足的,不是宣传册上的 480 GB 显存容量,而是合作伙伴定制卡的实际采购价格、规模出货时间表,以及在开源框架下首批端到端解码吞吐量的真实数据。