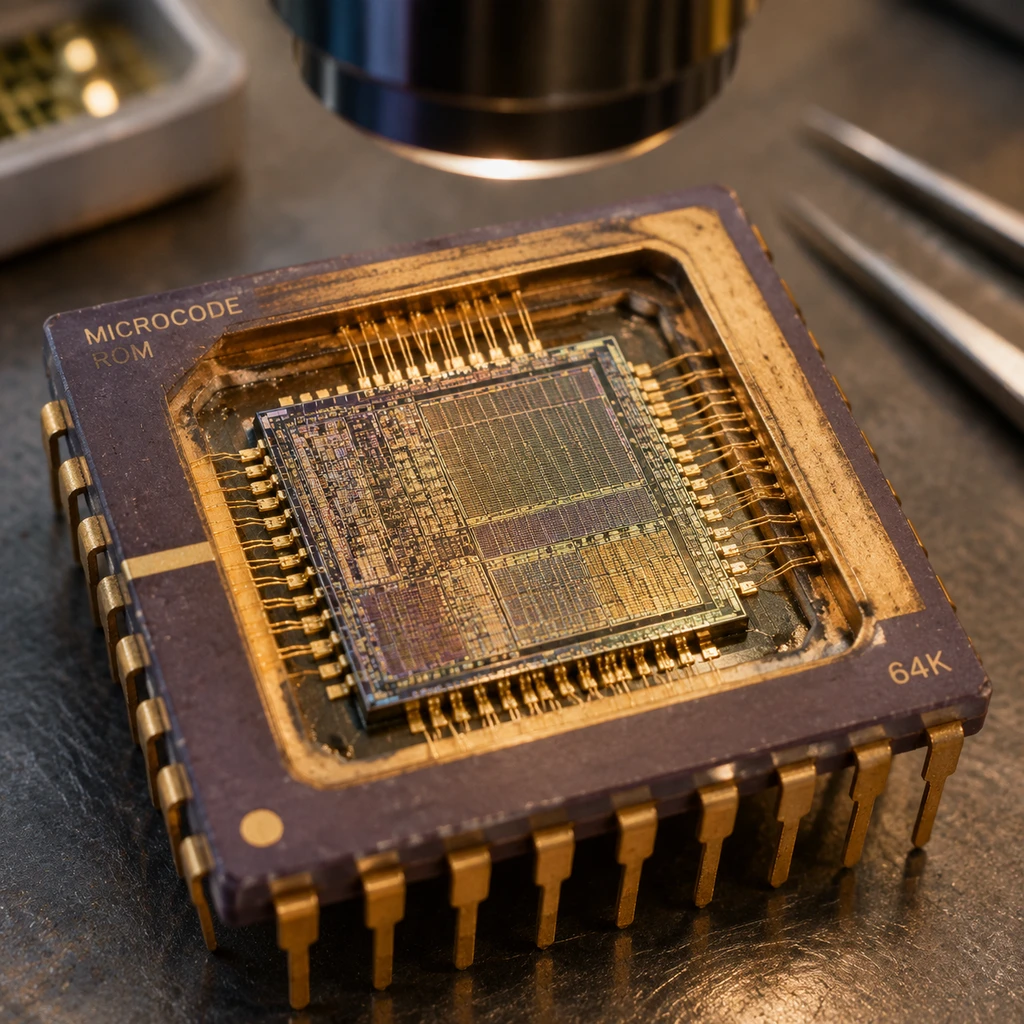
逆向工程专家 Ken Shirriff 近日用凿子撬开了一枚生产于四十多年前的 Intel 8087 浮点协处理器陶瓷外壳,在显微镜下逐层重构了这枚传奇芯片的微指令与数据通路。这项硬核逆向不仅揭开了 1980 年让 IBM PC 浮点加法性能跃升近百倍的工程黑盒,更呈现了一个被历史尘封的计算分水岭:在 IEEE 754 浮点标准正式出台五年前,工程师与数学家如何用硅片与 1648 条微指令,强行定义了现代计算的数值基石。
8087 从来不是普通的外围加速模块,而是一场由学术界与工业界联手发起的激进实验。面对早期微处理器纯依靠软件模拟浮点计算的巨大延迟,8087 确立了硬件级扩展精度与微码控制体系,彻底终结了微型计算机只能处理整数简易逻辑的时代。
显微镜下的硅片布局:1648条微指令调度80位数据通路
在 8087 问世之前,主流微处理器如 Intel 8086 仅具备原生整数处理能力。若要在程序中完成 1.23 这类带小数点的实数计算,程序员只能调用耗费数百乃至数千个时钟周期的纯软件子程序。20 世纪 70 年代末,Intel 邀请加州大学伯克利分校数学家 William Kahan 与芯片架构师 John Palmer 合作,为 8086 研发一款专用的数学协处理器。
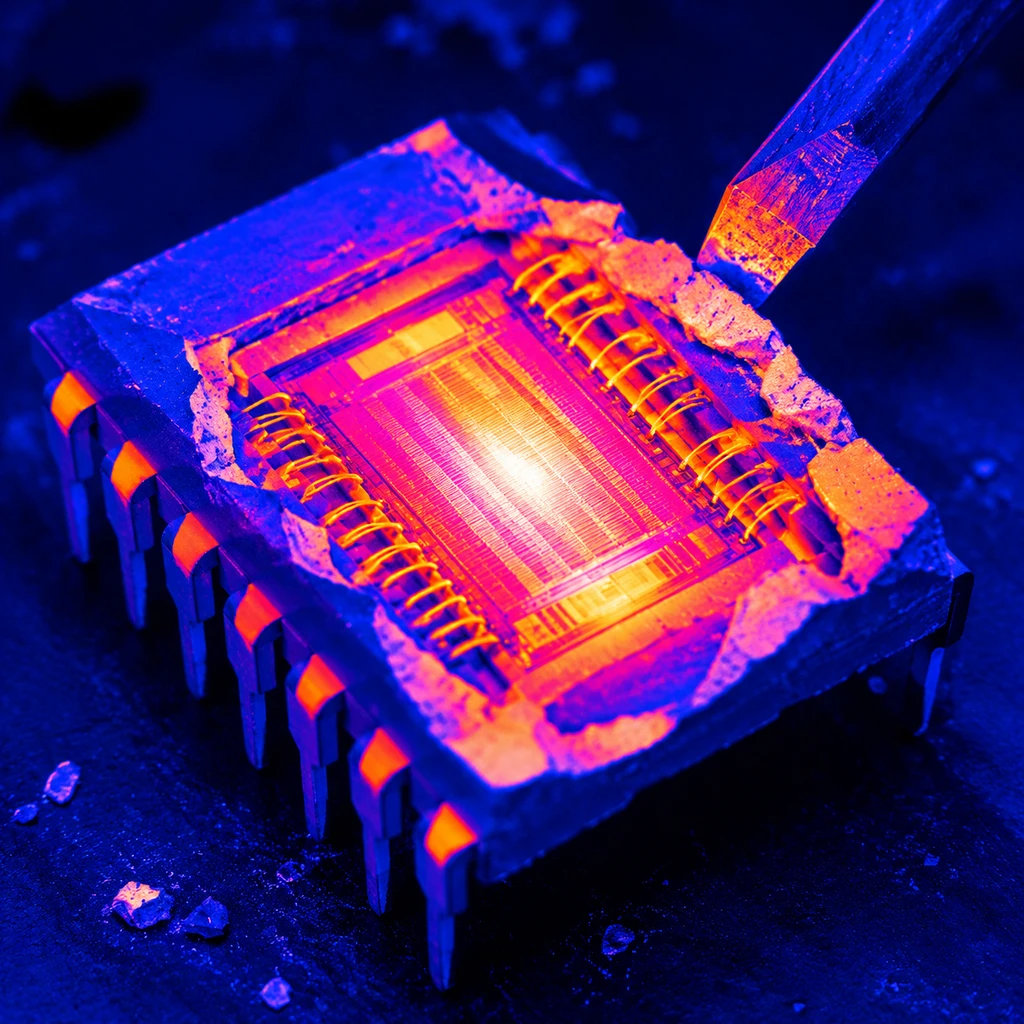
Kahan 坚持采用极度严苛的数学精度,这一设计直接奠定了后来的 IEEE 754 浮点标准原型。在硅片照片中,最引人注目的是占据芯片核心的微码只读存储器(ROM),其总容量仅为 1648 条微指令,每条位宽为 16 位。正是这套紧凑的固化代码,通过调度底部的 80 位专用数据通路,完成了复杂的四则运算与超越函数。
为消除长阶差计算过程中的累计截断误差,8087 内部一律采用 80位临时实数 格式:包含 1 位符号位、15 位带偏置的指数位,以及高达 64 位的尾数。配合芯片集成的 8 级数值堆栈寄存器,芯片能够直接在硬件内处理超出常规 32 位浮点极限的庞大数据。
解构百倍加速:硬件移位器打破软件模拟瓶颈
官方文献与技术社区常将 8087 的效能简化为让系统提速百倍,但这其实混淆了微观算术指令与整机综合表现的界限。单就寄存器间的浮点加减法而言,5MHz 主频下的 8086 运行 Intel 官方软件模拟器需要约 1600微秒,而 8087 的硬件执行周期仅为 70 至 100 个周期,典型耗时仅需 17微秒。
这一特定单指令的提速倍数达到了 94倍。若换成算法更严苛的平方根运算,8087 更是从软件模拟的 19600 微秒骤降至 36 微秒,实现了 544倍 的计算鸿沟。
造成这一代差的决定性要素并非算术频率,而是硅片底层的专用硬件电路。纯软件模拟浮点数对齐时,必须依赖 8086 的通用寄存器通过循环单步位移来消除阶差,循环指令的额外开销极大。
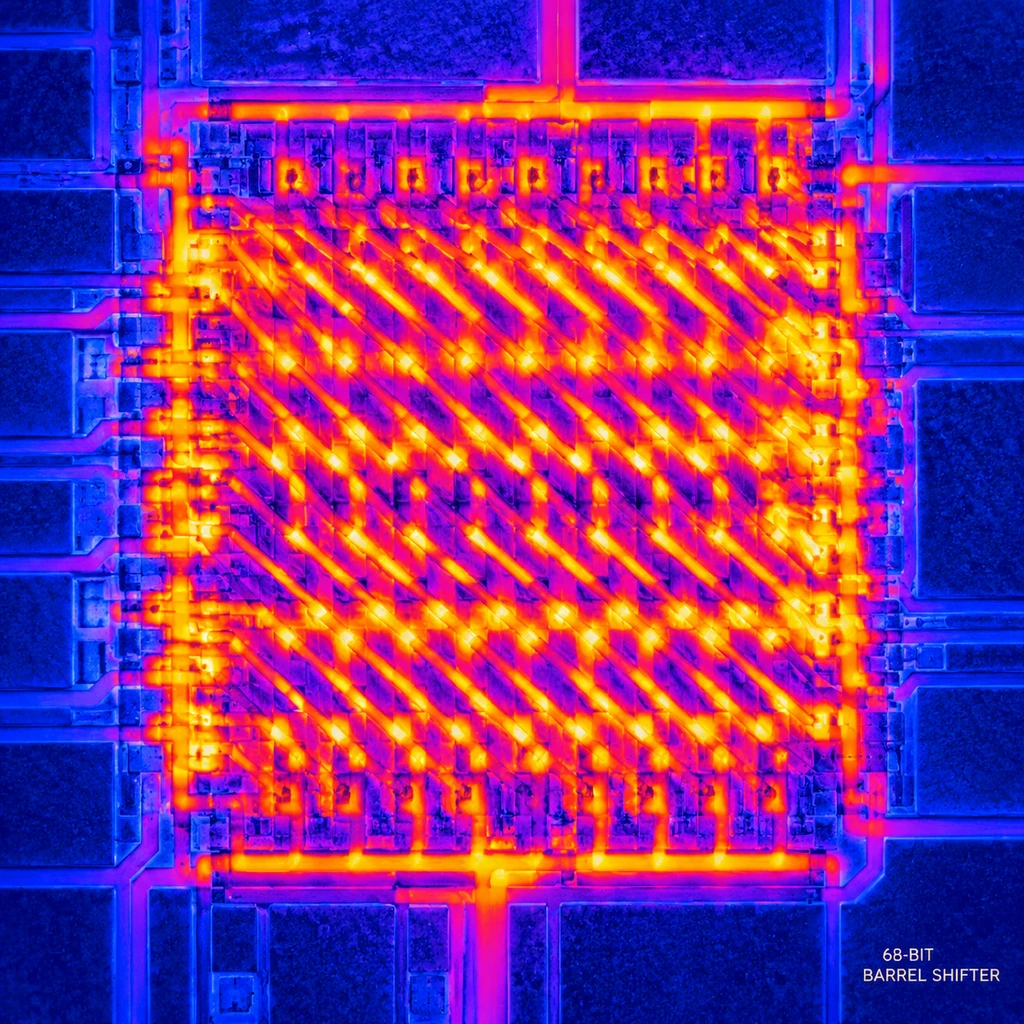
8087 则在硬件内集成了庞大的 68 位桶形移位器与前导零检测电路,能够瞬间把非规格化有效数直接对齐。
决定算力代差的往往不是核心运算单元,而是那些为了对齐数据而消耗的时钟周期。
但在整机实际运行中,由于总线争用、指令预取和内存存取的开销,提速幅度会显著收敛。在 1986 年针对 8MHz 平台进行的单精度 Whetstone 跑分测试中,纯 8086 软件环境得分仅为 2.3 KIPS,搭配 8087 后跃升至 178.0 KIPS,实际应用级提速固定在 77倍 上下。这足以改变当时工程辅助设计(CAD)与科学计算软件在个人电脑上的生存状态。
硬件走在标准前面:未定稿协议的工程妥协
现代计算机专业学生大多熟知奠定浮点计算公理的 IEEE 754 规范,但很少有人意识到,该标准是在 1985 年才正式落笔定稿。1980 年推向市场的 8087,是 Kahan、Coonen 与 Stone 共同提出的 K-C-S 浮点提案的硅片工程载体。换言之,8087 是标准的试验田,而不是标准的对照物。
这种早产性质在微码中留下了鲜明的技术印记。最典型的分歧在于对正负无穷大的处理:正式版 IEEE 754 标准全面采纳了区分正负号的仿射无穷大(Affine Mode)。然而,8087 在硬件默认状态下执行的却是射影模式,即把正无穷大与负无穷大视为同一个无符号极限点,仅在控制寄存器中提供可选的仿射开关。
| 架构维度 | Intel 8087 (1980) | AMD Am9511 (1979) | Motorola MC68881 (1984) |
|---|---|---|---|
| 标准遵循 | 基于 K-C-S 草案实现 | 厂商专用 32 位格式 | 遵循 IEEE 754 最终稿 |
| 有效数位宽 | 64 位(显式最高位 1) | 24 位 | 64 位(符合标准扩展) |
| 无穷大模型 | 默认射影模式,可选仿射 | 不支持特殊值系统 | 完全采用符号仿射模式 |
| 下溢处理 | 硬件支持非正规数微码处理 | 直接冲刷为零 | 硬件规格化与异常陷阱 |
横向对比同时代竞品更能看清 8087 的技术选择。早一年推出的 AMD Am9511 协处理器为压缩芯片面积,彻底放弃了对非正规数(Subnormal Numbers)渐进式下溢的支持,遇到微小数值直接冲刷归零;后发的 Motorola MC68881 则由于赶上了 1985 年的标准收尾期,直接在内存对齐上设计为 96 位布局。
8087 为了在硬件资源逼仄的 4.5 微米工艺下保全数值严谨性,不惜占用大面积硅片集成微码 ROM,以微指令调度处理四种复杂舍入模式与渐进下溢。
- 风险.现代复古计算仿真器若直接将 8087 运算结果与现代 x87 单元划等号,会在未定义行为与极端溢出边界测试中出现难以排查的逻辑偏移。
从 1980 年 8087 内部的 1648 条微指令,到当今大模型训练中针对 FP8、BF16 与专用张量计算单元(TPU/NPU)的微架构探索,计算工程学始终围绕同一命题演进:当通用中央处理器无法承受复杂的专用数学规则时,用微码与定制硬件重构数据通路,永远是最直接的破局路径。