2026年9月21日,Hugging Face 正式公开了 tokenizers v1 的重构报告与首个候选版本(1.0.0-rc.0)。官方拿出的基准数据相当惊人:在 Apple M4 Max 芯片上,Encode 吞吐相比旧版 v0.23 获得了 3x 至 30x 的跃升,Decode 提速 5.4x 至 8.8x。官方高调宣称要终结 CPU 分词拖慢 GPU 的历史,但若是剥开跑分光环细看,这场提速不仅在不同语言之间存在巨大的温差,在超多核生产环境里也远未达到插上即飞的理想状态。
撕掉正则与零分配:底层改了什么
长期以来,分词计算在整条模型推理链条中的耗时并不显眼。但面对百亿级语料预训练与长文本高并发吞吐,CPU 分词逐渐成了卡住 GPU 喂料的瓶颈。面对 tiktoken、gigatoken 等专用极速库的倒逼,Hugging Face 这次选择了推翻重来。
这套新底座最核心的工程动作集中在计算管线的去冗余上:
- 拆解巨石库.将单一 crate 彻底拆分为工作区模块,最小化剥离出的 tk-encode 与 tk-serialize 运行时体积仅约为 332,799 字节。
- 抛弃正则引擎.引入名为 bitcannon 的位流处理模块,通过 CPU 寄存器的 SIMD 指令进行布尔运算,每条指令可直接决断 64 字节,绕开逐字扫描。
- 彻底消灭动态分配.重构 BPE 合并循环,依靠调用方自备的预分配缓冲池与平铺数组内的侵入式双向链表更新索引,杜绝合并过程中的内存申请。
在 Apple M3 Max 的单线程实测中,这套流水线的 Encode 中位吞吐从旧版的 8 MB/s 拔高至 90 MB/s;Decode 吞吐达到 337 MB/s,单 Token 耗时缩短至 11.2 ns/token(旧版需要 78.1 ns/token)。在 GPT-2 英文单文档短文本场景下,p50 延迟直接降到了 2.25 µs,p99 延迟为 5.21 µs。
词缓存的温差:中文吃不到的跑分红利
官方测试覆盖了 10 个模型家族,但性能表现极为分化:GPT-2 拿到了最高的 30 倍提升,T5 却只有约 3 倍。这种剧烈分化的背后,站着一个核心加速支柱——基于线程局部存储的词缓存(WordCache)。
大模型分词是纯粹的确定性映射,只要先验分词切出的片段相同,产生的 Token ID 永远一致。v1 会把已见片段直接缓存进内存,遇到重复词时跳过耗时的合并计算。这造就了一个对不同语种极不公平的加速机制:
真实语料统计显示,英文的词频复发率约为 8.3x,而中文仅为 1.31x。
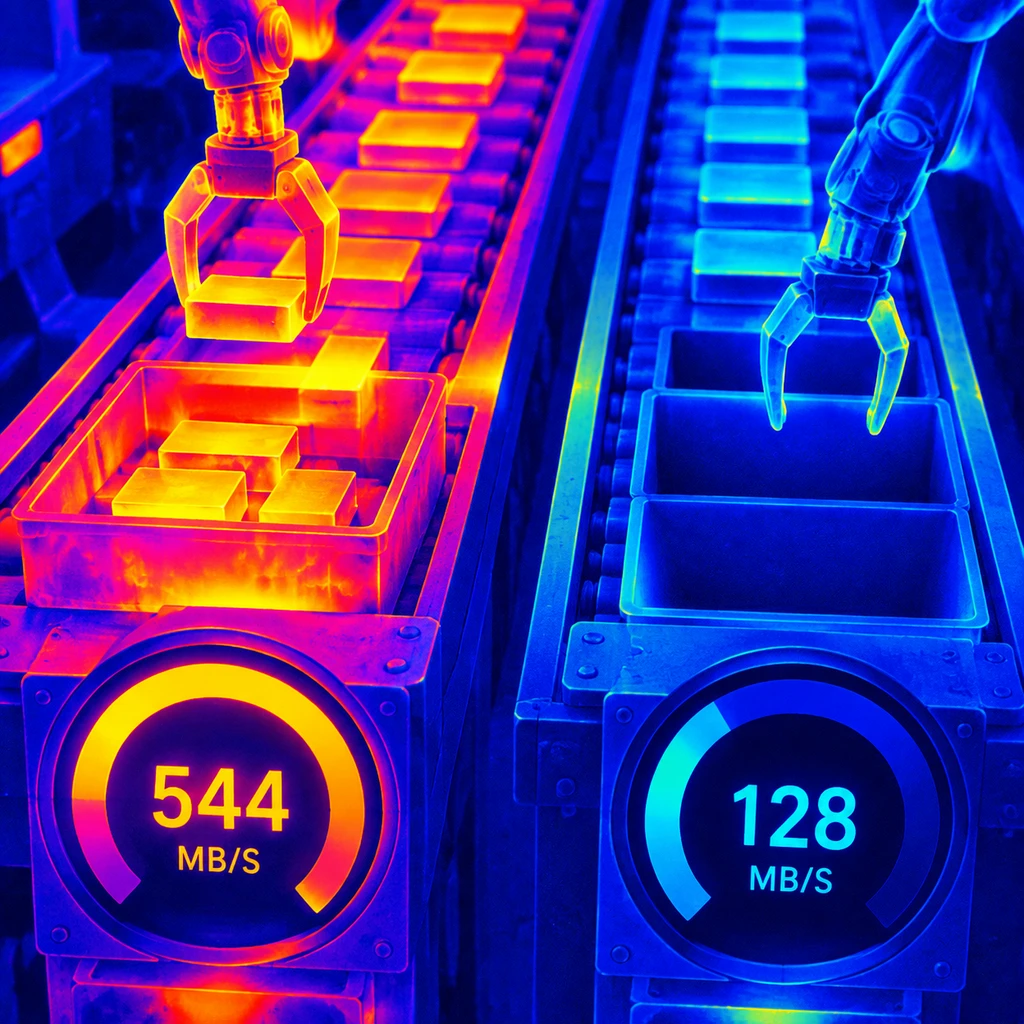
在 GPT-2 词缓存基准测试中,高复发场景下专用引擎 gigatoken 冲到了 764 MB/s,tokenizers v1 也跑出了 544 MB/s;但一旦切到低复发语料,gigatoken 跌至 161 MB/s,v1 更是回落到 128 MB/s。依赖空格分词的西欧语言可以凭借大量的高频词把缓存打满,而缺乏天然空格、分词颗粒度更细碎的中文语料,大多时候只能承担查表落空的损耗。
在解码侧,专用引擎的压制同样存在。单线程 Decode 横评中,专用引擎 tokie 跑出了 379 MB/s(9.4 ns/token),依然压过 tokenizers v1 的 337 MB/s 以及 tiktoken 的 257 MB/s。
生产并发的暗礁与 GPU 空窗
官方文档强调,v1 依靠每个线程的专属缓冲子池消除了单锁排队,并在 8 核 M4 Max 上测出了相当于理想线性扩展 76% 的并发效率。但在真实的云原生高核环境里,这个原生多线程机制遇到了明显的物理边界。
在 120 核 Kubernetes 容器的压测中,默认的单一共享分词器在高并发与非均匀负载下,依然会撞上严重的锁竞争与 CPU 缓存局部性损耗。工程团队在此类集群中进行实际部署时,必须把架构退回至手动分片实例(sharded instances),才将处理吞吐拉升了 7–9x。
- 提醒.在超多核心的推理容器中,不要直接依赖单一全局分词器实例;依照计算拓扑进行进程或实例分片,才能规避高并发下的吞吐折损。
另一个悬而未决的问题是 GPU 分词。官方用 GPU 饥饿作为改写核心诉求,但在当前的 1.0.0-rc.0 中,GPU 侧的编码与批处理解码、跨语言绑定(C++/Java/Go)以及统一训练 API 都还在路线图上,并未完工交付。更现实的阻碍在于,短文本高频交互下,跨设备的显存搬运与内核启动开销,往往会让纯 GPU 分词得不偿失。
等价兼容保住了生态江山,但极致的吞吐王冠注定属于专用引擎。
社区曾针对特定模型(例如 CLIP)构建出单输入比 Hugging Face 快 40 倍、批处理快 11 倍的极端专用分词器,但官方明确将其列为不会实现的需求。因为 Hugging Face 必须死守一条底线:同时覆盖 BPE、WordPiece 与 Unigram 三大家族,且必须保证输出的 Token ID 与旧版毫无偏差。
古人讲求木之长者必固其根本。对于支撑数十万个开源权重的 Hugging Face 来说,通用性与结果的绝对等价就是它最坚固的生态护城河。换来兼容代价的,是它永远无法像 gigatoken 那些单点极致库一样轻装上阵。v1 确实交出了一份惊艳的工程底座重写答卷,但要在产线上真正榨干每一滴算力,依然需要开发者看清语种特性与并发拓扑的真实边界。