科技博客 Prinzai 近日公布了一项颇具传奇色彩的实验:利用 OpenAI 刚发布不久的 GPT-6 Astra,成功解密了一则尘封百余年的第一次世界大战德军无线电密电。
这则发自 1918 年 11 月 27 日、长度仅 170 字符的电报,出自 Childs 专著《一战德国军事密码的历史与原理》第 217 页,此前长期躺在德国科普网站全球 50 大未解密码清单中。模型给出的明文显示,内容记录了一艘英国巡洋舰抵达塞瓦斯托波尔港,后续盟军舰队即将跟进的情报。消息传出后,社交网络迅速出现“AI 终结世纪密码”的赞叹。但这究竟是一次惊艳的密码分析学突破,还是一次高级的历史文献交叉索引?
算法复核:这不是大模型的文字幻觉
面对大语言模型给出的精妙长句,第一反应往往是提防幻觉。尤其是德语军事电报这种特定年代的冷门文本,模型极容易凭空捏造一段煞有介事的战地通报。
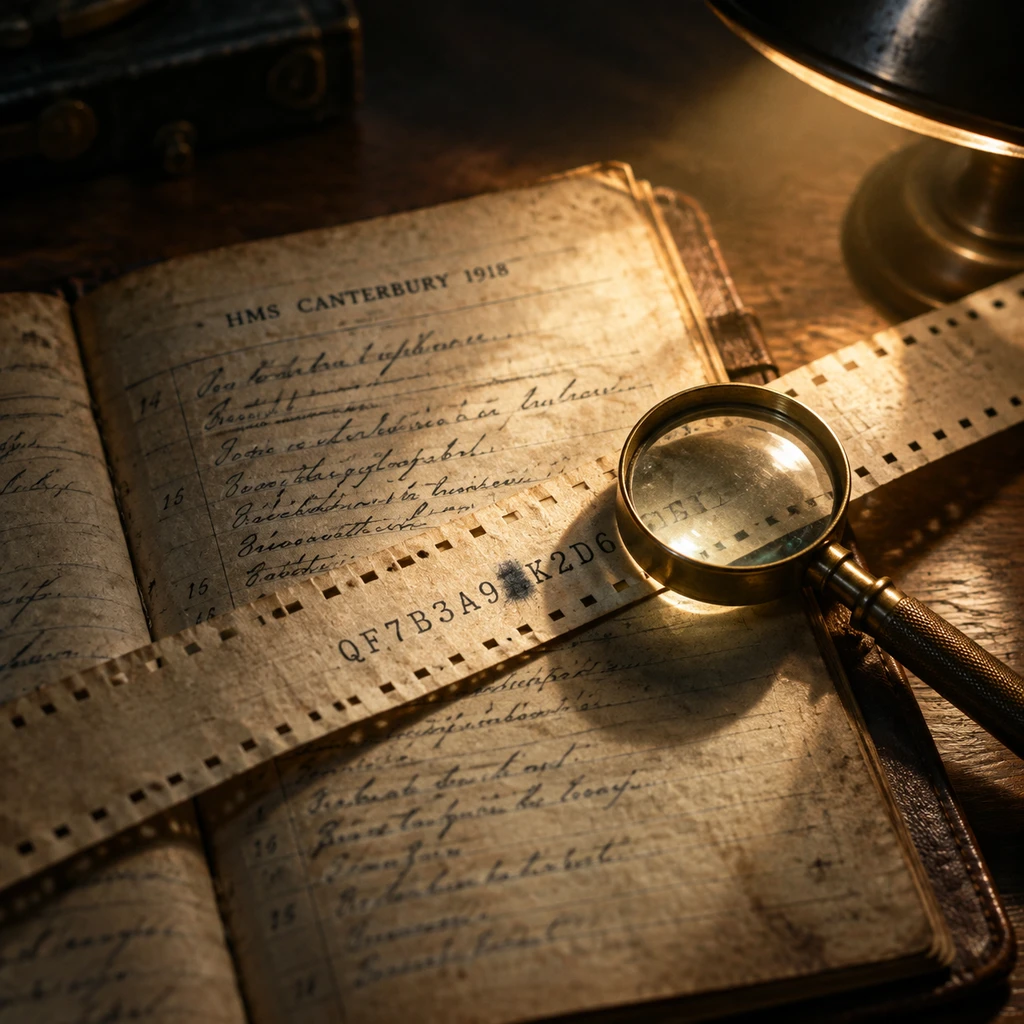
但这一次,数学和算法站得住脚。第三方开源研究者在 GitHub 上迅速公布了独立验证脚本。解密所使用的算法是经典的 ADFGVX 复合密码:先通过 6×6 棋盘将字母转化为双字符坐标,再按照特定密钥词重排字母顺序,进行单次或多次列移位。
验证证实,只要将 Childs 专著第 214-215 页记载的 19 字母置换密钥“TRUPPENVERSCHIEBUNG”依字母序重新编号,把 170 个字符按 19 列写入网格,严格逆向运行列移位算法,确实会精准掉落出那串德语文段。这意味着排除了一般 LLM 凭空补全胡说的可能,其底层算法还原严丝合缝。
然而,明文本身带着粗糙的毛刺。解密出的句子写着 EIN ENGLISCHER KREUZER EINLIEG X SEWASTOPOL X S4STEN X,不仅“EINLIEG”拼写极不规范,日期部分更出现了模糊字符“S4STEN”。这一处数字在原始扫描件中污损难辨,原作者与模型是通过翻查英国皇家海军 HMS Canterbury 巡洋舰在 1918 年 11 月 24 日抵达塞瓦斯托波尔的真实航海日志,倒推拟合出这个数字应为 24 日。
概念除魅:档案重配而非密码学攻破
把这起事件定性为“AI 攻破百年不可破解的复杂密码”,在学术上并不严谨。
密码学分析(Cryptanalysis)的核心,是在缺乏密钥的情况下,仅凭密文与统计学漏洞逆推密钥或算法结构。一战后期德军在东线留下的 668 份 ADFGVX 电报中,密码学家 George Lasry 等人早已破译了其中的 618 份。剩下的残存密文中,有 14 份长度正常却无法用已知密钥还原,学者普遍推断是战地前线在操作转写时出现了错漏,或归档信息发生了错配。
GPT-6 Astra 做的事情,并不是从数学层面强行撕开 ADFGVX 算法的口子,而是完成了一次精彩的“文献拼图”。在 Childs 的原著中,“TRUPPENVERSCHIEBUNG”被白纸黑字记载为 1918 年 12 月 9 日启用的密钥。以往的解密者默认按日期索骥,从未将 12 月的钥匙插进 11 月 27 日的锁孔里。
模型跨过了这道人为的时间鸿沟,把同书中记录的邻近密钥借来一试,锁芯应声而转。这说明百年前的德军机要员要么提前使用了新密钥,要么在战乱撤退中写错了发报日期。
- 结论.大模型在此展现的不是超凡的密码攻防算力,而是跨越孤立文献、模糊容错检索并执行机械计算的能力。
黑盒背后的审慎与疑点
在这场解密狂欢中,有几个关键事实必须厘清。
OpenAI 于 2026 年 9 月 3 日发布 GPT-6 Astra,上下文窗口达 1,050,000 tokens,最大输出达 128,000 tokens,API 定价为输入 10 美元/百万 token、输出 50 美元/百万 token。官方宣称其在 FrontierMath Tier 4 评测中达到 98%,ARC-AGI-3 达到 99.9%,ExploitBench 达到 100%,并将其定为触及“严重级网络安全能力阈值”。但在其庞大的官方公告与 System Card 中,根本没有提及一战德军密码,这并非官方背书的 Benchmark 战果。
真正决定判断成色的是全过程日志,而非只看解开之后的结果。
原博客至今没有公开完整的 Prompt 交互记录与代码解释器调用日志。外界无从知晓,究竟是 Astra 在无人工干预下通读全书、自主推论出“密钥可能提前使用”,还是人类提示者在对话中圈定了 Childs 专著的候选列表,甚至直接授意模型“拿第 214 页的单词逐个尝试这几段密文”。
更重要的是,截至 2026 年 9 月 19 日,George Lasry 等顶尖历史密码学者或权威档案馆尚未对此发表同行评议。现有的一切推导均基于博客作者翻拍的电子件,尚未经由专业学者对照 Childs 专著实体纸本或微缩胶卷进行版本源流复核。
- 风险.借助外部军舰航海日志反向拟合模糊字符,固然符合历史逻辑,但在密码学与严谨史学考据中,只要缺乏原件对勘与独立信源佐证,就依然只能作为高概率假说,而非盖棺定论。
古人讲“按图索骥,始得其半”。大语言模型手握百万级别的上下文与跨模态记忆,正在变成极其高效的历史数字档案员,能把前人因时间错位、归档疏忽而遗漏的蛛丝马迹串联成线。但剥离掉夸张的公关话术与自媒体滤镜,这依然是一场漂亮的文献交叉查证,而不是机器凌驾于密码学规律之上的神迹。