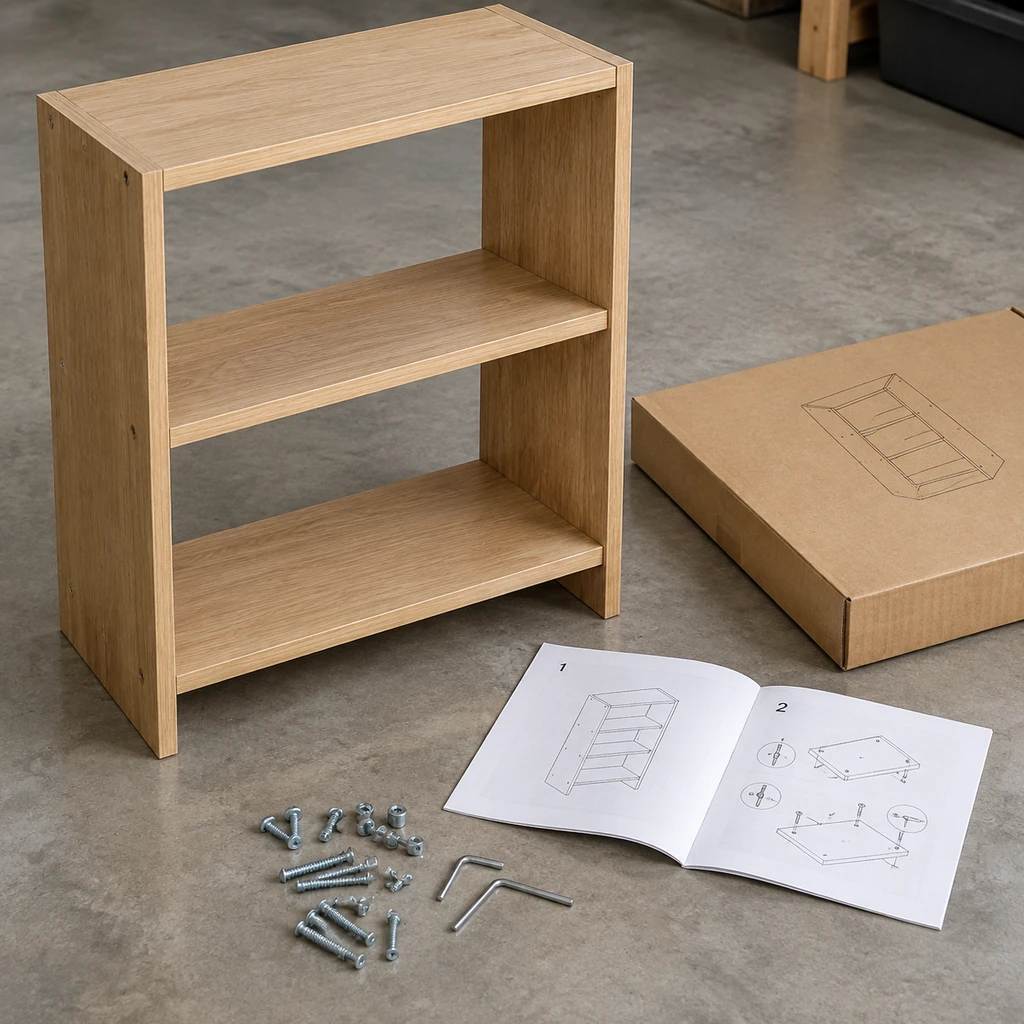
大模型正试图证明自己看懂了现实世界的螺丝与木板。研究机构 Epoch AI 在 2026 年 9 月 23 日发布家具组装基准测试(Furniture Assembly Benchmark,简称 FAB),测试大模型通过对比宜家官方说明书与实物照片诊断组装错误的能力。在 2025 年 11 月基线模型 Claude Opus 4.5 仅取得 28% 准确率的前提下,OpenAI 的 GPT-6 Astra 在最新测试中拿下了 80% 的排错准确率。
但这场被外界视作多模态大模型攻克物理世界的飞跃,目前更像是一场高度特化的案头推演。这项测试并非 OpenAI 官方发布的技术成果,其官方页面甚至完全没有提及 FAB 基准与这组跑分;它既不是由模型肉眼直觉给出的判断,更不代表 AI 已经具备走进千家万户指导组装家具的工程实用性。
六十张照片的微型考场与外挂沙盒
拆解这项测试的数据底座,会发现它的实际样本量小得惊人。整个 FAB 测试集只涵盖了 3 款宜家家具在组装过程中拍摄的 60 张照片:包括 STÄLL 鞋柜 14 张、TONSTAD 床架 25 张,以及 GULLABERG 梳妆台 21 张。所有错装环节均由测试人员人工摆拍预设,样本量过小导致其二项分布标准误差达到约 5.2 个百分点,粗略估算的 95% 置信区间波动达到正负 10 个百分点。
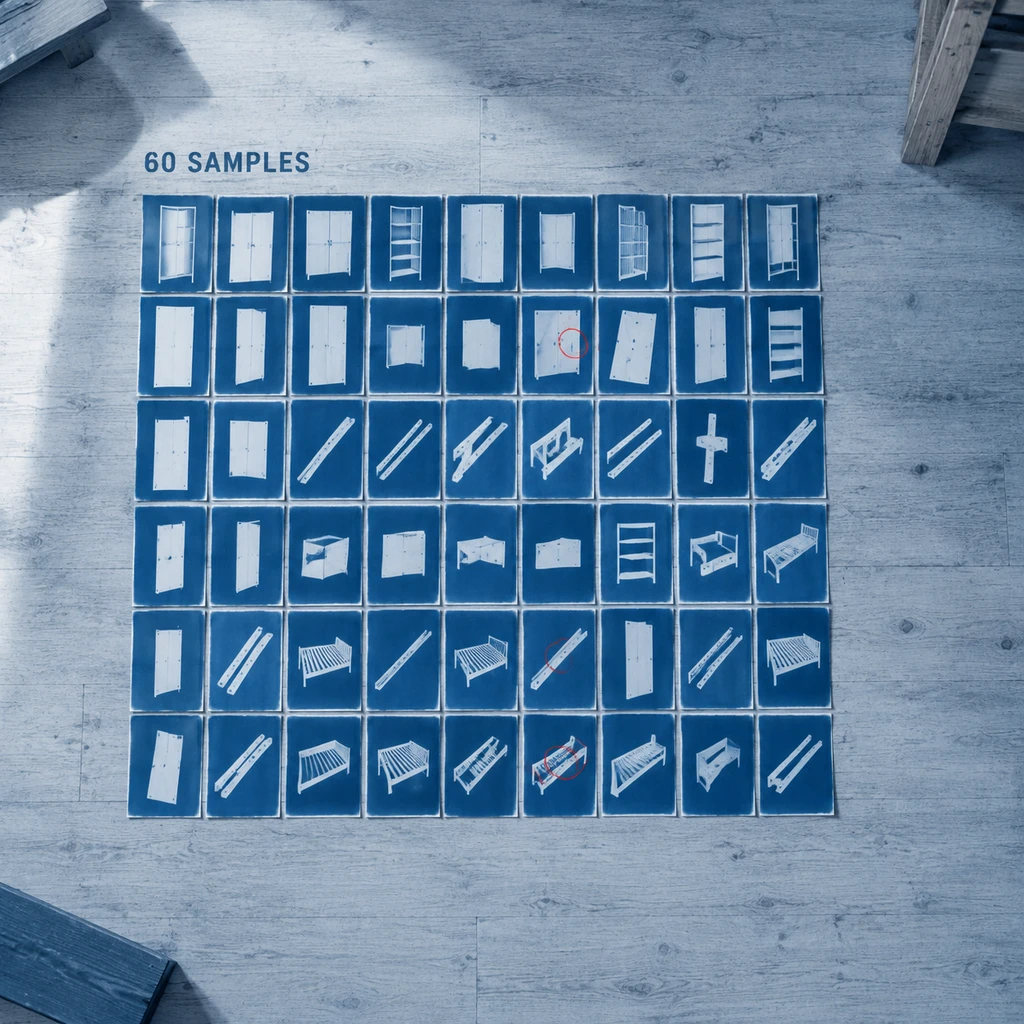
更为关键的是测试环境的规则设计。受测模型并非单凭眼睛直接给答案,而是置身于一个完备的 Agent 沙盒系统内。系统给模型配发了图像缩放工具以及 Python 解释器,并允许它们调用高达 80 步的动作步数预算。在实测中,只有低于 5% 的样本用尽了步数上限,模型通过反复切片放大零件细节、编写脚本验算孔位距离来排查疑点。
最终结果也并未经过人工逐项核验,而是交由另一款大模型 GPT-5.6 Sol 担任裁判,并且采用了刻意放宽的裁决标准。由于宜家图纸与家具照片受制于商业版权,Epoch AI 并未开源这批底层测试图像与数据,导致学术界要完全独立复现该成绩存在相当高的阻碍。
质检员而非装配工,图纸空间认知拉开断层差距
将这项测试简单等同于 AI 会装家具,是对具身智能的根本误解。FAB 本质上是一套基于 2D 图纸与 2D 静态图像比对的离线质检程序。
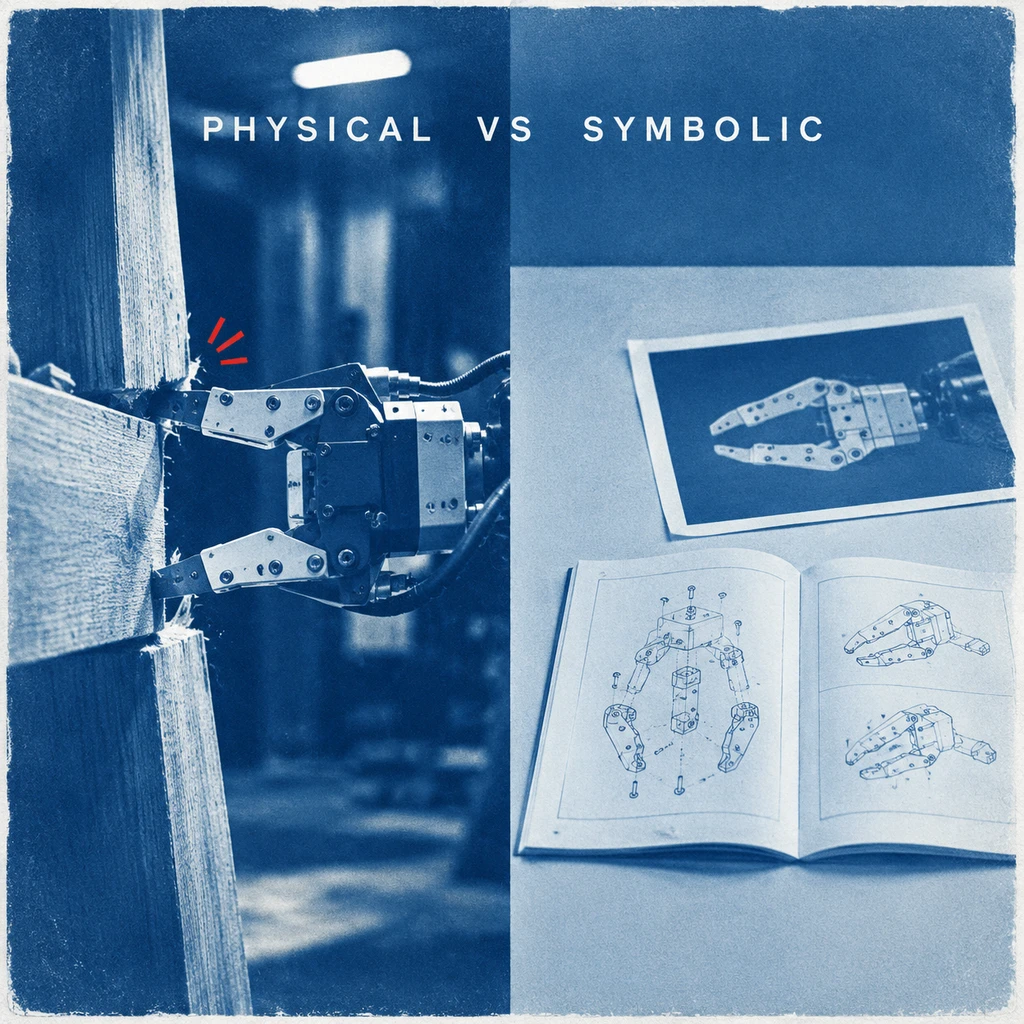
离线看图挑错是符号与几何的推演,真机装配则是力觉、遮挡与重力的试炼。
真实的物理装配如同 FurnitureBench 等具身基准所测验的那样,要求机械臂面对零件遮挡、执行力矩反馈以及动作失败后的物理回滚。FAB 测试完全避开了这些物理世界的混沌变量,它测出的是模型在高阶工具辅助下,把平面图纸装配时序映射到静态照片上的视觉几何推理能力。
在这条细分赛道上,全球模型梯队展现出不小分化。Anthropic 的 Claude Fable 5.1 以 70% 的准确率紧随其后,Claude Opus 5 达到 61%。以 Kimi K3 为代表的中国开源权重模型拿到了 34% 的得分,虽然超越了去年底 28% 的行业基线,但在这一维度上落后前沿梯队至少 7 个月。
这一差距显著大于中国模型在 Epoch 综合能力指数上约 4.4 个月的滞后周期。这种非对称落后表明,国内开源模型在常规语言理解、代码生成等领域追赶迅速,但一旦切入多模态图纸逆向解析、空间部件定位以及长流程工具链排查时,底层推理能力的断层便被成倍放大。
三分钟延迟背后的现实代价
抛开跑分光环,技术落地的瓶颈直接卡在响应延迟上。GPT-6 Astra 在完成单张照片的排错分析时,中位数耗时约为 3 分钟。尽管这已经是所有受测模型中最快的运转速度,但对于面对散落一地板材、急需得到装配指导的真实用户而言,单步 3 分钟的等待彻底粉碎了实时交互的可能。
- 提醒.离线质检的高跑分建立在工具链堆叠与长推理耗时之上,若无视频流实时推理与人类基线比对,此类系统短期内无法作为装配助手或工业急修工具使用。
这项测试甚至还没有测定人类普通用户的对照基准线。未经训练的普通人对照说明书排查这 60 张照片能拿多少分,目前仍处于空白。把 80% 的准确率包装成超越人类的手工救星,在严谨的技术评估面前站不住脚。
空间推理确实是大模型从纯文本茧房走向物理现实的必经阶梯。未来无论切入汽车发动机维保、精密仪器检修,还是为具身机械臂提供高层动作规划,理解空间拓扑都是前置条件。但从 60 张照片的静态比对,跨越到连续视频流的无死角动态指引,模型开发者需要跨越的不仅是算力与时间延迟,还有摆脱外挂脚本辅助、直面物理世界真实杂乱的深层泛化能力。