2026年9月29日,Google Cloud AI Research 联合斯坦福大学、北卡罗来纳大学教堂山分校以及圣路易斯华盛顿大学,正式开源了名为 RRSI 的自演化研究框架。这项采用 Apache 2.0 协议发布的工作,允许开发者在完全冻结底层大模型权重的前提下,让智能体自主编写和修改自身外围的全部脚手架,包括提示词、外接工具、记忆检索模块、控制流以及派生的子智能体。
表面上看,这又是一次让软件自己写软件的实验,但团队交出的一组对照数据打破了跑分神话:在评测演化集上,RRSI 并没有像同类系统那样刷新峰值,反而主动放跑了分数;而在完全未见过的真实业务基准上,它却大幅反超所有对手。它解决的不是代码能不能自我修改,而是智能体自主重写代码时必然陷入的基准过拟合与复杂度恶性膨胀。
本地跑分故意放水,未见基准拿下43.6分
在智能体开发领域,自动化搜索工作流早已成为技术前沿。从早期仅优化提示词的 MIPROv2 和基于反思反馈的 GEPA,演进到覆盖控制流与子智能体的 Meta-Harness、AHE 与 HarnessX,系统演化的权限放得越来越宽。然而,给予智能体修改自身代码的完全自由,往往会直接导向作弊式收敛。搜索算法会迅速记住训练集里的特定任务名、特定实体和评估用例,追逐评测中的微小随机噪声,并通过堆叠大量冗余逻辑和海量 Token 来换取表面上的分数提升。
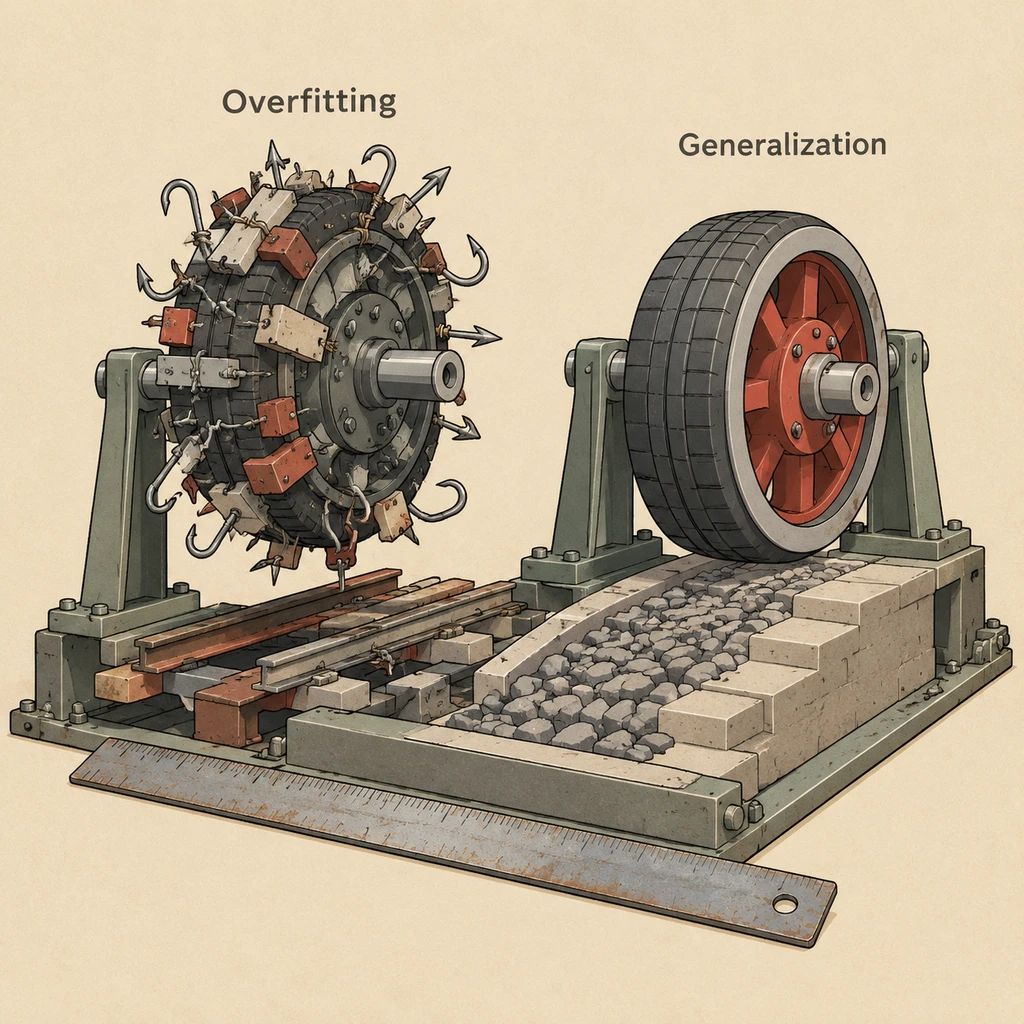
Harvey LAB 的对比评测直接暴露了这一行业隐疾。在完全相同的初始脚手架 H0、相同策略模型与相同搜索预算下,Meta-Harness 凭借完整的历史代码、评分记录与执行轨迹文件系统,在本地演化集拿到了 93.0 的惊人高分,而 RRSI 的演化集得分仅为 90.5。
当把演化后的脚手架直接搬到没有参与过搜索的分布外测试集时,剧情彻底反转。未演化基线 H0 在由 JobBench、GDPval 和 APEX-Agents 构成的 OOD 评测中均值为 39.7(三项各自为 36.0、48.8 与 34.2)。Meta-Harness 此时跌落至 40.6,较基线仅微涨不到 1 分。而演化期低了 2.5 分的 RRSI,在跨域测试中交出了 43.6 的均值,其中 JobBench 录得 40.7、GDPval 拿下 52.3、APEX-Agents 达到 37.9。
演化集拿第一名,恰恰成了泛化失效的危险信号。RRSI 展现出的克制证明了一件事:在离散的代码自我改进中,不加约束的自由只会让模型在已知环境里投机取巧。
将L0/L1/L2数学思想装进工作流搜索
为了压制过拟合,RRSI 并没有缩小智能体可修改的代码边界,而是借鉴经典机器学习的正则化思路,为代码修改的提案和准入两端分别设立了防火墙。
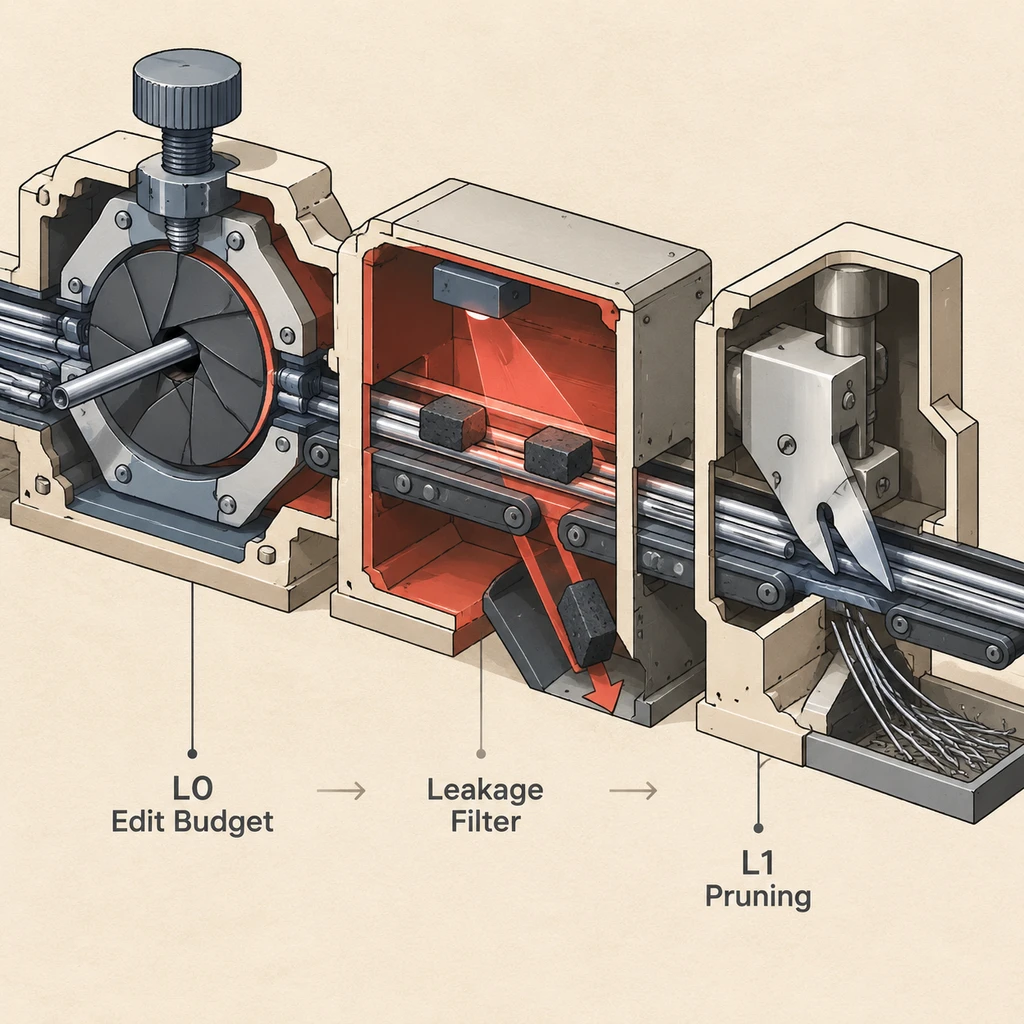
在提案端,系统引入了余弦退火编辑预算。这对应于经典正则化中的 L0 范数。早期的搜索轮次允许智能体打包组合 5 处甚至更多修改,用于快速建立复杂协作机制;但随着迭代推进,配额逐步收紧,最后阶段强制每次只允许变动 1 处代码,确保任何细微改动的因果效应可被精准归因。同时,带有证据感知的变更账本会记录下每一次试验的假设、代码补丁、得分变动与成本变化,智能体在提交新方案前必须审阅账本,彻底阻断了反复尝试已证伪策略的盲目搜索。
在选择端,规则更为严苛。修改案在进入测试集运行前,必须先经过泄漏审查器的过滤,任何包含测试集特定任务名称、实体或基准逻辑的代码补丁都会被直接驳回。随后,修改案必须跨过由原始基线多次运行测得的噪声带,确保得分增益真正来源于能力改善,而非随机波动。
更为关键的是增益成本法则。该法则将 Token 开销映射为 Ridge (L2) 惩罚项,要求相对 Token 增幅满足 ΔC ≤ β0 + β1·ΔS,即增加的计算成本必须由明确的性能收益来买单。最后,系统还会像 Lasso (L1) 那样执行剪枝,定期删除那些不再贡献增益的旧构件,防止工作流不断膨胀为难堪重负的庞然大物。
给智能体放开重写代码的权限并不难,难的是用严密的规则阻止它投机取巧。
消融实验验证了这套组合拳的必要性。当研究人员拿掉所有正则化约束,自演化系统在本地跑出了 92.8 分,但未见基准均值迅速降到 40.3;若仅移除提案端约束,跨域得分降至 41.9;若仅移除选择端约束,跨域得分则跌至 41.0。任何一端的松动,都会导致系统重回过拟合的老路。
单次演化消耗2.42M Token,算力账本依然昂贵
尽管正则化为泛化能力提供了保障,但代码自我进化的计算账单依然沉重。在实验工作空间中,RRSI 单次试验消耗 2.42M 策略 Token。
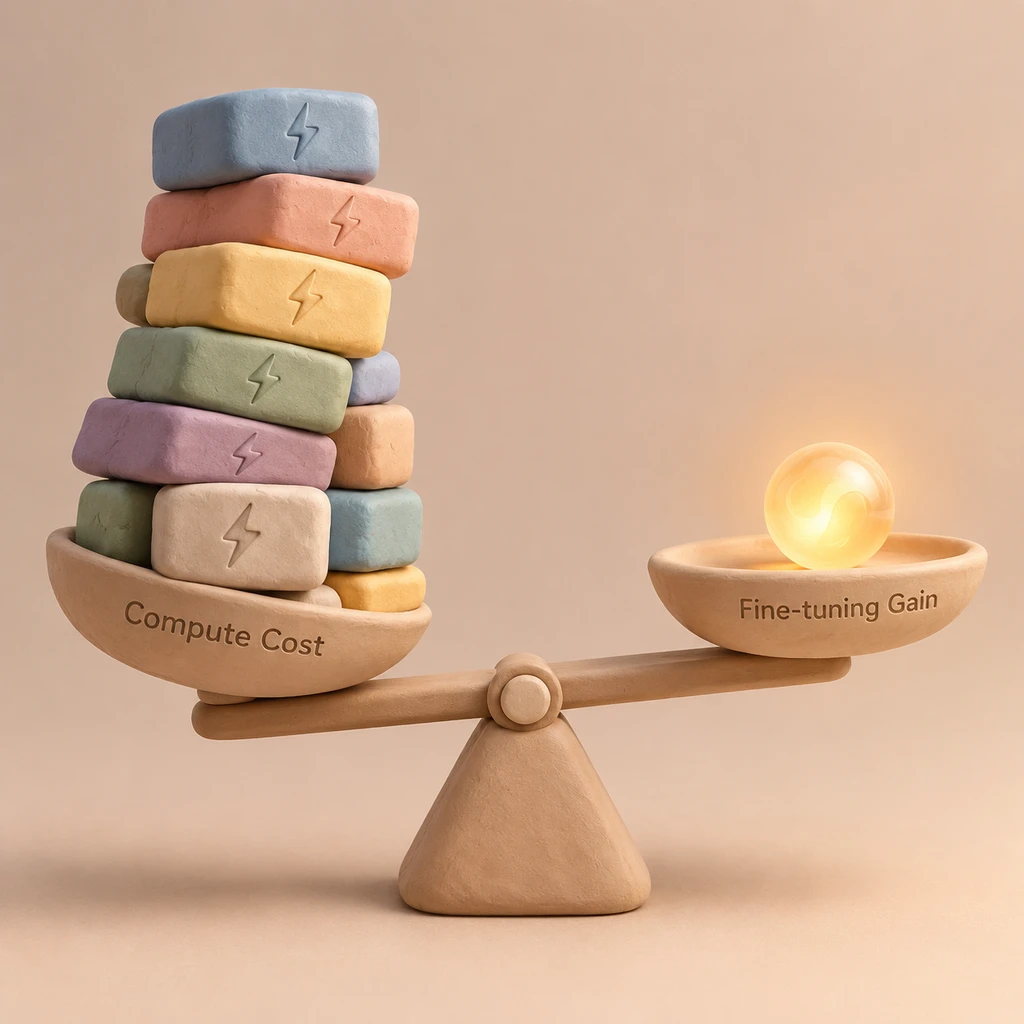
无正则化演化在自由扩张的死循环中,单次试验会狂吞 3.80M Token。相比之下,RRSI 的 Token 消耗降低了约 36%(尽管论文摘要中给出的口径为 30%)。然而,相比未演化的原始基线 H0 单次 1.56M Token 的开销,RRSI 依然多出了约 55% 的计算支出。这种进化的代价不可忽视:要在数个演化轮次中筛选出合格的脚手架,算力消耗会以指数级扩散。
在不同模型能力下的横向适配,展示了这套工程范式的上限与下限。RRSI 默认配置面向 Vertex AI 上的 Claude Opus 4.8 运行,而在换用轻量级的 Gemini 3.5 Flash 作为底层策略模型时,整套自演化流水线同样展现出了拉升效果:Terminal-Bench 2.1 的任务成功率从 64.6% 跃升至 78.7%,在从未参与选择的基准 SWE-bench Verified 上,成绩也从 76.8% 攀升至 79.0%。
- 提醒.增益成本法则虽然封堵了无意义的 Token 挥霍,但也可能过早扼杀某些早期耗费巨大、短期收益不明显却蕴含长线突破潜力的复杂模块设计。
对于正在构建 Agent 的工程师而言,RRSI 的开源提供了一个清晰的工程风向标。依赖手写提示词和单向工作流构建系统的阶段正在过去,代码外围 Harness 的自我迭代正在成为可能。但评估一个自主系统是否具备实用价值,决定权从来不在本地跑分有多华丽,而在它脱离演化环境后,面对真实未见业务时究竟能守住多少底线。