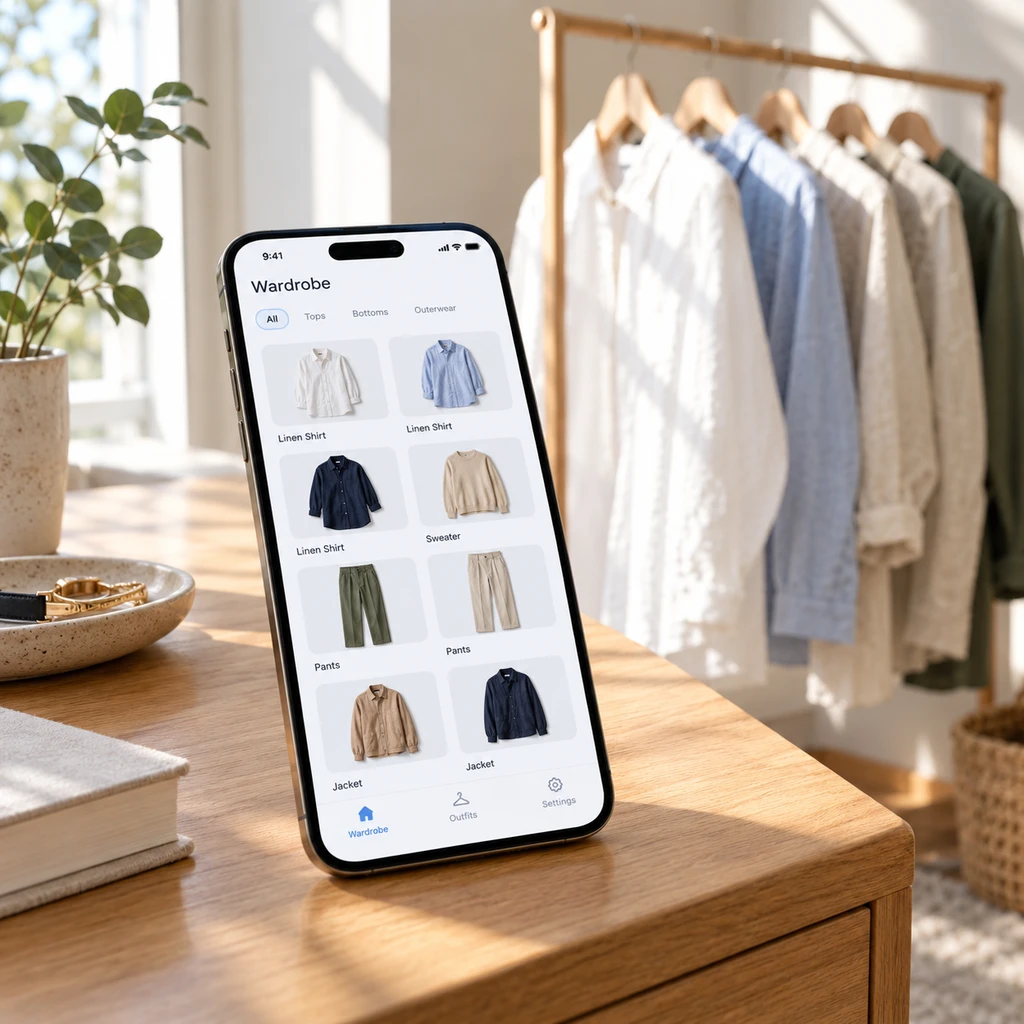
2026年9月24日,Google 宣布其受电影《独领风骚》启发的 AI 虚拟衣橱功能 Google Photos Wardrobe 正式推向美国、巴西和印度的 iOS 与 Android 双端。这项在 4 月 29 日官宣、6 月 2 日率先通过 Android Drop 灰度的实验性生成式 AI 工具,把很多人童年记忆里的数字化试衣镜搬进了真实手机。但剥开九十年代的怀旧滤镜,免除手动拍照摩擦的背后,是向用户索取长达四年相册追溯权与生物特征识别的沉重筹码。
免除录入摩擦的代价,是一张苛刻的准入清单
数字化衣橱赛道长期卡在录入成本上。像 Whering 或 Indyx 这类垂类应用,要求用户把衣服一件件铺平拍照、手动抠图、标记分类,绝大多数普通人在录完前五件外套后就彻底放弃。Google 掏出的方案看似干脆利落:不需要你额外拍照,相册底层算法直接回溯过去约 4 年的历史存量,自动把你在照片里穿过的衣服抠出来归类。
然而免费午餐的入场券极其苛刻。用户必须主动开启人脸分组功能并明确圈定自己的人脸,同时相册里包含本人的照片必须超过 1,000 张。如果日常不爱自拍、相册以风景静物为主,功能入口根本不会开启,唯一的破局方式是花钱订阅 Google AI Pro 或 Ultra 会员。
单次穿搭最多支持 6 件单品组合并生成虚拟试穿。更关键的是,生成的搭配图和试穿渲染结果会直接占用个人存储空间。官方帮助文档对端侧计算只字未提,这意味着从人脸识别、服饰提取到图像合成,全流程高度依赖集中式云端推理。
算法的粗粝与真实衣橱的落差
算法提取的是照片里的残影,不是衣柜里的资产。
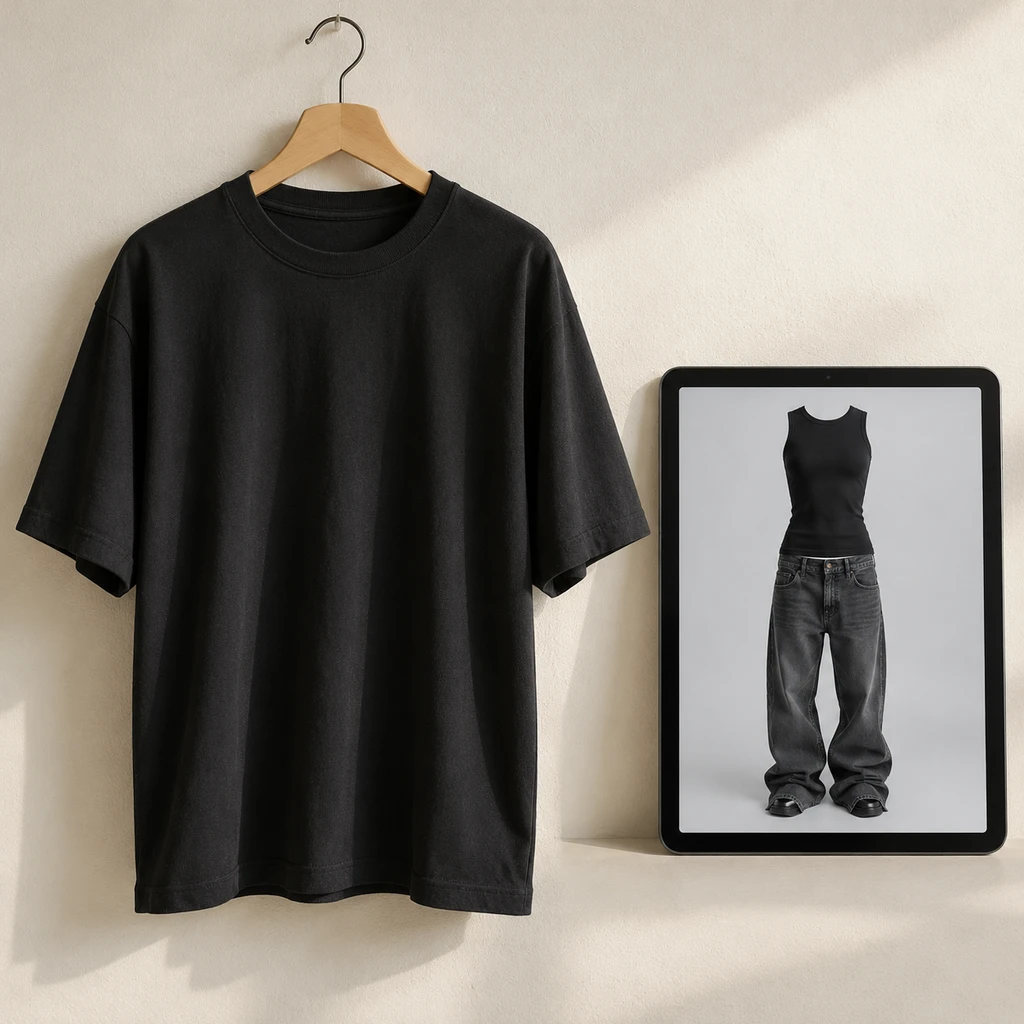
当早期尝鲜者开始使用时,买家秀与宣传片的断层迅速浮现。系统高度依赖构图完整的全身清晰照,一旦光影复杂或角度偏斜,算法识别就会出现严重变形。社区反馈中频频出现把宽松短袖 T 恤误判成运动背心、下半身深色长裤漏识、甚至在生成试穿时随意篡改鞋履绑带细节的现象。
最致命的技术硬伤在于产品不提供手动补录入口,也无法强制要求算法重新扫描。那些被穿坏扔掉、二手转卖或压在箱底的旧衣服,依然会因为历史照片的权重停留在虚拟衣橱里;刚买回家的当季新品如果还没来得及拍照留念,系统里就根本不存在。
这就造成了定位错位。Whering 等垂直工具虽然用起来费劲,但记录了面料、购买价格以及每次穿着的折旧成本。Google 靠四年历史照片拼凑出来的产物,缺少对真实物理世界衣物的盘点能力,充其量只是一份基于过去活动的照片切片索引。
云端画像与订阅变现的终局算盘
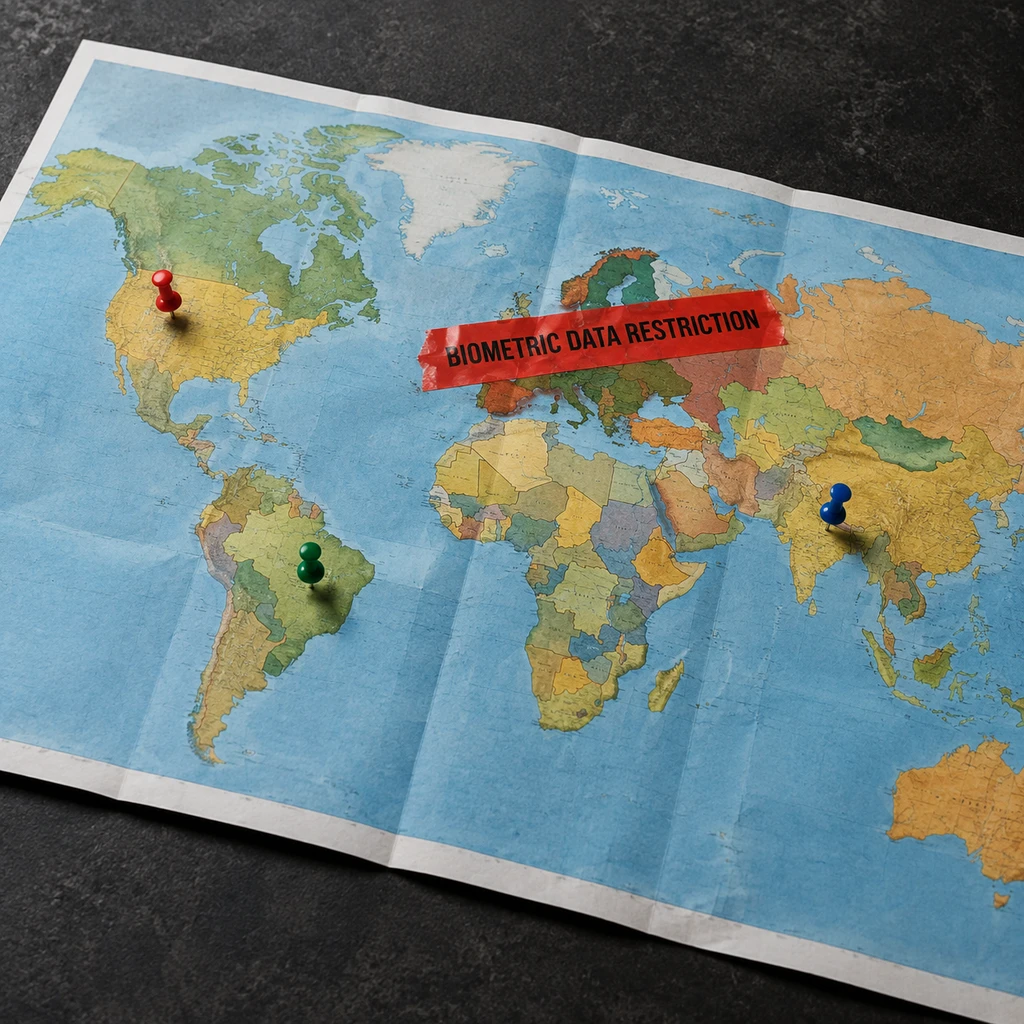
天下熙熙,皆为利来。科技公司很少会为了纯粹的情怀去重构复杂的计算链路。虽然官方政策声明个人相册数据不用于广告投放,也不对外训练外部生成式 AI 模型,但只要用户把相册授权关联至其他第三方服务,相关数据便顺理成章转入对应协议的管辖范围。该功能首发选择美国、巴西与印度,刻意绕开监管严苛的欧盟市场,本身就折射出内部对生物特征隐私审查的忌惮。
如果说过去十多年相册扮演的是被动备份的数字仓库,那么 Wardrobe 则是试图将静态资产盘活为高频生活决策引擎。但每一次单品提取与试穿渲染,都在实质性消耗用户的云端存储配额;一旦 15GB 免费空间见底,或者因为照片数量不足被挡在门外,付费升级便成了唯一顺畅的路径。
- 提醒.如果只是想体验虚拟换装的趣味,可以尝试调取历史搭配;但若期望借此建立严谨的个人胶囊衣橱,目前算法的误识率与补录缺失不仅无法省去收纳精力,反而会交出四年详尽的个人生活轨迹。
世人结交须黄金,黄金不多交不深。免除拍照录入这道门槛看似体贴,但门槛并没有凭空消失,它只是被折算成了四年的面部数据、持续消耗的存储账单,以及向高级会员敞开的收费闸口。