给存在了半个多世纪的快速排序提速十几倍,听上去像教科书被改写的故事。Google 宣布将向量化快速排序算法 VQSort 正式集成入开源 SIMD 库 Highway,论文发表在 arXiv (2205.05982)。官方战报极为扎眼:在 3 GHz 的 Intel Skylake 处理器上,单核吞吐突破 1.12 GB/s,面对 100 万个随机 32 位浮点数,吞吐达到 1135 MB/s,宣称速度是 C++ 编译器自带标量 std::sort 的 9 至 19 倍;即便在没有专用压缩指令的 Apple M1 上,也能跑出 466 至 499 MB/s。
把原本严重依赖主频和分支预测的标量算法塞进向量流水线,确实体现了极深的基础指令控制力。但只要剥开这层令人振奋的性能数字,就会看清这从来不是通用标准库的平替,而是一场严格圈定赛道的特种作战。
硬件指令堆出来的极速
快排历来难以向量化,核心症结在于数据划分。算法必须挑出一个轴点,把小于它的数排在左边,其余排在右边。传统做法由 CPU 逐个比对、来回移动元素,流水线经常因分支预测失败而停顿。
现代处理器给这种计算模式留了专用通道。Intel 的 AVX-512、Arm SVE 以及 RISC-V 矢量扩展都引入了 compress-store 指令。该指令根据一个布尔掩码,直接把符合条件的元素压缩写入连续内存,两趟操作即可完成一次左右划分。
Google 团队的贡献在于工程抽象。他们利用 Highway 库写了大约 3000 行 C++ 代码,通过运行时指令检测,在缺少该指令的 AVX2 或 Arm NEON 上使用置换指令模拟,小数组基底递归则交由特定排序网络接管。这让 AVX2 跑到了 798 MB/s,高出先前专属优化的 699 MB/s 纪录。这套架构证明了跨平台性能抽象行得通,但这套漂亮数字的参照物大有讲究。
战报之外的基准幻象
官方强调的约 10 至 19 倍跨度,对照组选的是 2022 年 LLVM 标量 std::sort,其吞吐仅为 60 MB/s。
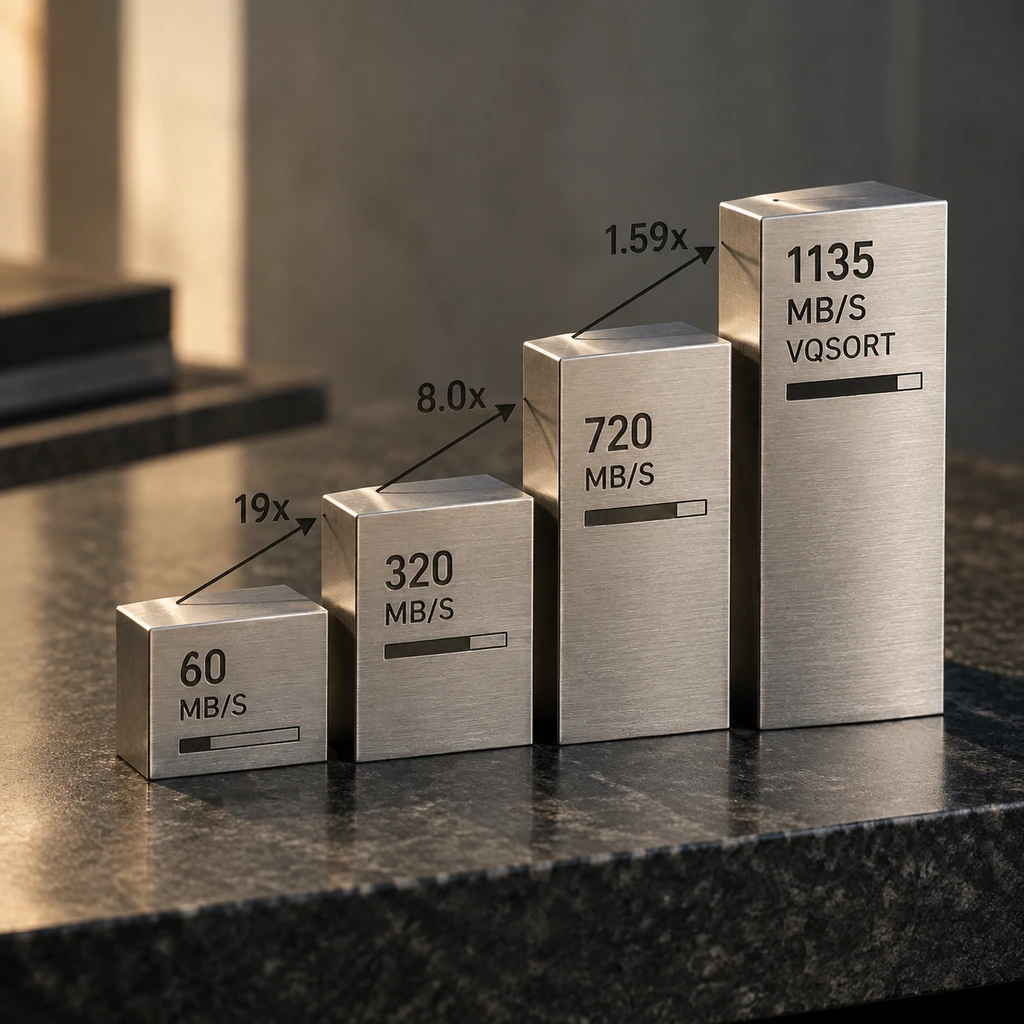
工业界早已清楚旧版标准快排并非标量巅峰。后来被广泛采纳的模式敏感排序 pdqsort,吞吐往往是老旧 std::sort 的 两倍左右。面对未经向量化专门优化的老代码,巨大倍数自然手到擒来;但若换作当时先进的工程排序算法 IPS4o(单核 142 MB/s),VQSort 的单核优势就从 19 倍降到了 8.0 倍。
到了真实的多核并发环境,单核优势还会进一步折损。论文测试显示,在 16 线程处理 1 亿元素的场景下,即使拿 IPS4o 与 VQSort 强强联手(在切分到约 8192 个元素时转入 VQSort 处理),最终实现的几何平均加速比也收窄到了 1.59 倍。
工业系统眼中的三道暗礁
只要离开实验室里构造的平整大数组,工业落地的代价就会浮出水面。
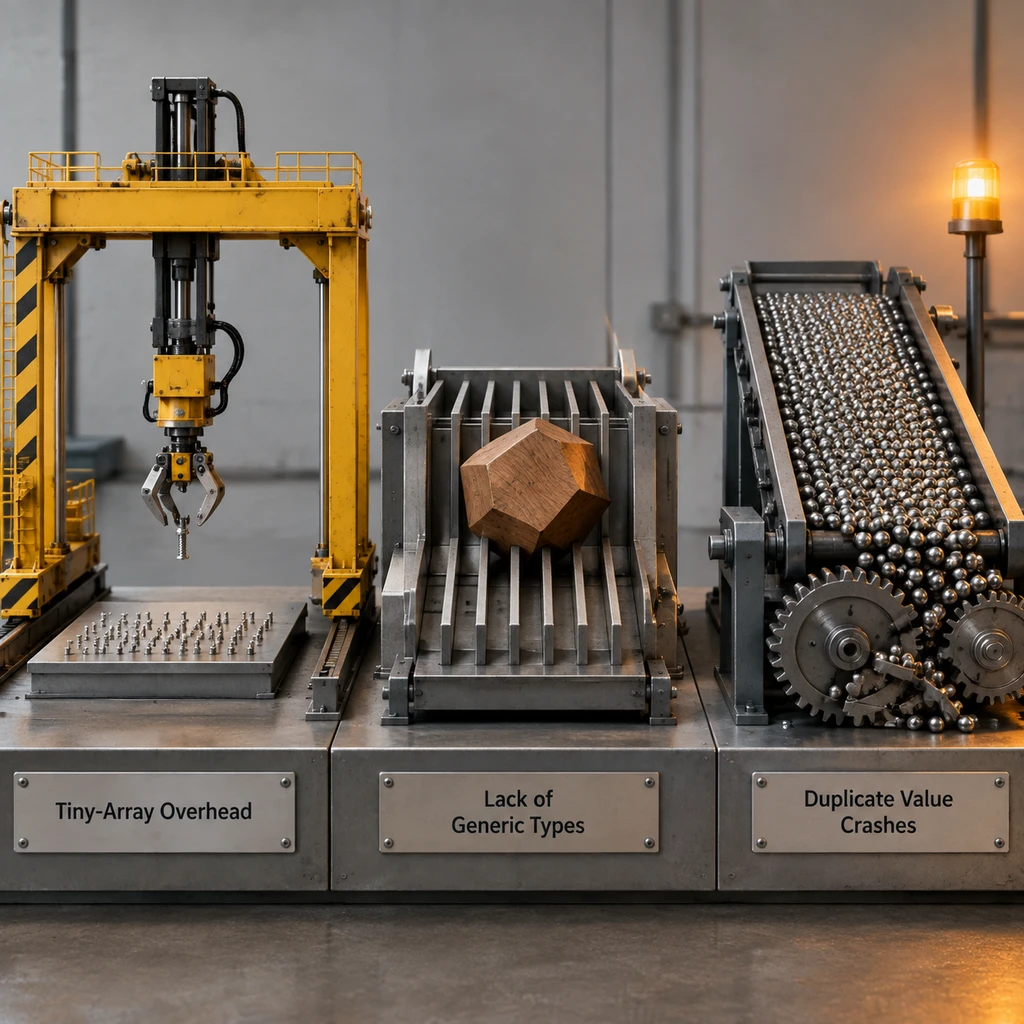
第一个暗礁是小数组性能雪崩。在微服务通信、高频交易或内存分配逻辑中,大部分排序任务所处理的序列长度 N 不超过 20。官方仓库文档直接警告,建议只在数据量大于约 100 KiB 时才调用它。在极短数组下,指令预热、动态分发和排序网络的初始化开销,会让它的耗时远超朴素标量代码。
第二个暗礁是泛型能力的缺失。它目前仅覆盖 16 到 128 位纯数值,无法处理 8 位字符,也不接受自定义比较结构体,而且是非稳定排序。第三方将其封装到 Python 与 NumPy 测试时,64 位浮点数吞吐甚至落后于原生 NumPy,降到标量的 0.8 倍,遇到 16 位浮点数则直接抛异常中止。
更要害的是边界鲁棒性。GitHub 上的 Issue #2281 披露,在 Arm NEON 环境下处理包含海量重复值(例如连续 128 的三次方个双精度浮点)时,其划分逻辑会偶发崩溃。
尺有所短,寸有所长;拿特种兵器打平原战,往往得不偿失。
列式数据库引擎 ClickHouse 社区在探讨该算法时态度相当冷静(Issue #46348)。在成熟的数据仓库中,面对大规模数值列,工业界通常直接使用高度成熟的基数排序(Radix Sort)或多路归并,对 std::sort 提速 10 倍的指标并不能直接转化为数据库流水线的净收益。
- 风险.切忌将 VQSort 误作为通用代码库的替代品,在不可控的数据长度、复杂结构体或高并发微型排序中调用,分发惩罚与类型缺口会迅速抹平硬件收益。
专属赛道的锋利解剖刀
不能把 VQSort 看成普适的标准库救星。工欲善其事,必先利其器,它的生态位非常清晰:在内存充裕的 OLAP 分析型数据库大列批处理、或者科学计算海量浮点过滤中,担当大块连续内存的清洗工具。
它证明了在现代硬件的向量单元里,算法工程师依然能榨出惊人的指令红利。但软件工程从没有免费午餐,在把单核吞吐推过 1 GB/s 的同时,它交出的筹码是通用性、启动延迟与对极端输入的容忍度。对于绝大多数日常业务开发而言,老老实实用好现代标量快排,远比追逐这 10 倍的硬件虚火更为稳妥。