拿过奥斯卡科技成果奖、拥有以自己名字命名的两颗小行星,同时把 SMO 算法写进每本机器学习教科书的 Google Fellow John Platt,最近把团队十余年的科学计算工程搬上了舞台。2026 年 5 月 19 日,《Nature》正式刊载了 Google 团队的重磅论文《An AI system to help scientists write expert-level empirical software》,核心主角是一个名为 ERA(Empirical Research Assistance)的科学研究系统。
这个系统的核心构想十分明确,即抛弃让大语言模型自主提出宏大科学假设的幻想,将前沿科学探索直接转化为可打分任务。科学家负责框定目标函数与数据沙盒,ERA 负责在沙盒里持续迭代经验代码。
降维打击:从科学探索到可打分树搜索
行业在讨论 AI for Science 时,往往容易陷入两极化的叙事,要么期待 AI 如爱因斯坦般独立发现物理定律,要么退化成让聊天模型代写文献综述。ERA 揭示了实用性更强的第三种范式——把繁重的经验代码调优退行为程序搜索。
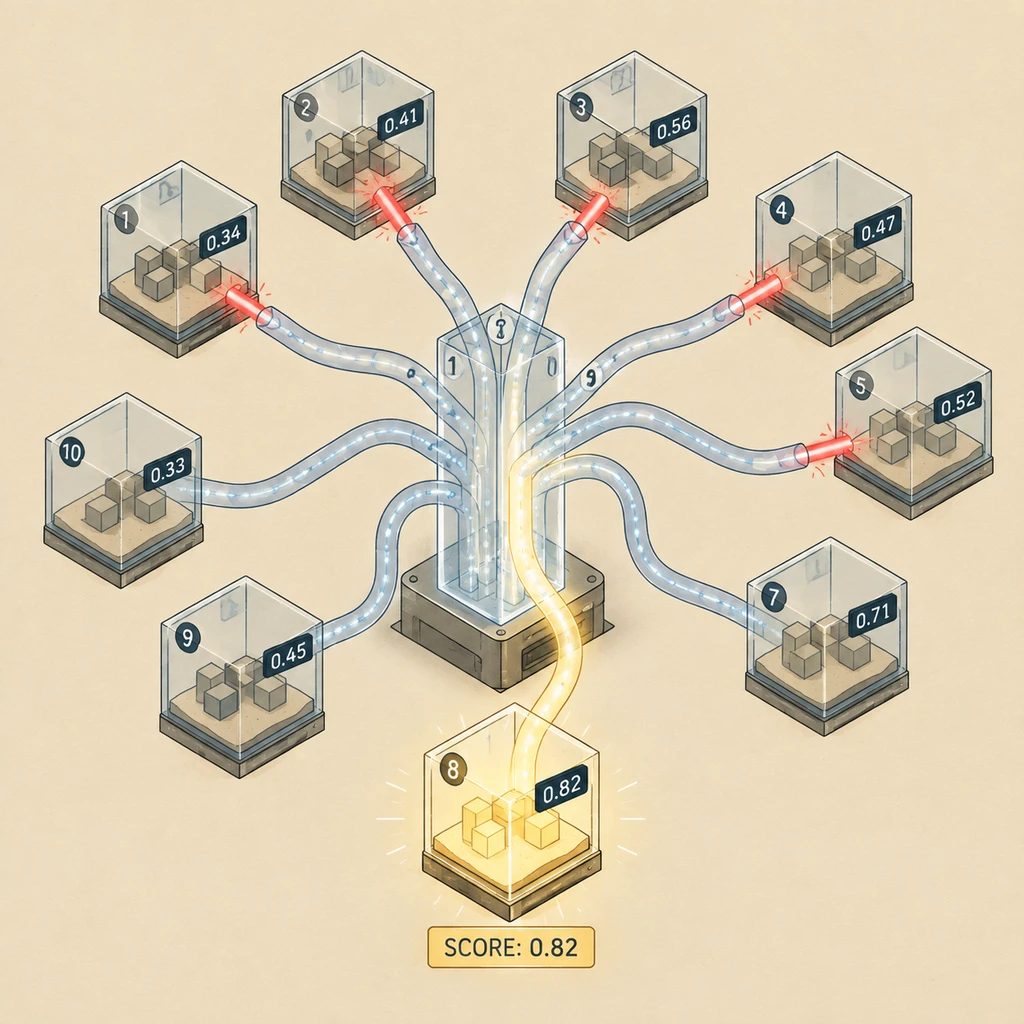
它的底层逻辑脱胎于 Google 内部的自动化 Kaggle 竞赛经验。系统将实验记录保存在代码树上,利用 Flat UCB / PUCT 树搜索策略评估最具潜力的分支。Gemini 每次不是凭空写论文,而是针对最有希望的代码变异出大约十个新版本,交由沙盒执行并回传客观分数。
消融实验呈现的一个技术细节显示,主实验基于 Gemini 2.5 Flash 运行,而当团队将核心生成引擎换成更昂贵、常识推理更强的 Gemini 2.5 Pro 时,系统整体得分仅产生微弱提升。这打破了单纯依赖大模型参数的预期,表明在紧凑的代码探索闭环里,树搜索策略与沙盒执行反馈才是决定性力量,纯粹堆砌模型参数带不来质变。
战绩清单:专家基线被批量攻破
一旦目标函数定义完成,机器在经验空间里的穷举速度便迅速拉开了与人类研究员的距离。Google 在官方通告中确认,该框架支撑了 8 篇应用学术手稿的诞生,并在 6 项严苛的科学基准问题上拿出了出色的成绩。
在单细胞 RNA 测序批次整合基准 OpenProblems v2 中,ERA 自动找出了 40 种超越顶尖专家方案的新方法,最优代码较公开顶尖方法综合得分提升约 14%。在面对 COVID-19 Forecast Hub 流行病预测时,它独立生成了 14 个性能超越美国 CDC 官方集成模型的预测方案。
在遥感密集标注分割基准中,ERA 得分最高的前三个方案 mIoU 突破 0.80,微弱压过已知 SOTA 水平;在时序预测基准 GIFT-Eval 上,它构建的统一系统交出了 0.734 的 MASE 成绩。
斑马鱼全脑神经元活动基准 ZAPBench 里,它同时驱动预测了超过 70,000 个神经元的信号。即使退回到纯软件竞技场,在 16 项 Kaggle Playground 竞赛测试中,ERA 的平均百分位排名同样压制了单次调用与 1000 次独立采样的暴力解法。
在 Platt 团队主导的商用飞机尾迹云试验中,这套方法论甚至促成了物理落地。结合机器学习规划航线高度后,干预组观测到的尾迹云较对照组减少了 63.6%。
指标即猎场:古德哈特定律与两派分流
效果虽然显著,但背后的风险同样清晰。ERA 本质上是一个超大搜索空间的经验优化器,它给出的方案属于预测性模型而非因果解释模型。
任何指标一旦成为搜寻目标,它便不再是一个好指标。
在早期的尾迹检测竞赛中,获得第一名的队伍之所以胜出,是因为选手抓住了标注中“以像素中心还是像素角落为原点”的半像素微小偏差。这种在打分沙盒里拿高分的技巧,对消除温室效应毫无助益。系统极易陷入古德哈特定律支配下的奖励黑客攻击(Reward Hacking)。
这也划清了当下科研 AI 的两条分流路径。
学界此前对部分全自动 AI 科学家系统颇有微词,痛斥其用大模型批量拼凑平庸假说、炮制虚假图表,制造学术噪音。Google 团队选择了一条更克制但也更重的路径,放弃让模型大发议论,把它按在可执行代码与确定测试集的方寸之地里做工。
- 结论.ERA 证明了现阶段科研智能的本质依然是工程学工具。它替科学家接管了繁复的管道搭建与经验调参,但它无法代替人类决定“向何处打分”。
- 风险.若打分函数存在隐蔽的分布泄露或定义缺陷,这种自动化系统会以极高的算力效率把漏洞刷到满分,反向制造精密的经验伪科学。
两千年前管子讲“善假于物者,因人之情”,如今面对算法工具,理应存有一份清醒。把脏活交给树搜索与轻量模型,把对物理本质与客观因果的审视牢牢攥在手里,这或许是科研界在 AI 算力大潮下最体面的分工。