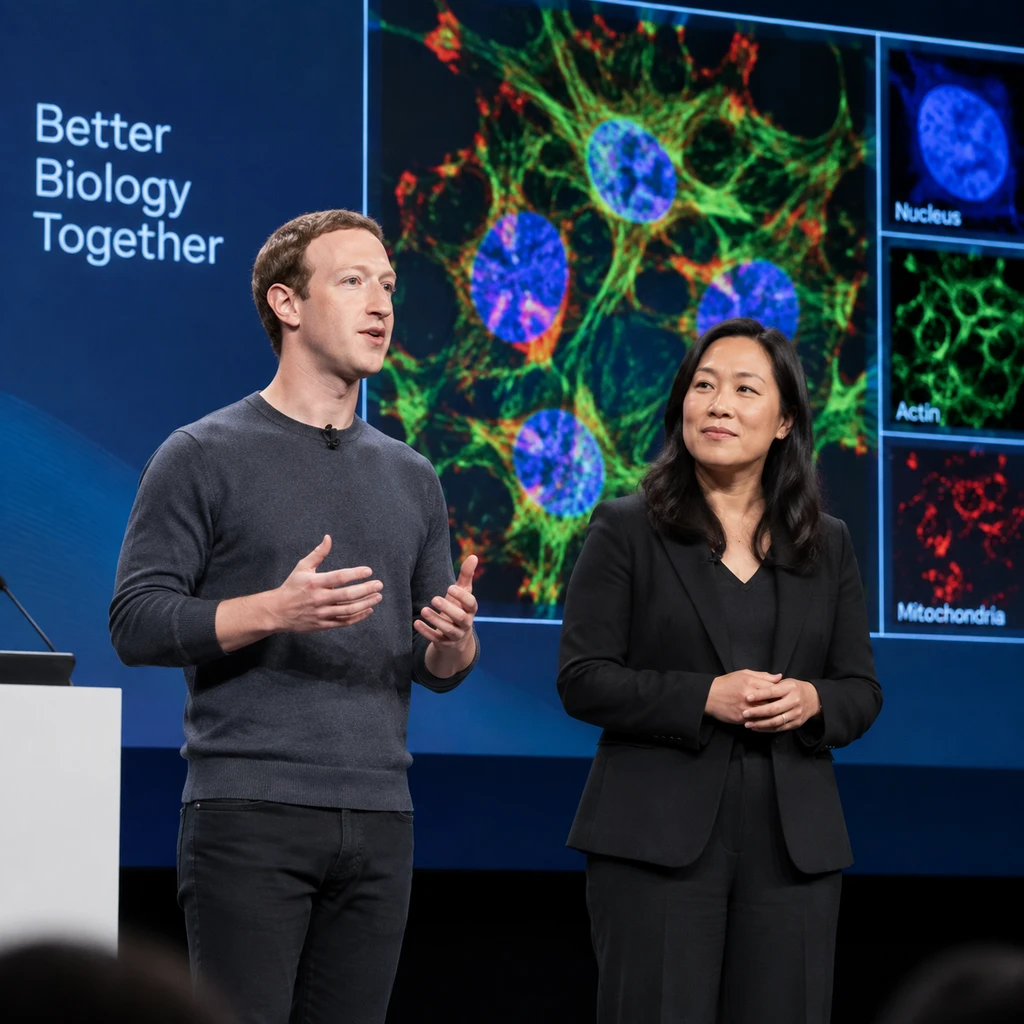
科技巨头在公共科研领域的罕见结盟,往往不是因为握手言和,而是共同撞上了单打独斗无法突破的物理壁垒。2026年10月7日,Google DeepMind、Isomorphic Labs与Meta共同宣布,向陈-扎克伯格生物中心(CZ Biohub)的虚拟生物学倡议提供3亿美元联合资助。官方并未拆分透露各方的具体出资比例,但这项动作迅速被外界简化为硅谷新贵之间的资金互换。
真实图景远比富豪间的慈善互动宏大且复杂。这笔商业出资并非孤立行为,而是嵌入在一项总价值约18亿美元的庞大国家级科研版图中。整个联盟同时拉动了美国能源部(DOE)承诺五年内投入超过5亿美元的计算与实验资源,以及美国国家卫生研究院(NIH)调动的逾5亿美元历史样本与数据库。这意味着,大模型在生物学领域的竞争重心,已经从单点算法的比拼,全面转向高通量实验数据生产的基建合围。
扎克伯格的非营利机构何以成为汇流中心
陈·扎克伯格倡议(CZI)与Biohub设立于2016年,由扎克伯格和普莉希拉·陈出资,原本是一个独立于Meta商业主体的非营利科研组织。Biohub在过去两年完成了关键的团队与算力重组。2025年11月,机构吸纳了前Meta FAIR蛋白质语言模型核心成员及EvolutionaryScale团队,由Alex Rives出任首席科学家,并计划到2028年扩充至10,000张GPU的计算集群。
在这一轮扩张前,Biohub自身已在2026年4月29日立项承诺5年内投入5亿美元推进虚拟生物学倡议,其中4亿美元专款用于内部成像、测序、工程平台与算力构建,其余1亿美元用于外部合作开发。与专注单一药物管线研发的商业TechBio公司不同,Biohub更像是一座为学术界与产业界通吃的数据生产工厂。该机构目前已启动十亿细胞计划(Billion Cells Project),相继发布了rBio、VariantFormer、TranscriptFormer,以及与英伟达联合开发的cz-benchmarks等工具链,意在确立底层细胞表征的行业评测标准。
正因如此,Google DeepMind与Isomorphic Labs才会甘愿将支票开给竞争对手创立的非营利组织。通用人工智能在文本与图像领域的 Scaling Law 已逼近互联网存量数据的天花板,但在细胞生物学领域,可用且标准化的实验扰动数据极度匮乏。巨头们各建一套湿实验室的边际成本过高,合力托举一个拥有国家级资源支持的中立实验平台,成了分摊重资产基建风险的最优解。
虚拟细胞不是语言模型,生命系统难容纯统计模拟
所谓虚拟细胞,目标是训练出能够预测细胞在药物分子、基因突变与病理状态下如何响应的AI模型,让科研人员能在计算机里先行模拟生物学实验。然而,从AlphaFold精准解析静态蛋白质三维结构,跨越到实时模拟活体细胞的动态系统,面临的完全是另一个维度的计算鸿沟。
学术界对全细胞模拟器的成熟周期估算跨度极大,从10年到100年不等。主流生物学家的疑虑集中于统计相关性与因果机制的割裂:单细胞测序获得的切片往往是细胞死亡瞬间的静态投影,无法直接反映活体微环境中的时空连续动力学。将语言模型中的词元自回归逻辑生搬硬套到基因表达上,很容易忽略细胞内生化反应的涌现特征。
目前大模型在未见生物样本上的分布外泛化能力依然脆弱。如果模型给出的预测只能在与训练集高度相似的细胞系中复现,药企研发就依然不敢跳过昂贵且耗时的体外筛选与动物实验。在相当长一段时期内,虚拟细胞更现实的定位不是取代湿实验,而是作为实验通量的粗筛漏斗。
- 提醒.虚拟细胞并非数字孪生软件的一步到位,其短期价值仅限于压低无效试错概率,无法免除临床前验证的漫长周期。
开源面具下的数据禁运与生态割据
在这场被包装为造福全人类的开放科学叙事背后,商业利益的防御性边界十分清晰。
虽然Biohub对外标榜构建的是全球共享公共资源,但出资的商业实体对部分高价值多组学数据集享有长达一年的初始独家访问期。在算力与模型架构日趋同质化的当下,提前一年拿到大规模结构化空间扰动数据,足以让Google DeepMind与Meta在下游新药靶点发现或自研基础模型迭代上拉开代际差距。这种将公共资助与企业特权绑定的安排,正在引发科研界对数字寡头借道非营利基建搞数据圈地的隐忧。
决定生物大模型生死的不是参数堆叠,而是谁能在商业禁运期内垄断真实实验的反馈回路。
与此同时,硅谷的阵营分化也在加剧。微软研究院选择在2026年9月推出生物世界模型Project Quine,并未加入Biohub联盟,形成了平行的技术对抗;而Arc Institute等学术力量则坚持以纯学术挑战赛对抗商业化侵蚀。
- 结论.对于大多数生物医药初创团队与药企实验室而言,不必为巨头的数字狂欢交出自己的私有管线,紧盯2026至2027年首批公开扰动数据集的开放范围与复现指标,才是评估是否接入这套公共基建的务实尺度。